Langfuse Cloud에서 내보내기
이 가이드에 따라 Langfuse Cloud에서 예약 내보내기에 사용할 Blob Storage 통합을 구성하십시오. 트레이스 데이터(trace data)를 객체 스토리지로 내보내는 작업은 최소20 minutes 간격으로 예약하거나 hourly, daily, weekly 주기로 예약할 수 있습니다. 기본적으로 각 내보내기에는 트레이스 속성으로 보강된 observations와 scores가 포함됩니다.
내보낸 파일 구성
Langfuse Cloud의 Blob Storage 통합은 대상 버킷 또는 스토리지 컨테이너에 다음과 같은 디렉터리 구조로 데이터를 기록합니다.ClickHouse Cloud로 가져오기
Langfuse Cloud에서 Blob Storage 통합을 구성하면 트레이스 데이터가 일정에 따라 대상 버킷 또는 스토리지 컨테이너로 내보내집니다. 이 데이터를 ClickHouse Cloud로 가져오려면 ClickPipes와 ClickPipes에서 제공하는 관리형 객체 스토리지 커넥터를 사용하면 됩니다.| 데이터 소스 | 세부 정보 |
|---|---|
 Amazon S3 및 S3 호환 객체 스토리지 | S3 ClickPipes를 사용하여 통합합니다. |
 Google Cloud Storage | GCS ClickPipes를 사용하여 통합합니다. |
 Azure Blob Storage | ABS ClickPipes를 사용하여 통합합니다. |
ClickPipe 생성
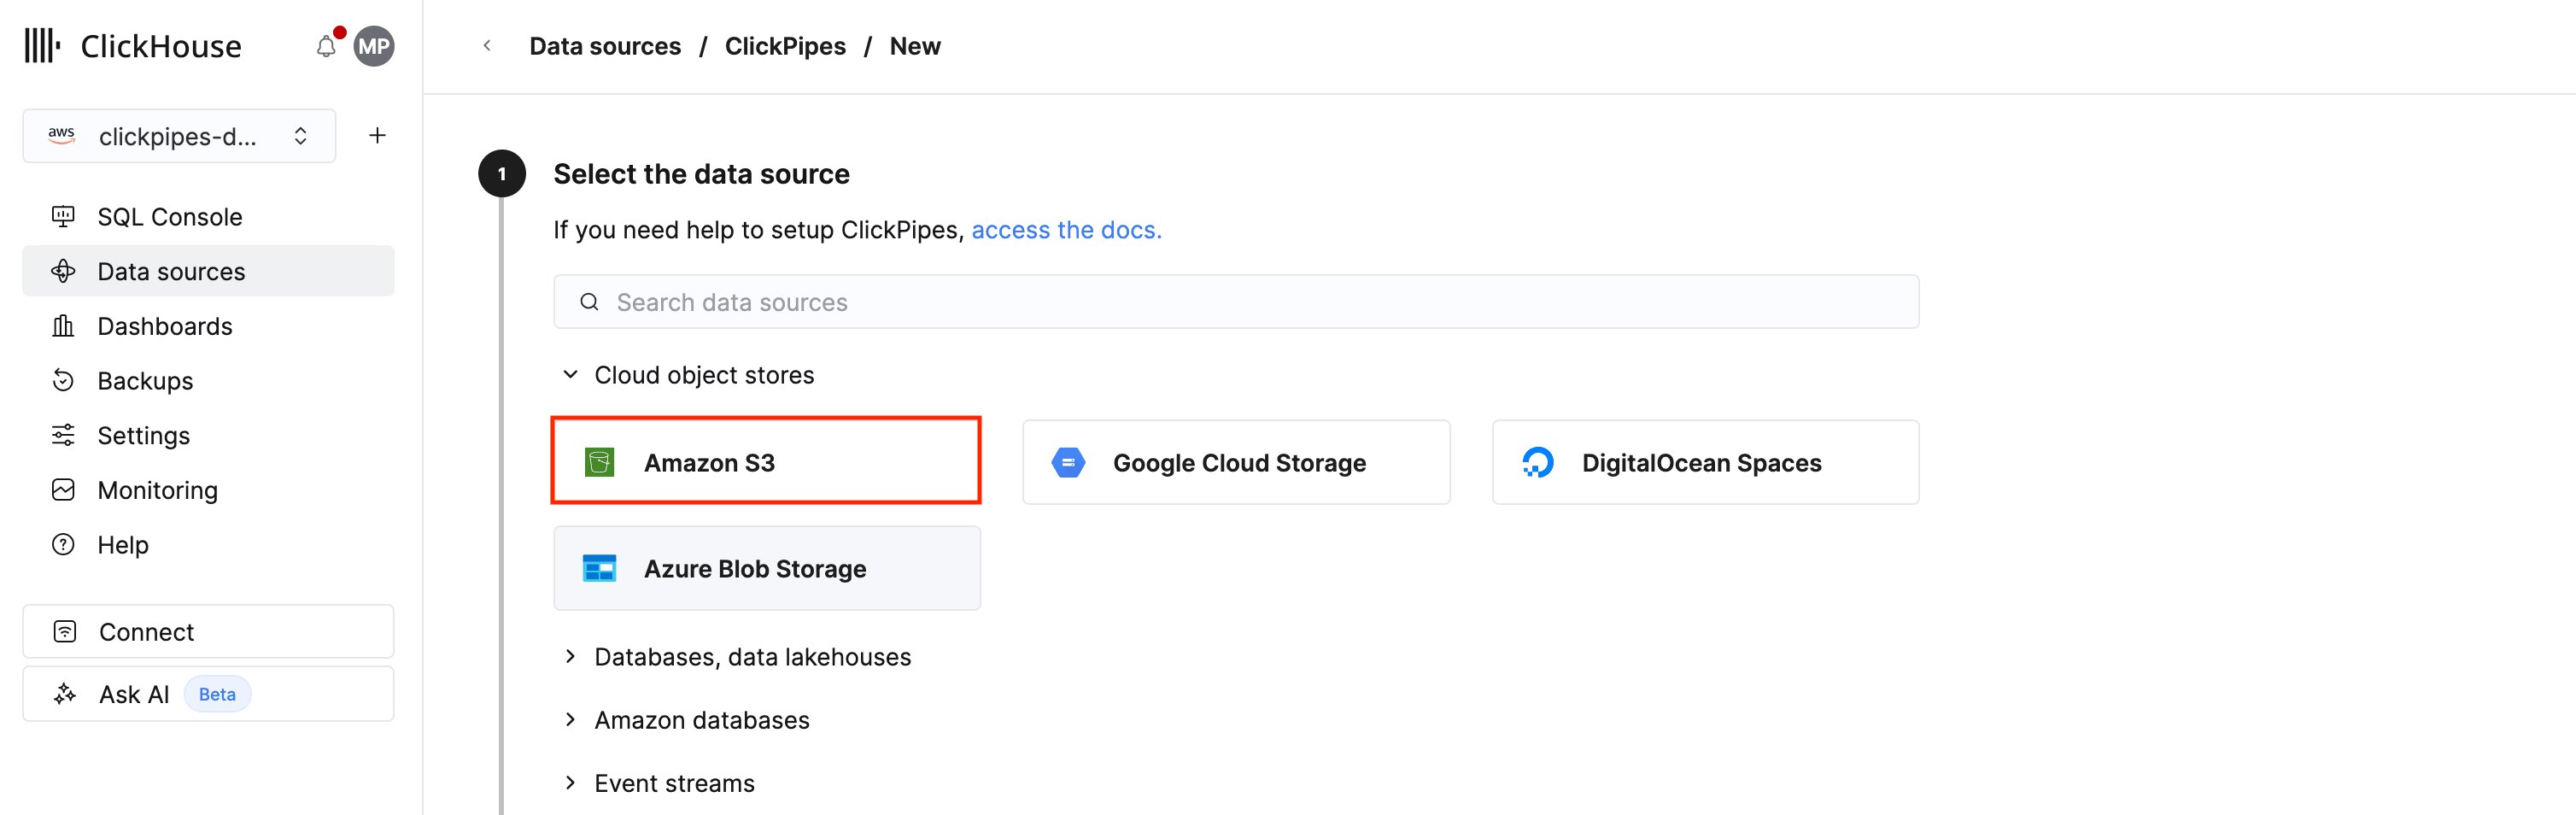
이 예시에서는 S3 ClickPipe를 사용하여 Langfuse Cloud의 예약 내보내기 데이터가 저장되는 S3 버킷에서 데이터를 가져옵니다. 이 방법은 모든 객체 스토리지 내보내기 대상에 기본 템플릿으로 적용할 수 있습니다. 데이터 소스별 안내는 ClickPipes 문서를 참조하십시오.1
데이터 소스를 선택하세요
1. ClickHouse Cloud의 기본 탐색 메뉴에서 Data sources를 선택한 다음 Create ClickPipe를 클릭하십시오.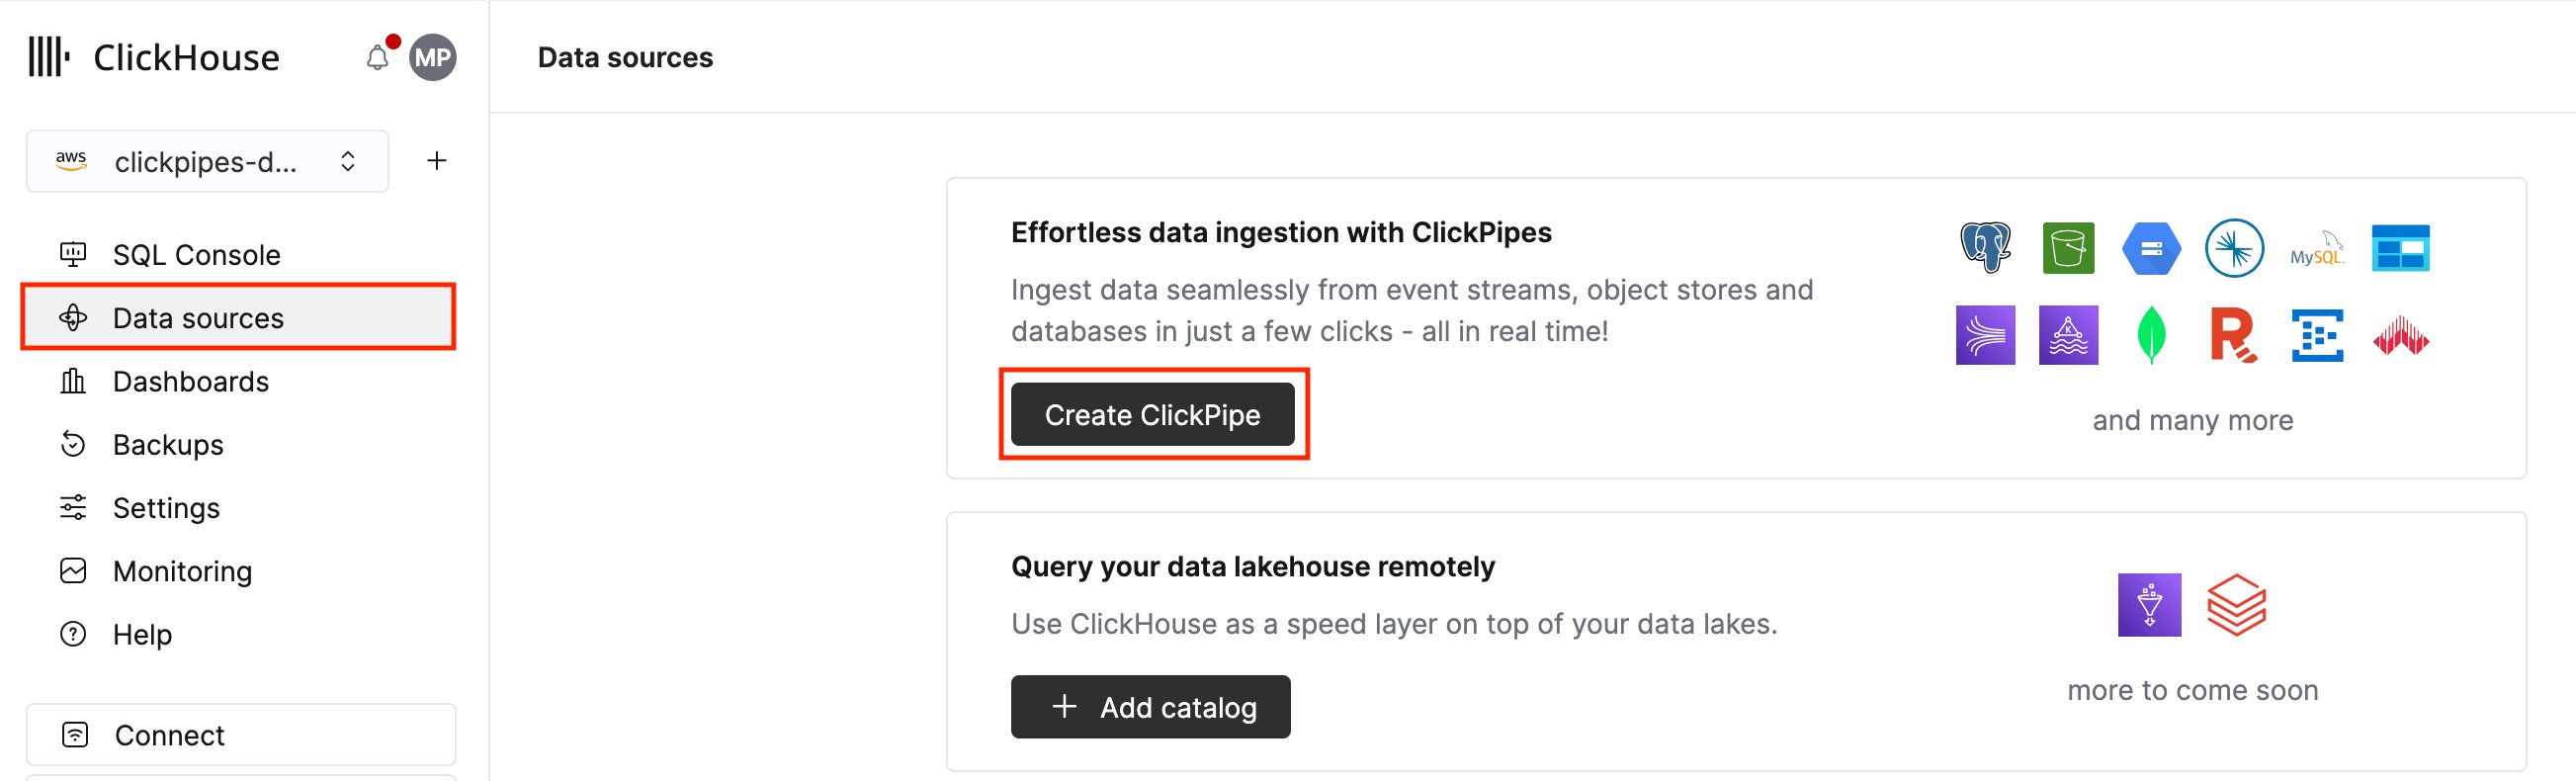
2
연결 설정하기
1. Langfuse Cloud 내보내기 파일을 수신하는 버킷에 ClickPipes가 연결하고 인증하는 데 필요한 세부 정보를 입력하세요.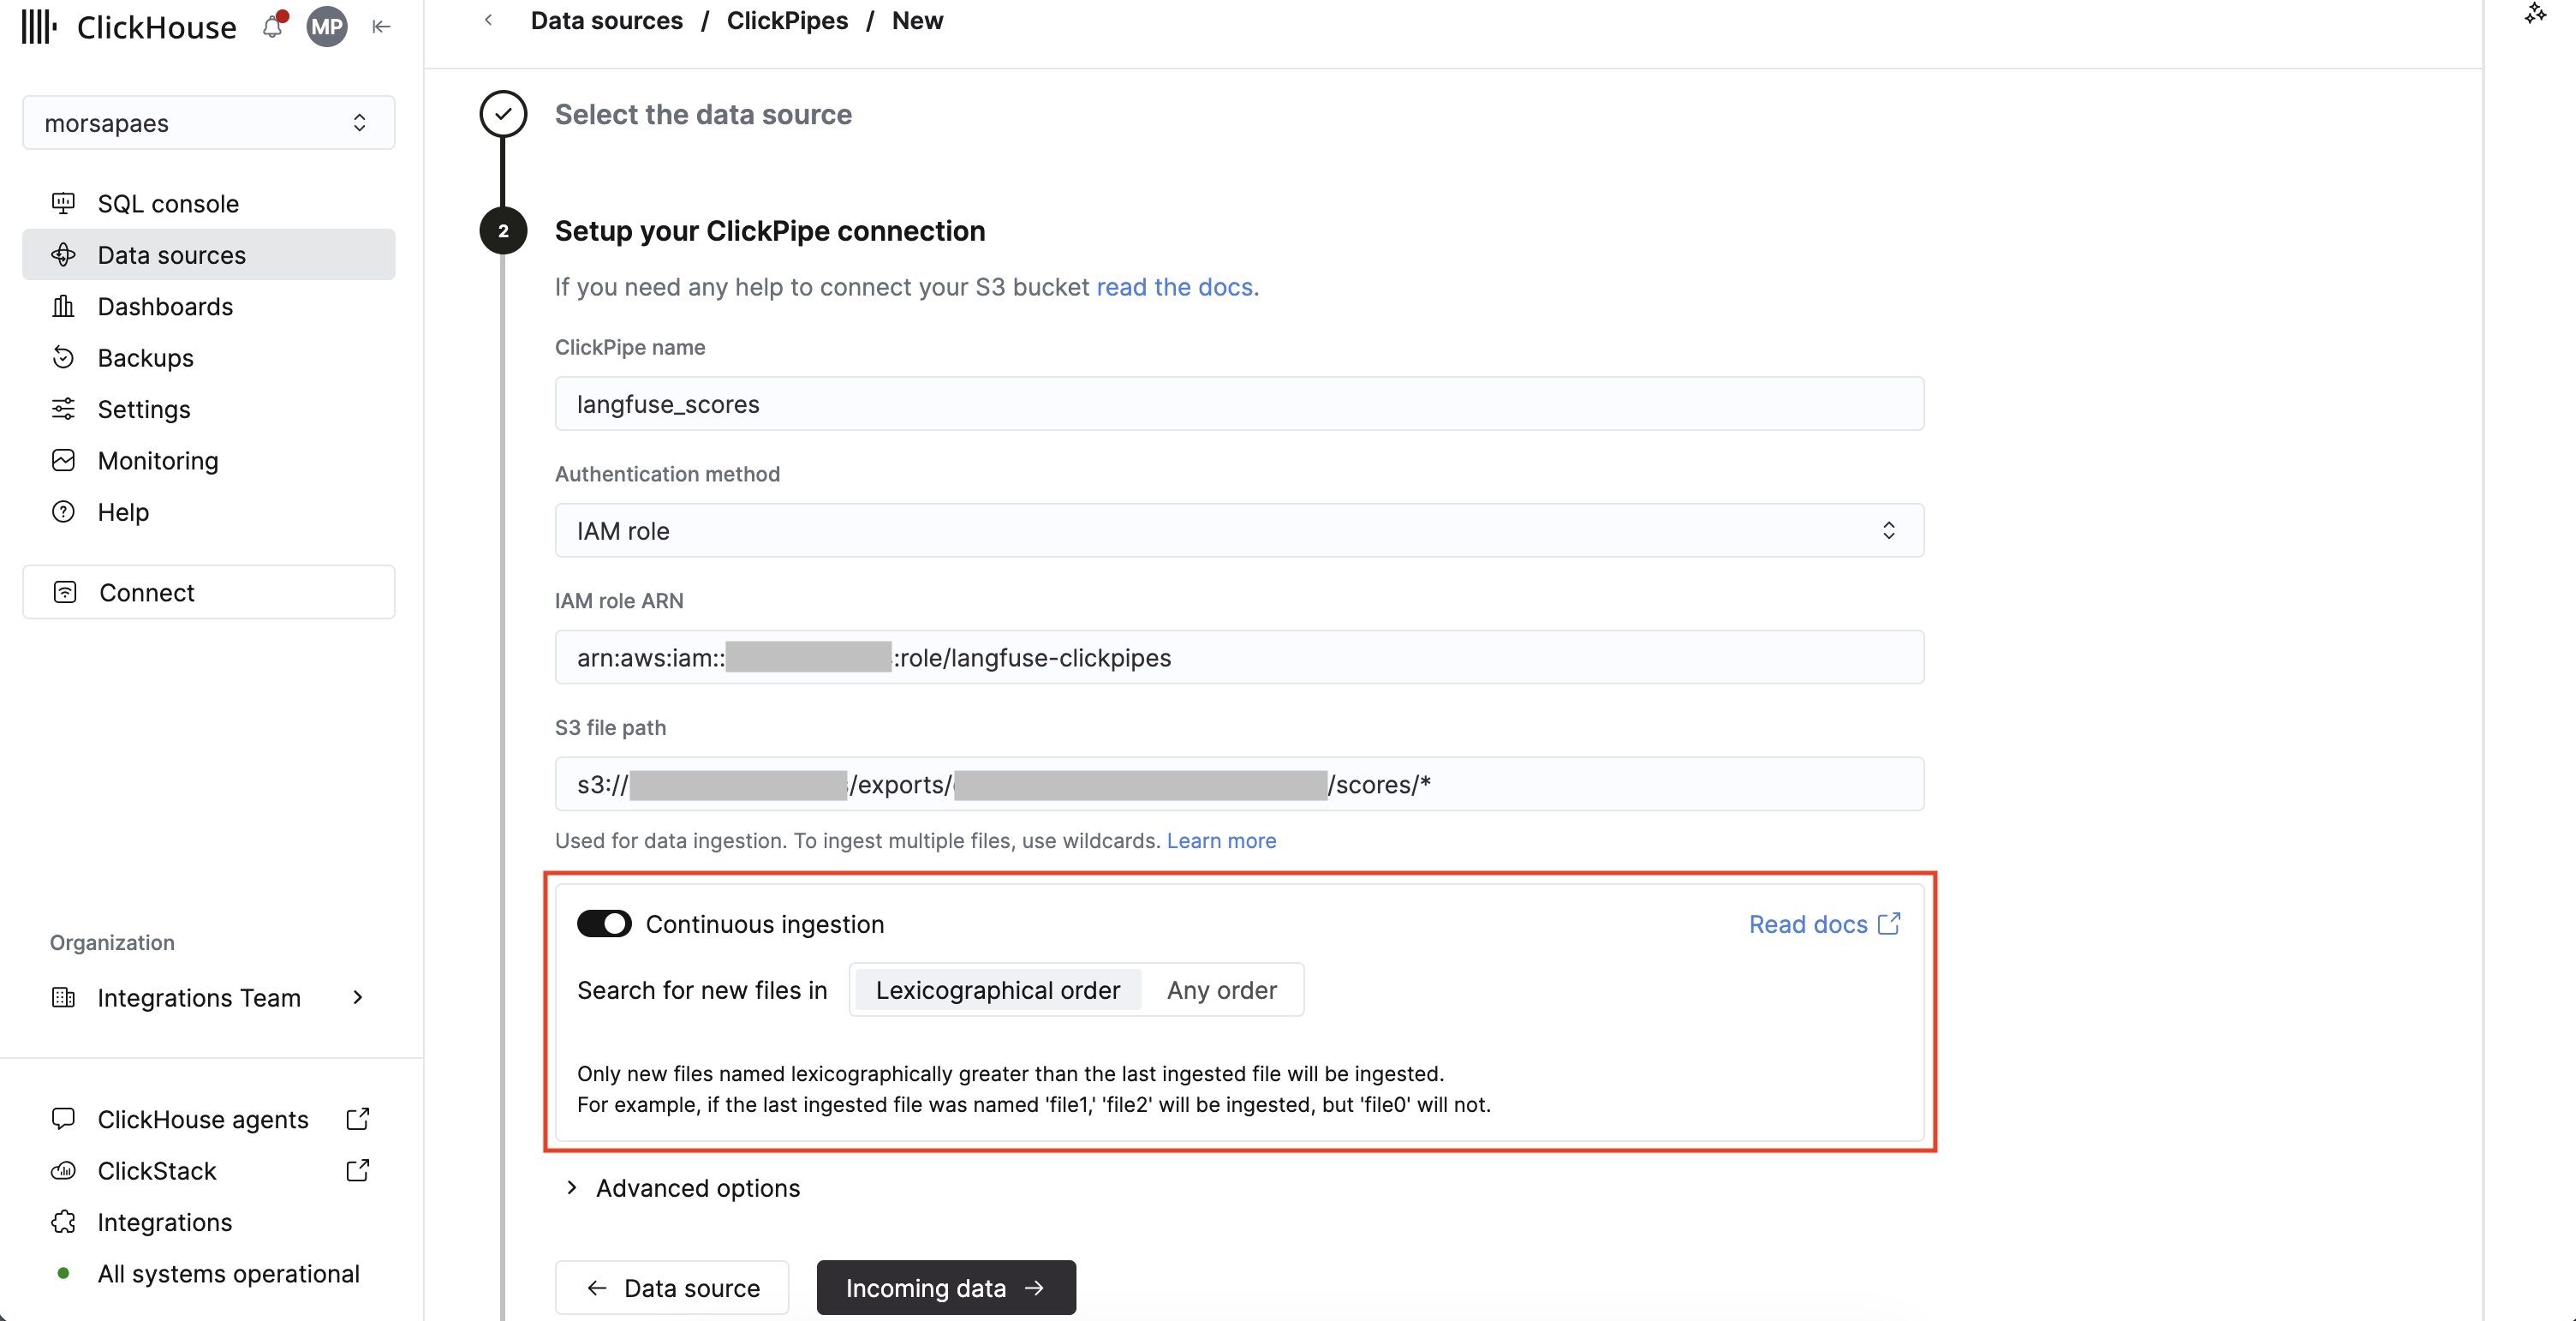
-
인증 방법: S3 ClickPipe는 IAM 자격 증명(
Credentials)과 IAM 역할 기반 인증(IAM role)을 지원합니다. ClickPipes에는 버킷에 대한 읽기 액세스 권한만 있으면 됩니다. 인증 및 권한에 대한 안내는 참고 문서를 참조하십시오. -
S3 파일 경로: ClickPipe가 하위 디렉터리를 가리키도록 지정하고,
*와일드카드를 사용하여 내보낸 파일 전체와 일치하도록 설정하십시오. 하위 디렉터리마다 내보낸 파일의 스키마가 서로 다르므로, 하위 디렉터리별로 ClickPipe를 하나씩 반드시 생성해야 합니다.중첩된 프리픽스에 걸쳐 파일을 일치시키는 방법 등 지원되는 패턴에 대한 안내는 참고 문서를 참조하십시오.
3
수신 데이터 검사
1. ClickPipes가 버킷에 연결하여 지정된 경로의 파일 목록을 조회하고 파일 포맷을 추론합니다. 이 예시에서는 Langfuse Cloud의 기본 내보내기 파일 포맷(Parquet)을 사용했습니다.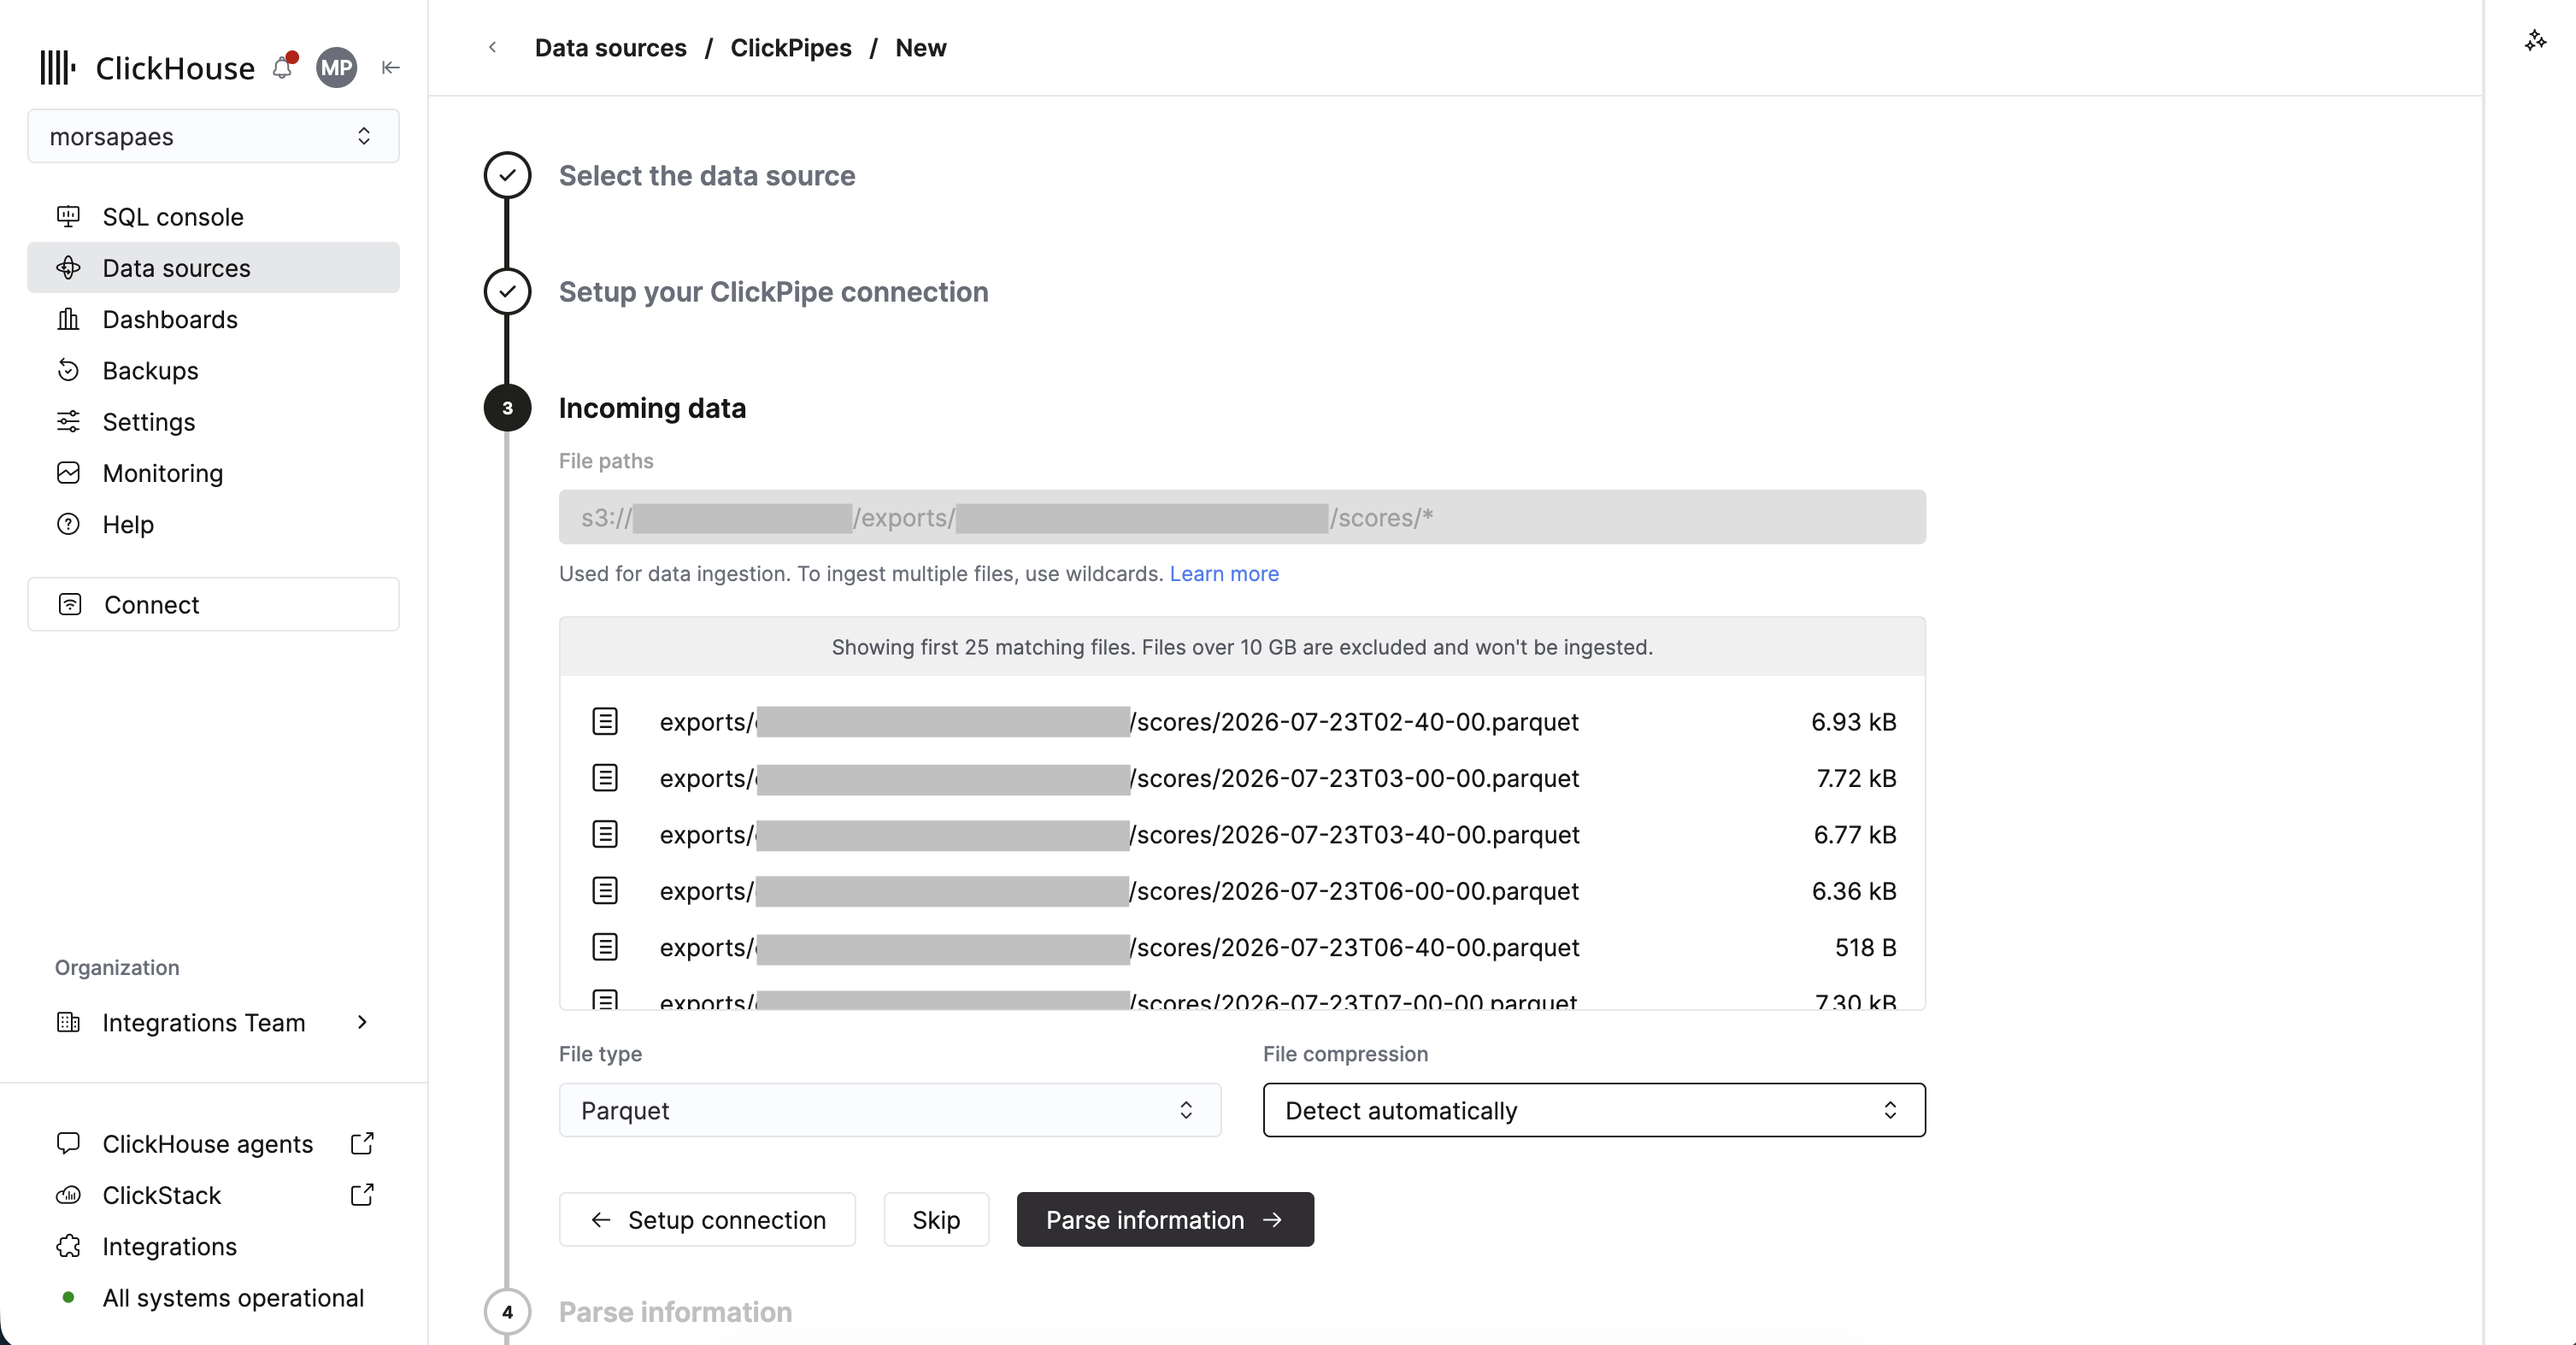
4
대상을 구성하세요
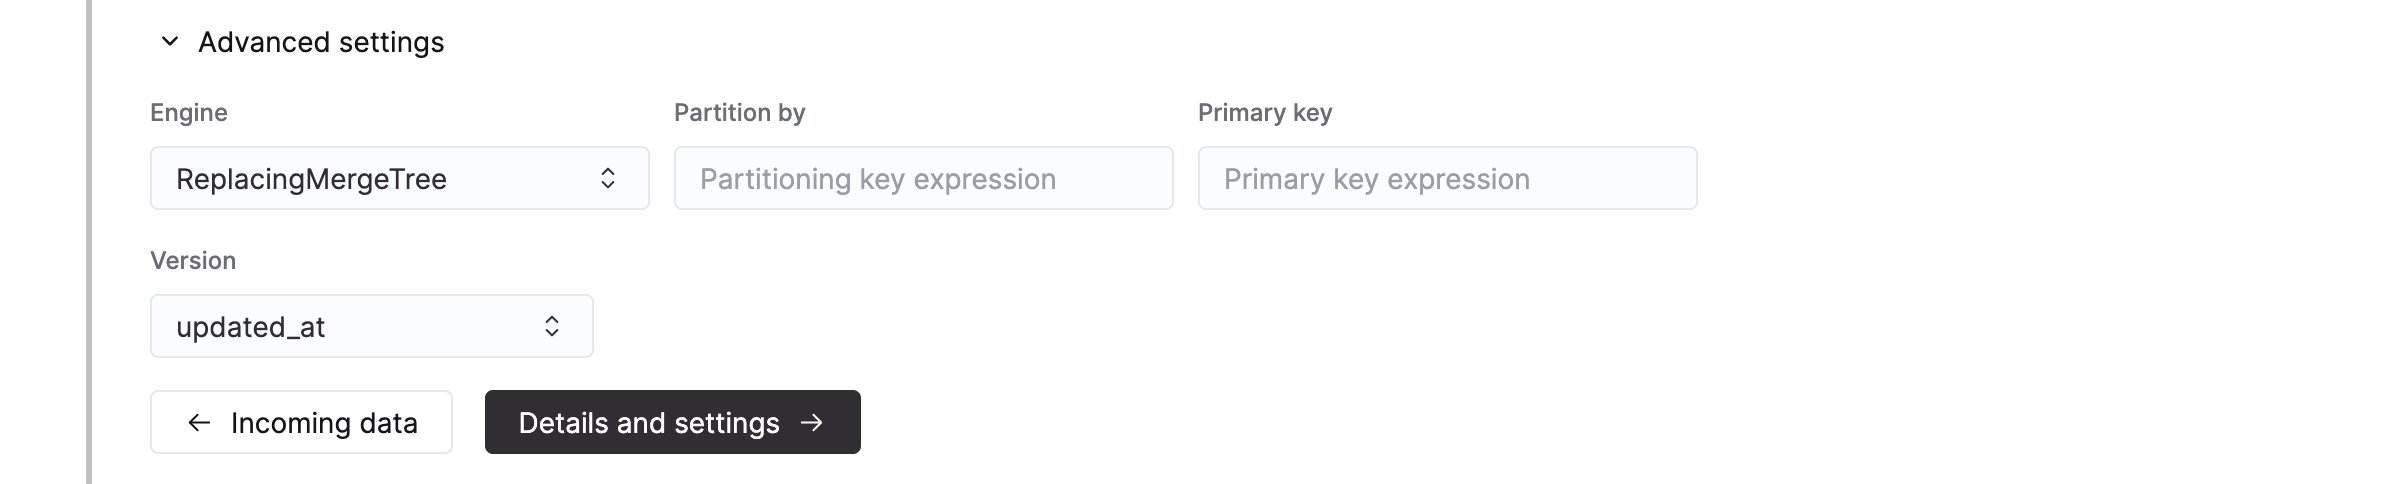
1. 이 단계에서는 추론된 스키마를 검토하고, 데이터 타입 매핑 조정, 정렬 키 정의, 테이블 엔진 선택 등 target table의 구성을 원하는 대로 지정할 수 있습니다.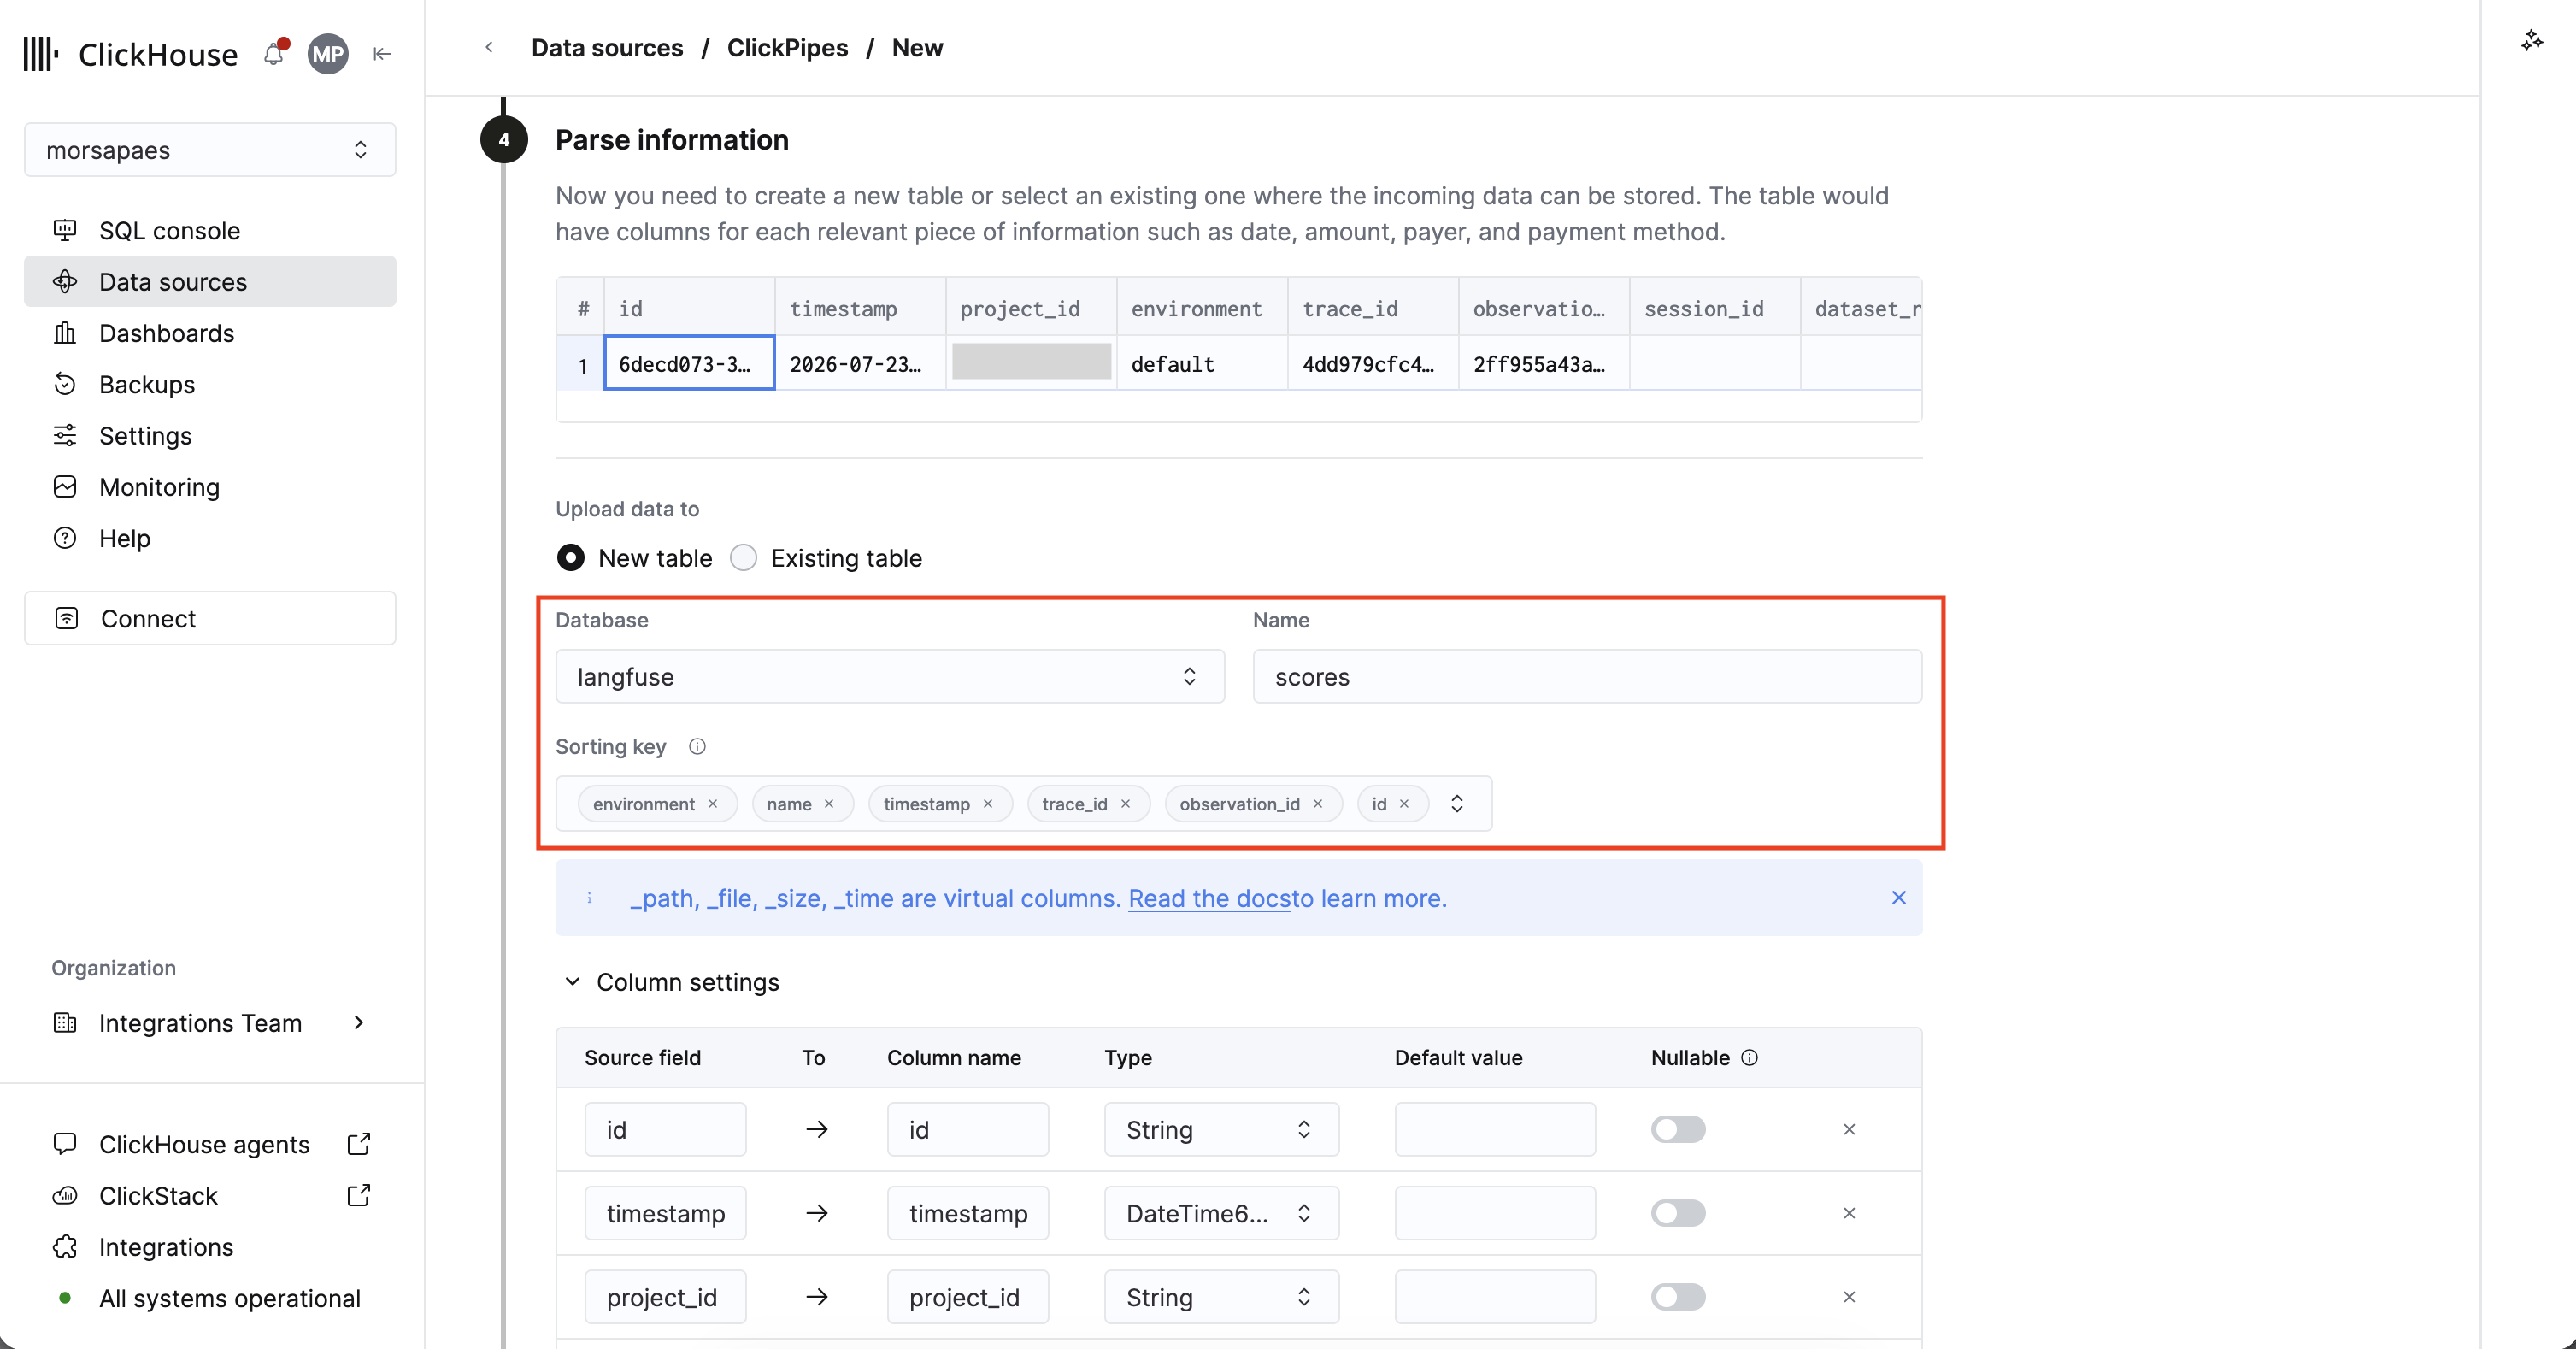
-
Database 및 Name: Langfuse 데이터 전용 데이터베이스(예:
langfuse)와 알아보기 쉬운 대상 테이블 이름(예:scores)을 지정합니다. ClickPipes는 이름 충돌을 방지하기 위해 기본적으로default.s3-<uuid>를 사용합니다. -
Sorting key: 대상 테이블의 순서 지정 키로, ClickHouse가 데이터를 디스크에 저장하는 방식을 결정합니다. 최적의 성능을 얻으려면 정렬 키를 데이터 액세스 패턴에 맞춰야 쿼리에서 읽지 않고 건너뛸 수 있는 데이터를 최대화할 수 있습니다.
이 키는
ReplacingMergeTree테이블에서 중복 제거에도 사용되므로, 컬럼 조합으로 레코드를 고유하게 식별할 수 있어야 합니다. 여러 Langfuse 프로젝트를 하나의 테이블에 적재하는 경우 정렬 키 맨 앞에project_id를 추가하십시오. 정렬 키 선택 방법은 참고 문서를 참조하십시오. -
Partition by: 오래된 trace를 만료할 계획이 없다면 비워 두십시오. ClickHouse에서 파티셔닝은 쿼리 최적화가 아니라 데이터 관리를 위한 기능이며, 권장 정렬 키만으로도 시간 범위 쿼리를 충분히 걸러낼 수 있습니다. 보존 기간 관리가 필요하다면 시간 컬럼(
toYYYYMM(start_time),scores는toYYYYMM(timestamp))으로 파티셔닝하십시오. 이렇게 하면 한 달치 trace를DROP PARTITION작업 한 번으로 만료할 수 있습니다.
ReplacingMergeTree로 설정한 후 Version 컬럼으로 updated_at을 지정하십시오.uniq(), max(), min()), ReplacingMergeTree를 대상 엔진으로 사용하여 다운스트림 데이터 모델에서 반드시 중복 제거를 처리해야 합니다.ReplacingMergeTree로 중복 제거하기이 테이블 엔진은 백그라운드 머지 과정에서 중복을 제거합니다. 읽기 시점에 중복을 완전히 제거하려면(즉, merge-on-read 방식) 쿼리에 반드시
FINAL 수정자(또는 argMax() 방식의 집계)를 사용해야 합니다.5
권한 설정
ClickPipes는 대상 테이블에 데이터를 쓰기 위한 전용 사용자를 생성합니다. custom 역할 또는 사전 정의된 역할 중 하나를 선택하여 이 내부 사용자에게 부여하십시오.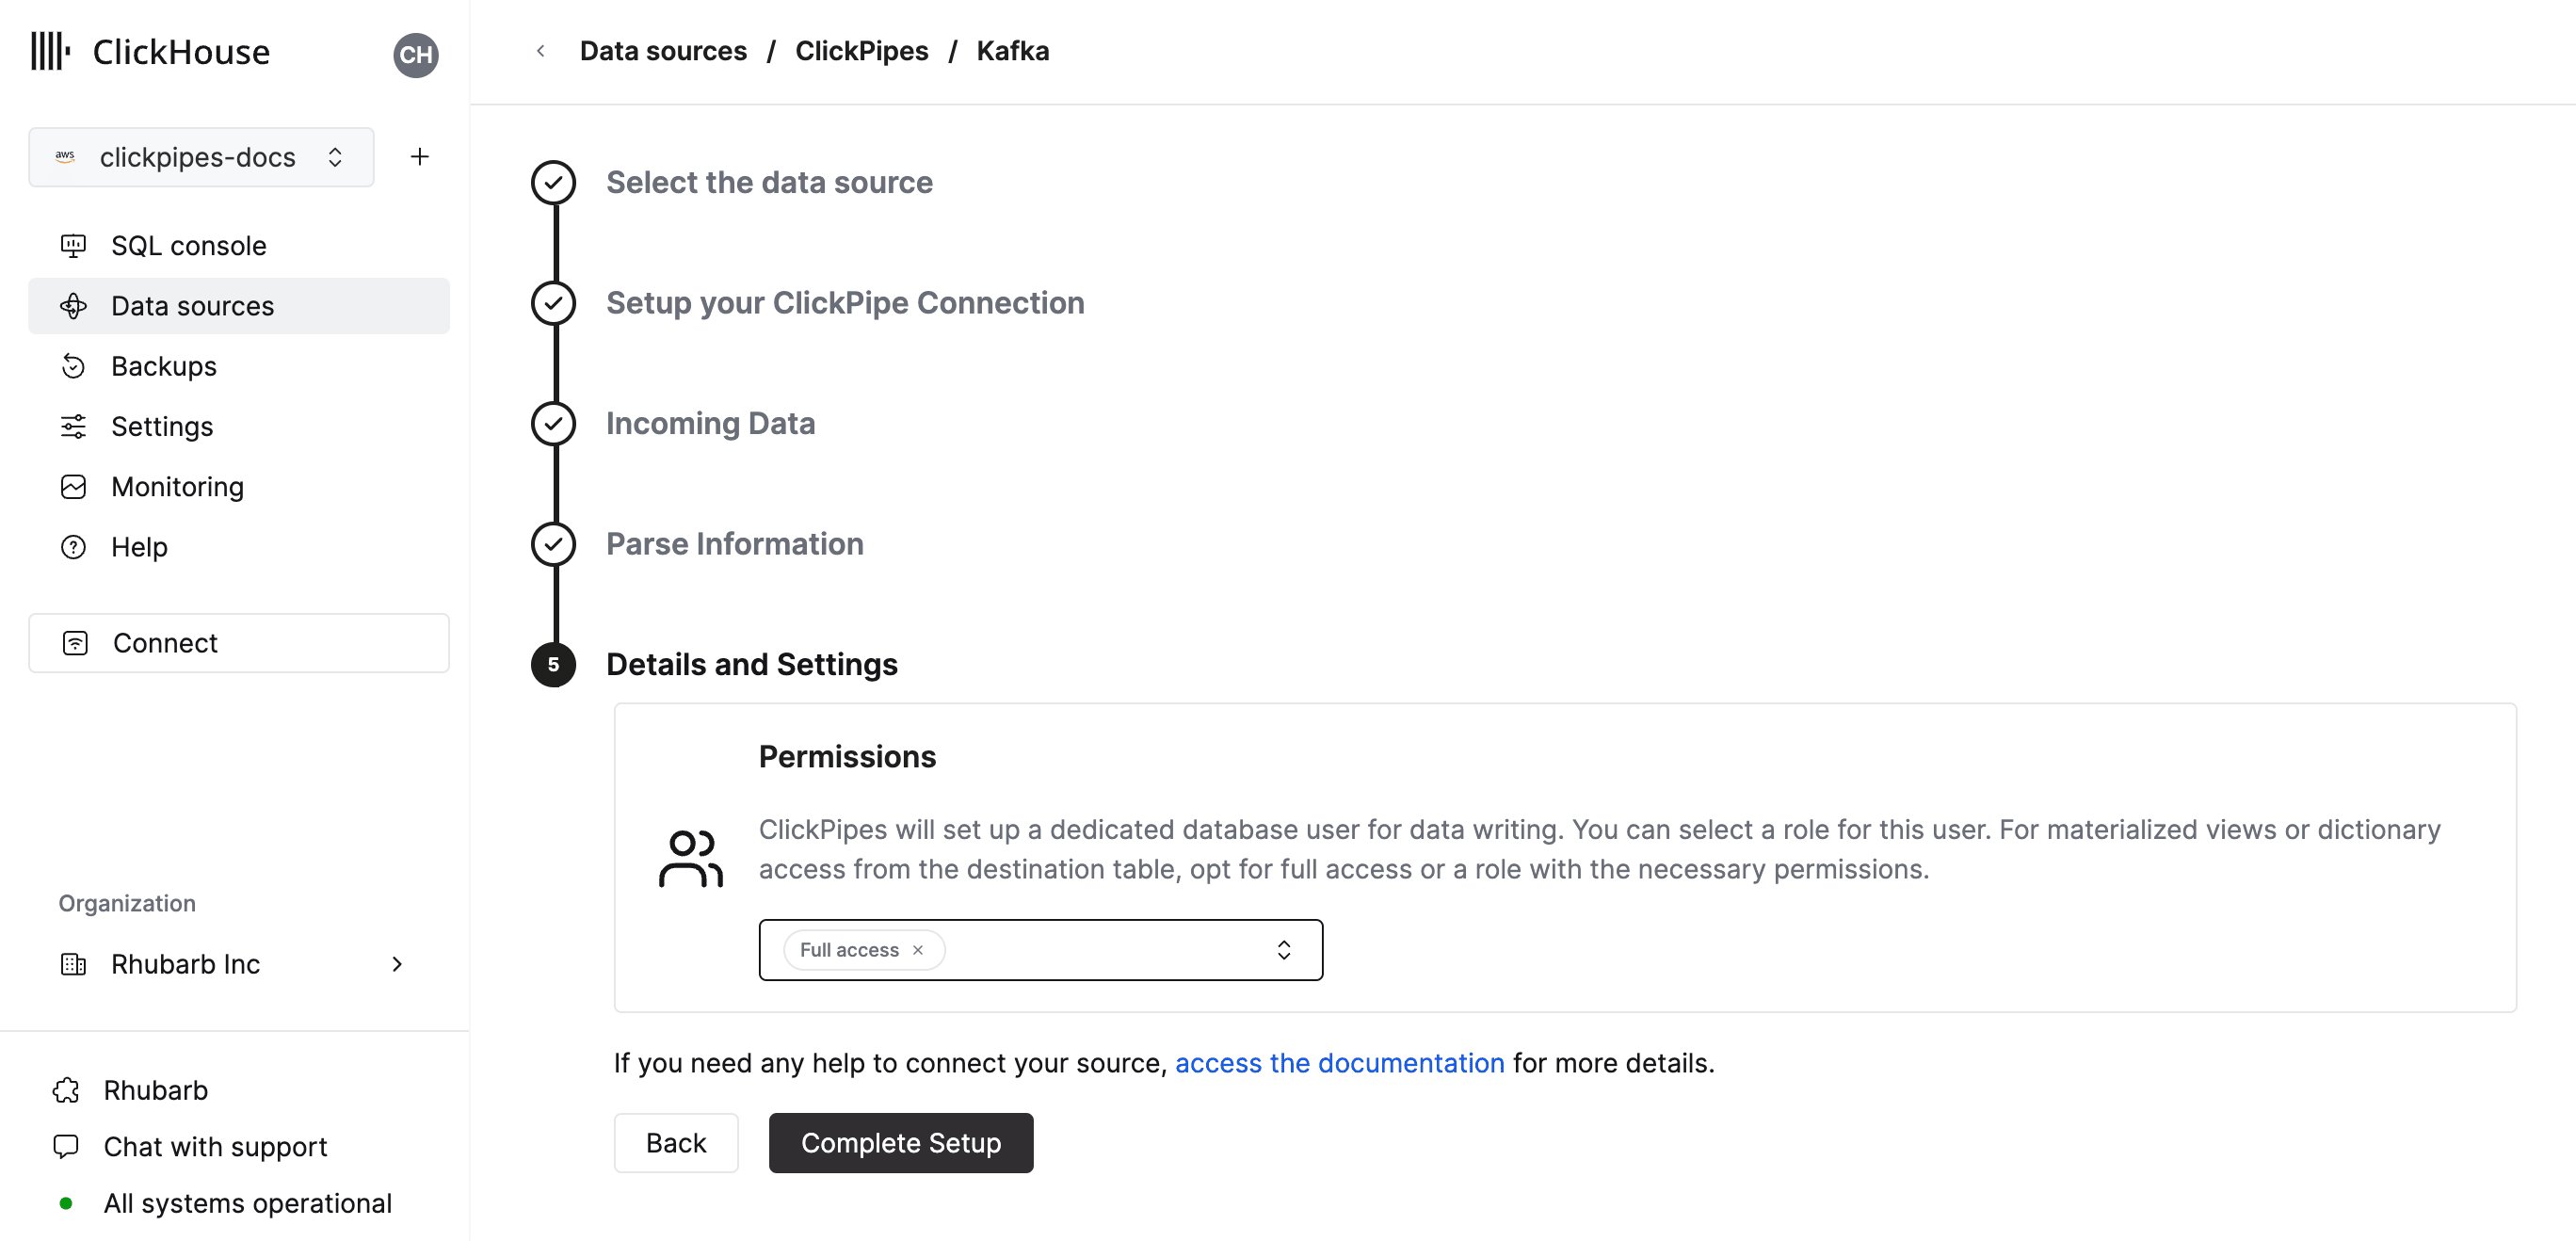
Full access: 클러스터 전체에 대한 액세스 권한을 가집니다. 대상 테이블에 materialized view 또는 딕셔너리를 함께 사용하는 경우 이 역할이 필요합니다.Only destination table: 대상 테이블에 대한INSERT권한만 가집니다.
6
설정 완료
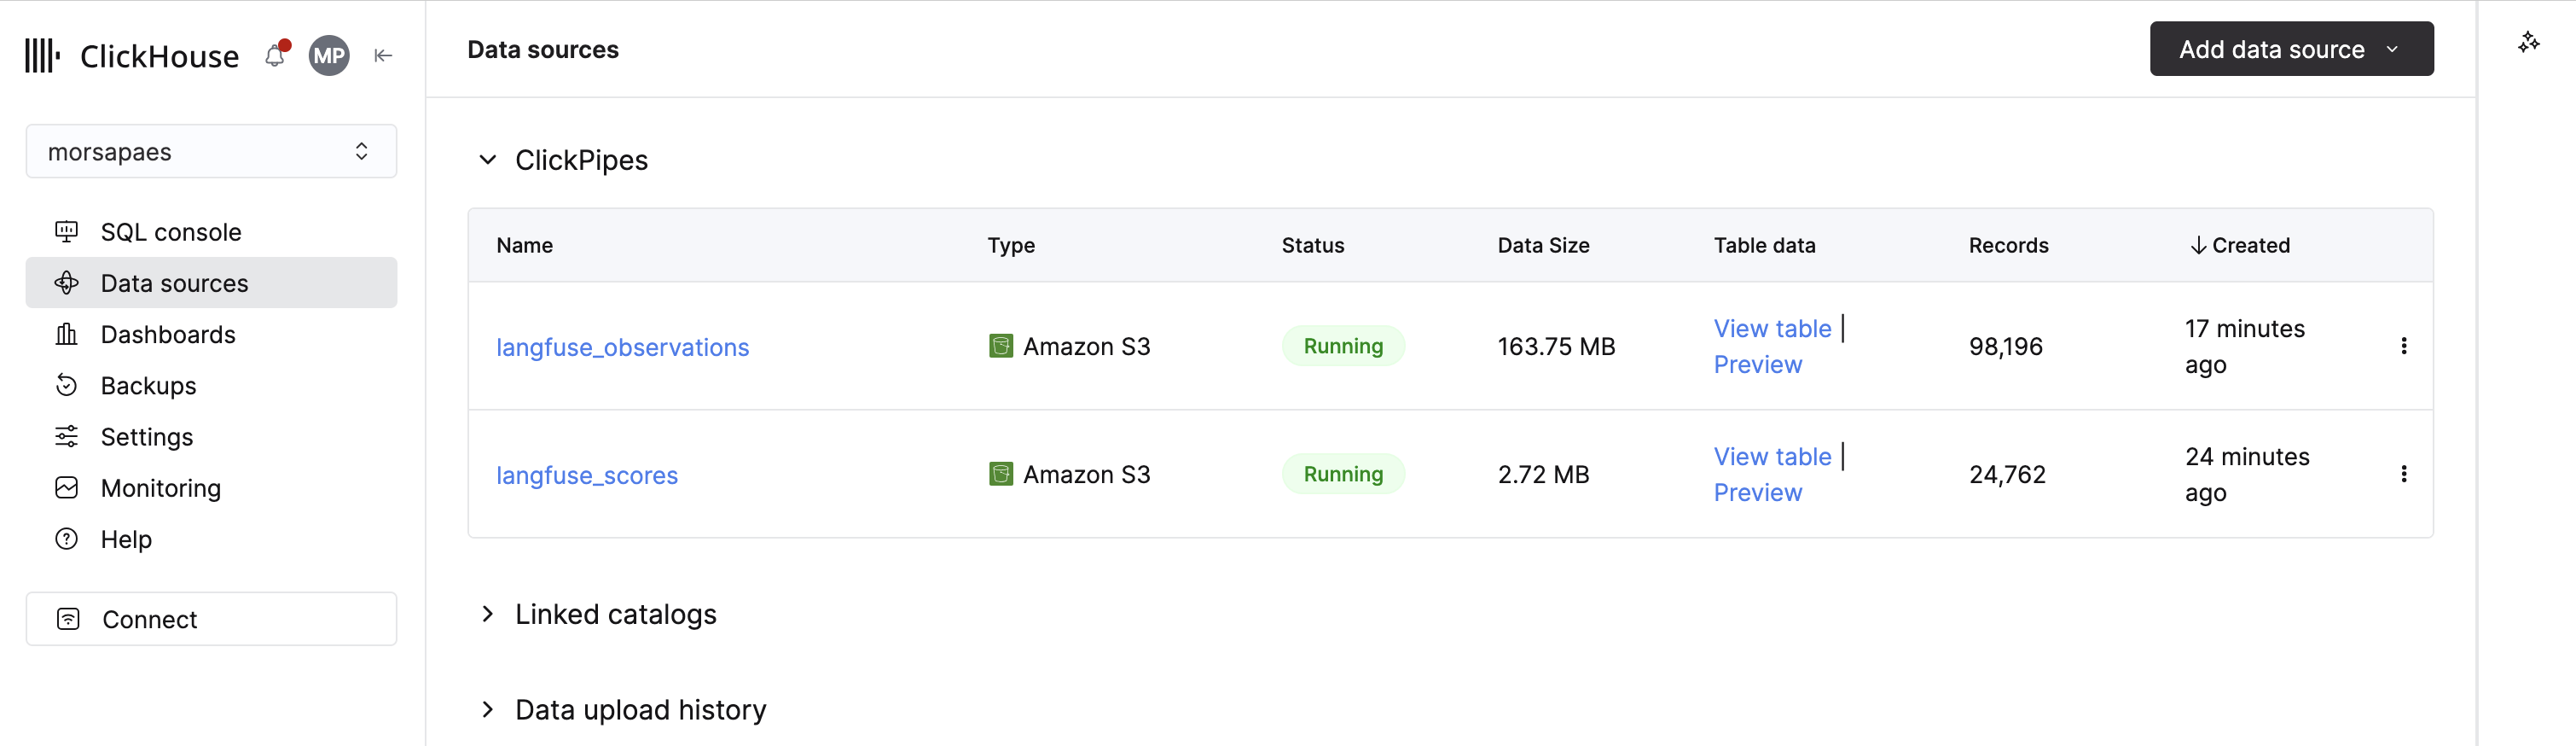
이제 모든 설정이 완료되었습니다! ClickPipes는 먼저 지정된 경로에 있는 모든 파일에 대해 과거 데이터 백필을 수행한 다음, 버킷에 새로 들어오는 파일을 수집하기 시작합니다.