Langfuse Cloud からのエクスポート
このガイドに従って、Langfuse Cloud で定期エクスポート用の Blob Storage インテグレーションを設定します。トレースデータのオブジェクトストレージへのエクスポートは、最短20 minutes 間隔のほか、hourly、daily、weekly のスケジュールでも設定できます。デフォルトでは、各エクスポートに observations (トレース属性で拡充済み) と scores が含まれます。
エクスポートされるファイルの構成
Langfuse Cloud の Blob Storage インテグレーションは、以下のディレクトリ構造で、出力先のバケットまたはストレージコンテナーにデータを書き込みます。ClickHouse Cloud へのインポート
Langfuse Cloud で Blob Storage インテグレーションを設定すると、トレースデータが定期的に対象のバケットまたはストレージコンテナーへエクスポートされます。このデータを ClickHouse Cloud にインポートするには、ClickPipes が提供するマネージドなオブジェクトストレージコネクタを利用できます。| データソース | 詳細 |
|---|---|
 Amazon S3 および S3 互換オブジェクトストレージ | S3 ClickPipes を使用して連携します。 |
 Google Cloud Storage | GCS ClickPipes を使用して連携します。 |
 Azure Blob Storage | ABS ClickPipes を使用して連携します。 |
ClickPipe を作成する
この例では、S3 ClickPipe を使用して、Langfuse Cloud から定期的にエクスポートされたデータを受け取る S3 バケットからデータをインポートします。この手順は、あらゆるオブジェクトストレージのエクスポート先に共通するひな形としても利用できます。データソースごとの詳細な手順については、ClickPipes ドキュメントを参照してください。1
データソースを選択する
1. ClickHouse Cloud のメインナビゲーションメニューで Data sources を選択し、Create ClickPipe をクリックします。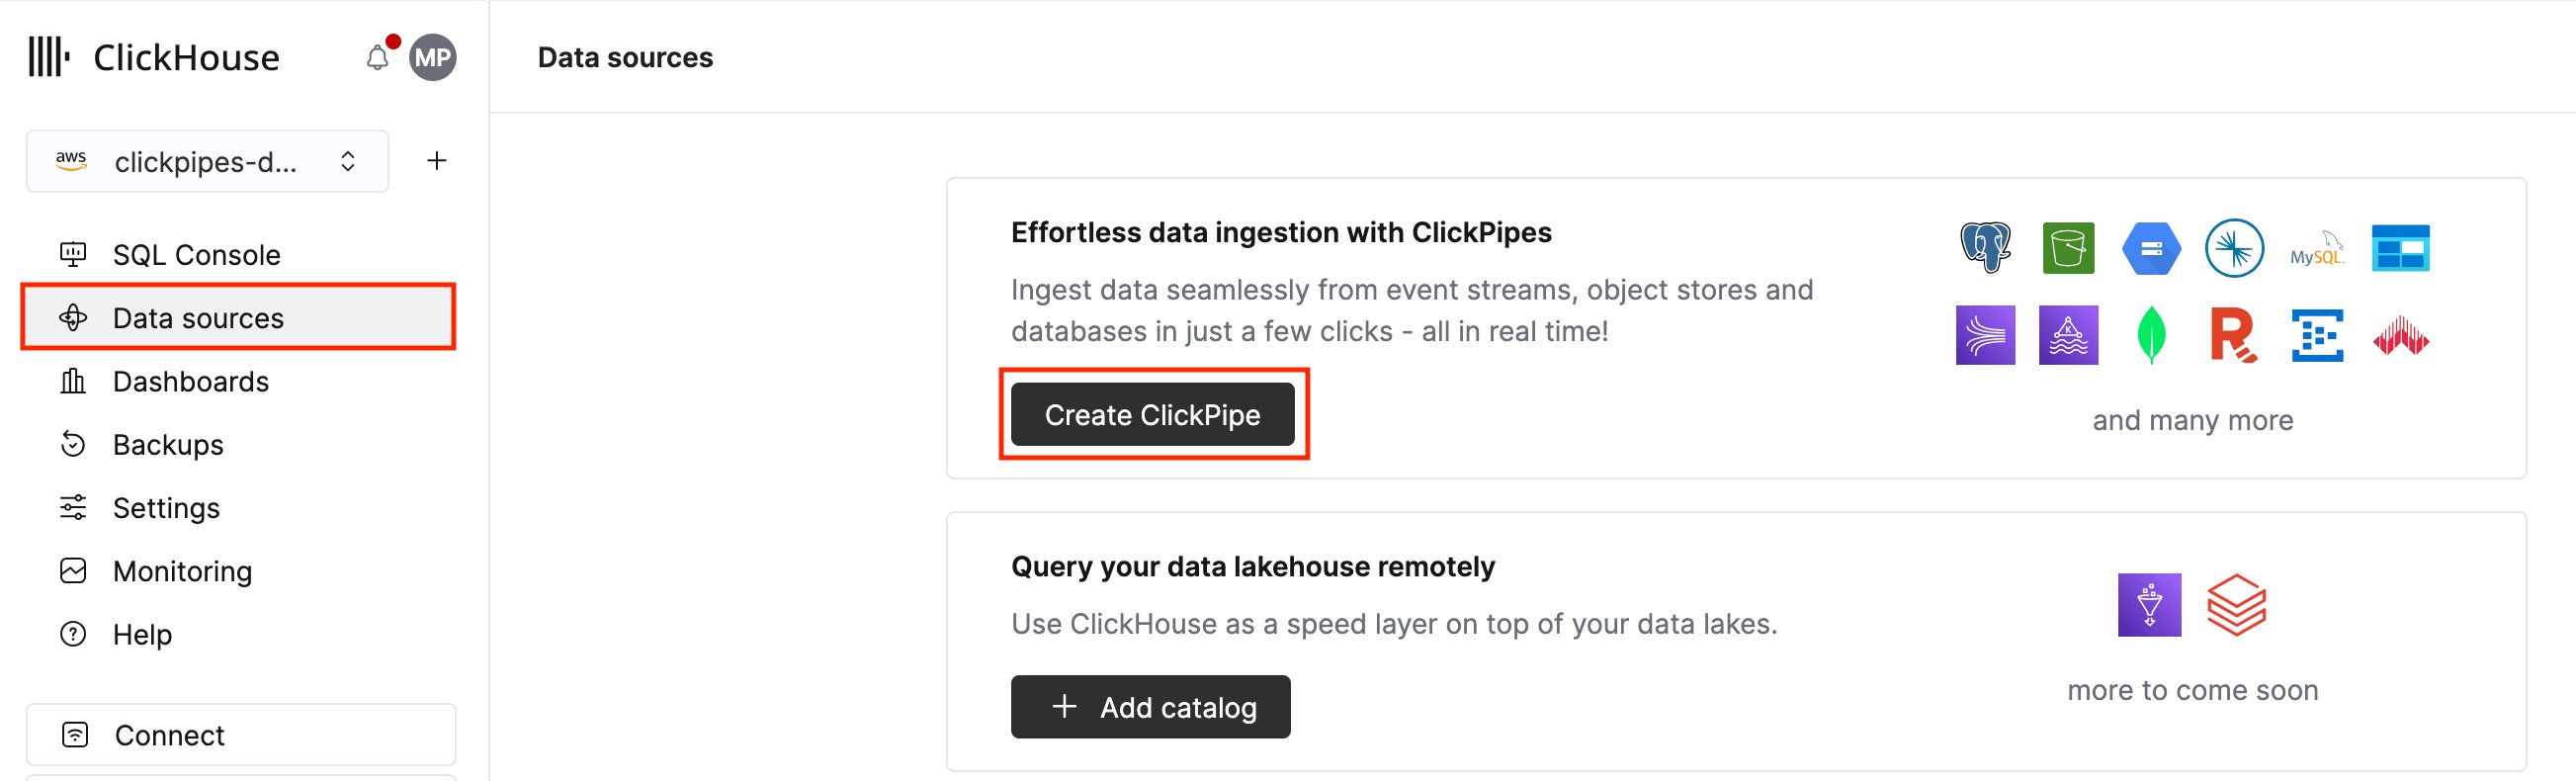
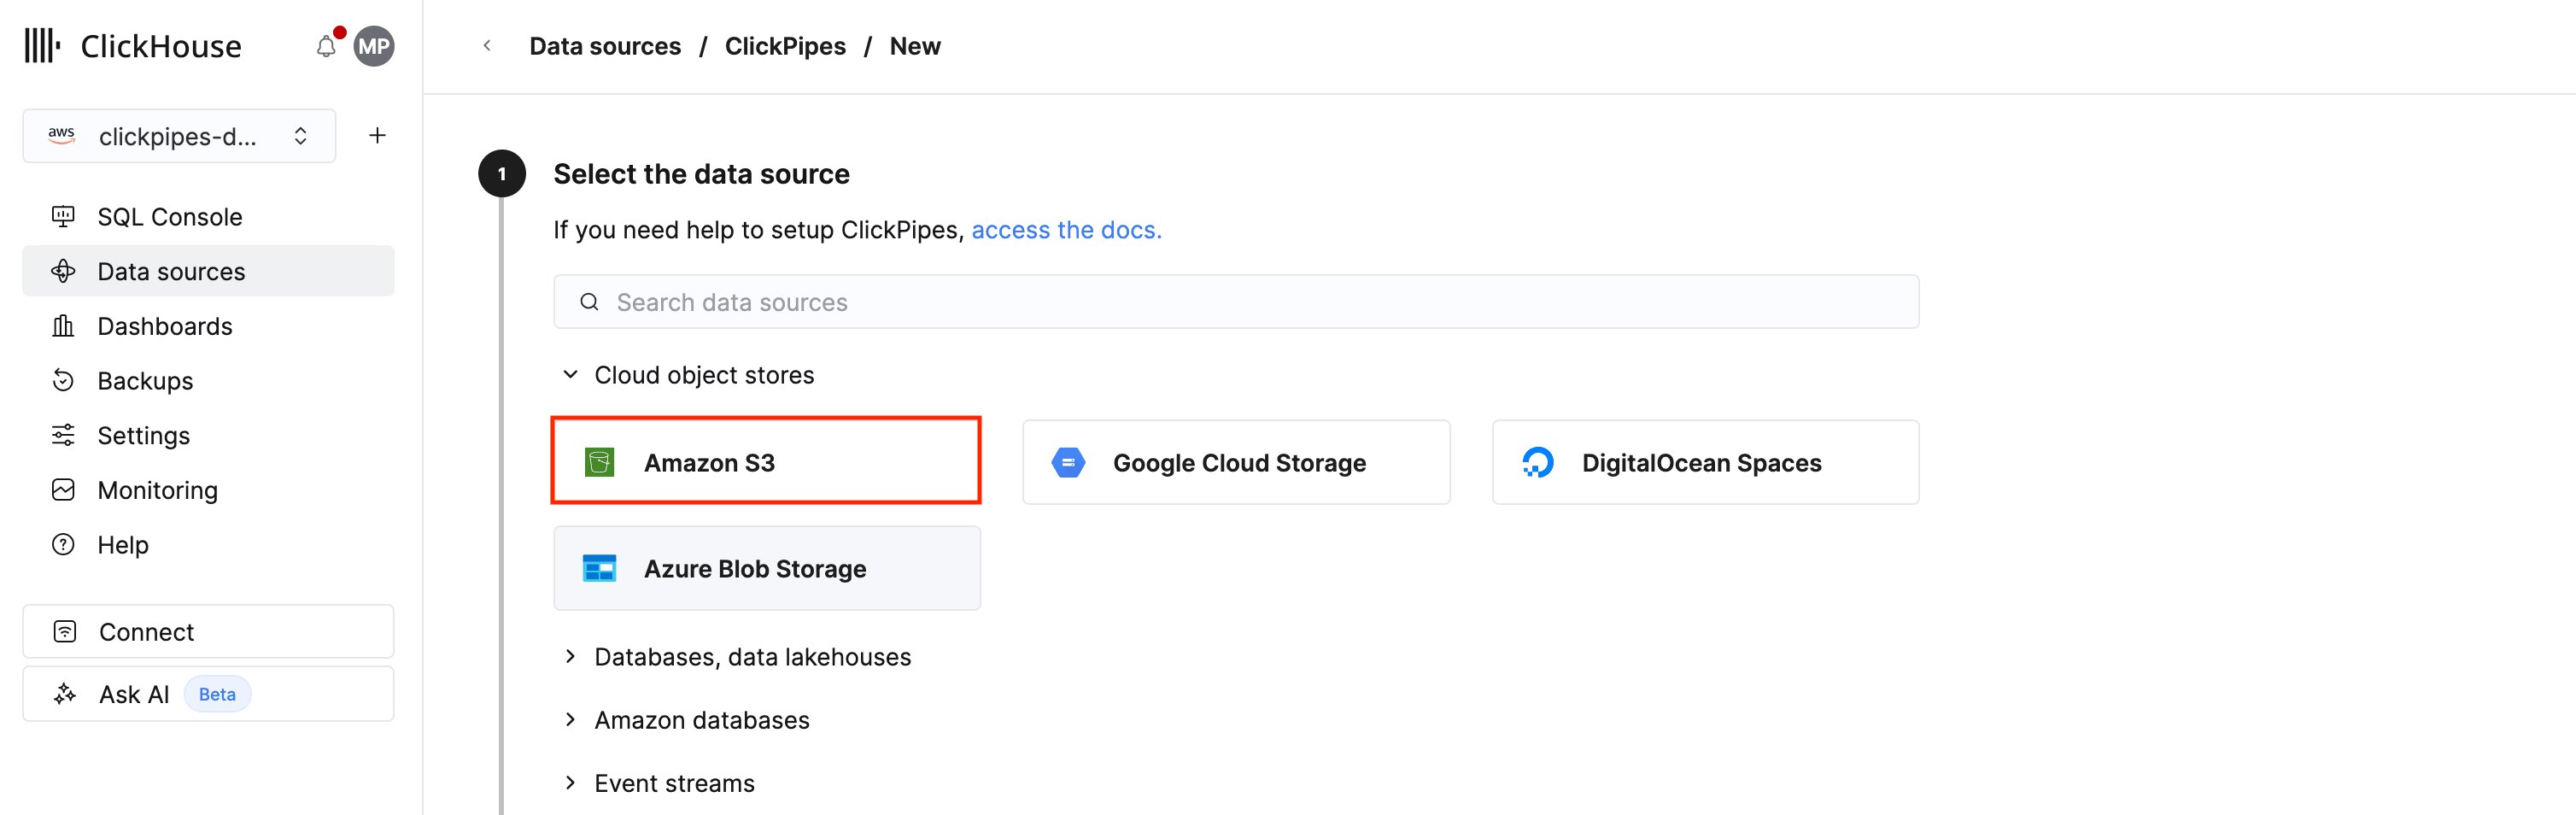
2
接続を設定する
1. Langfuse Cloud のエクスポートを受け取るバケットに ClickPipes が接続・認証するために必要な情報を入力します。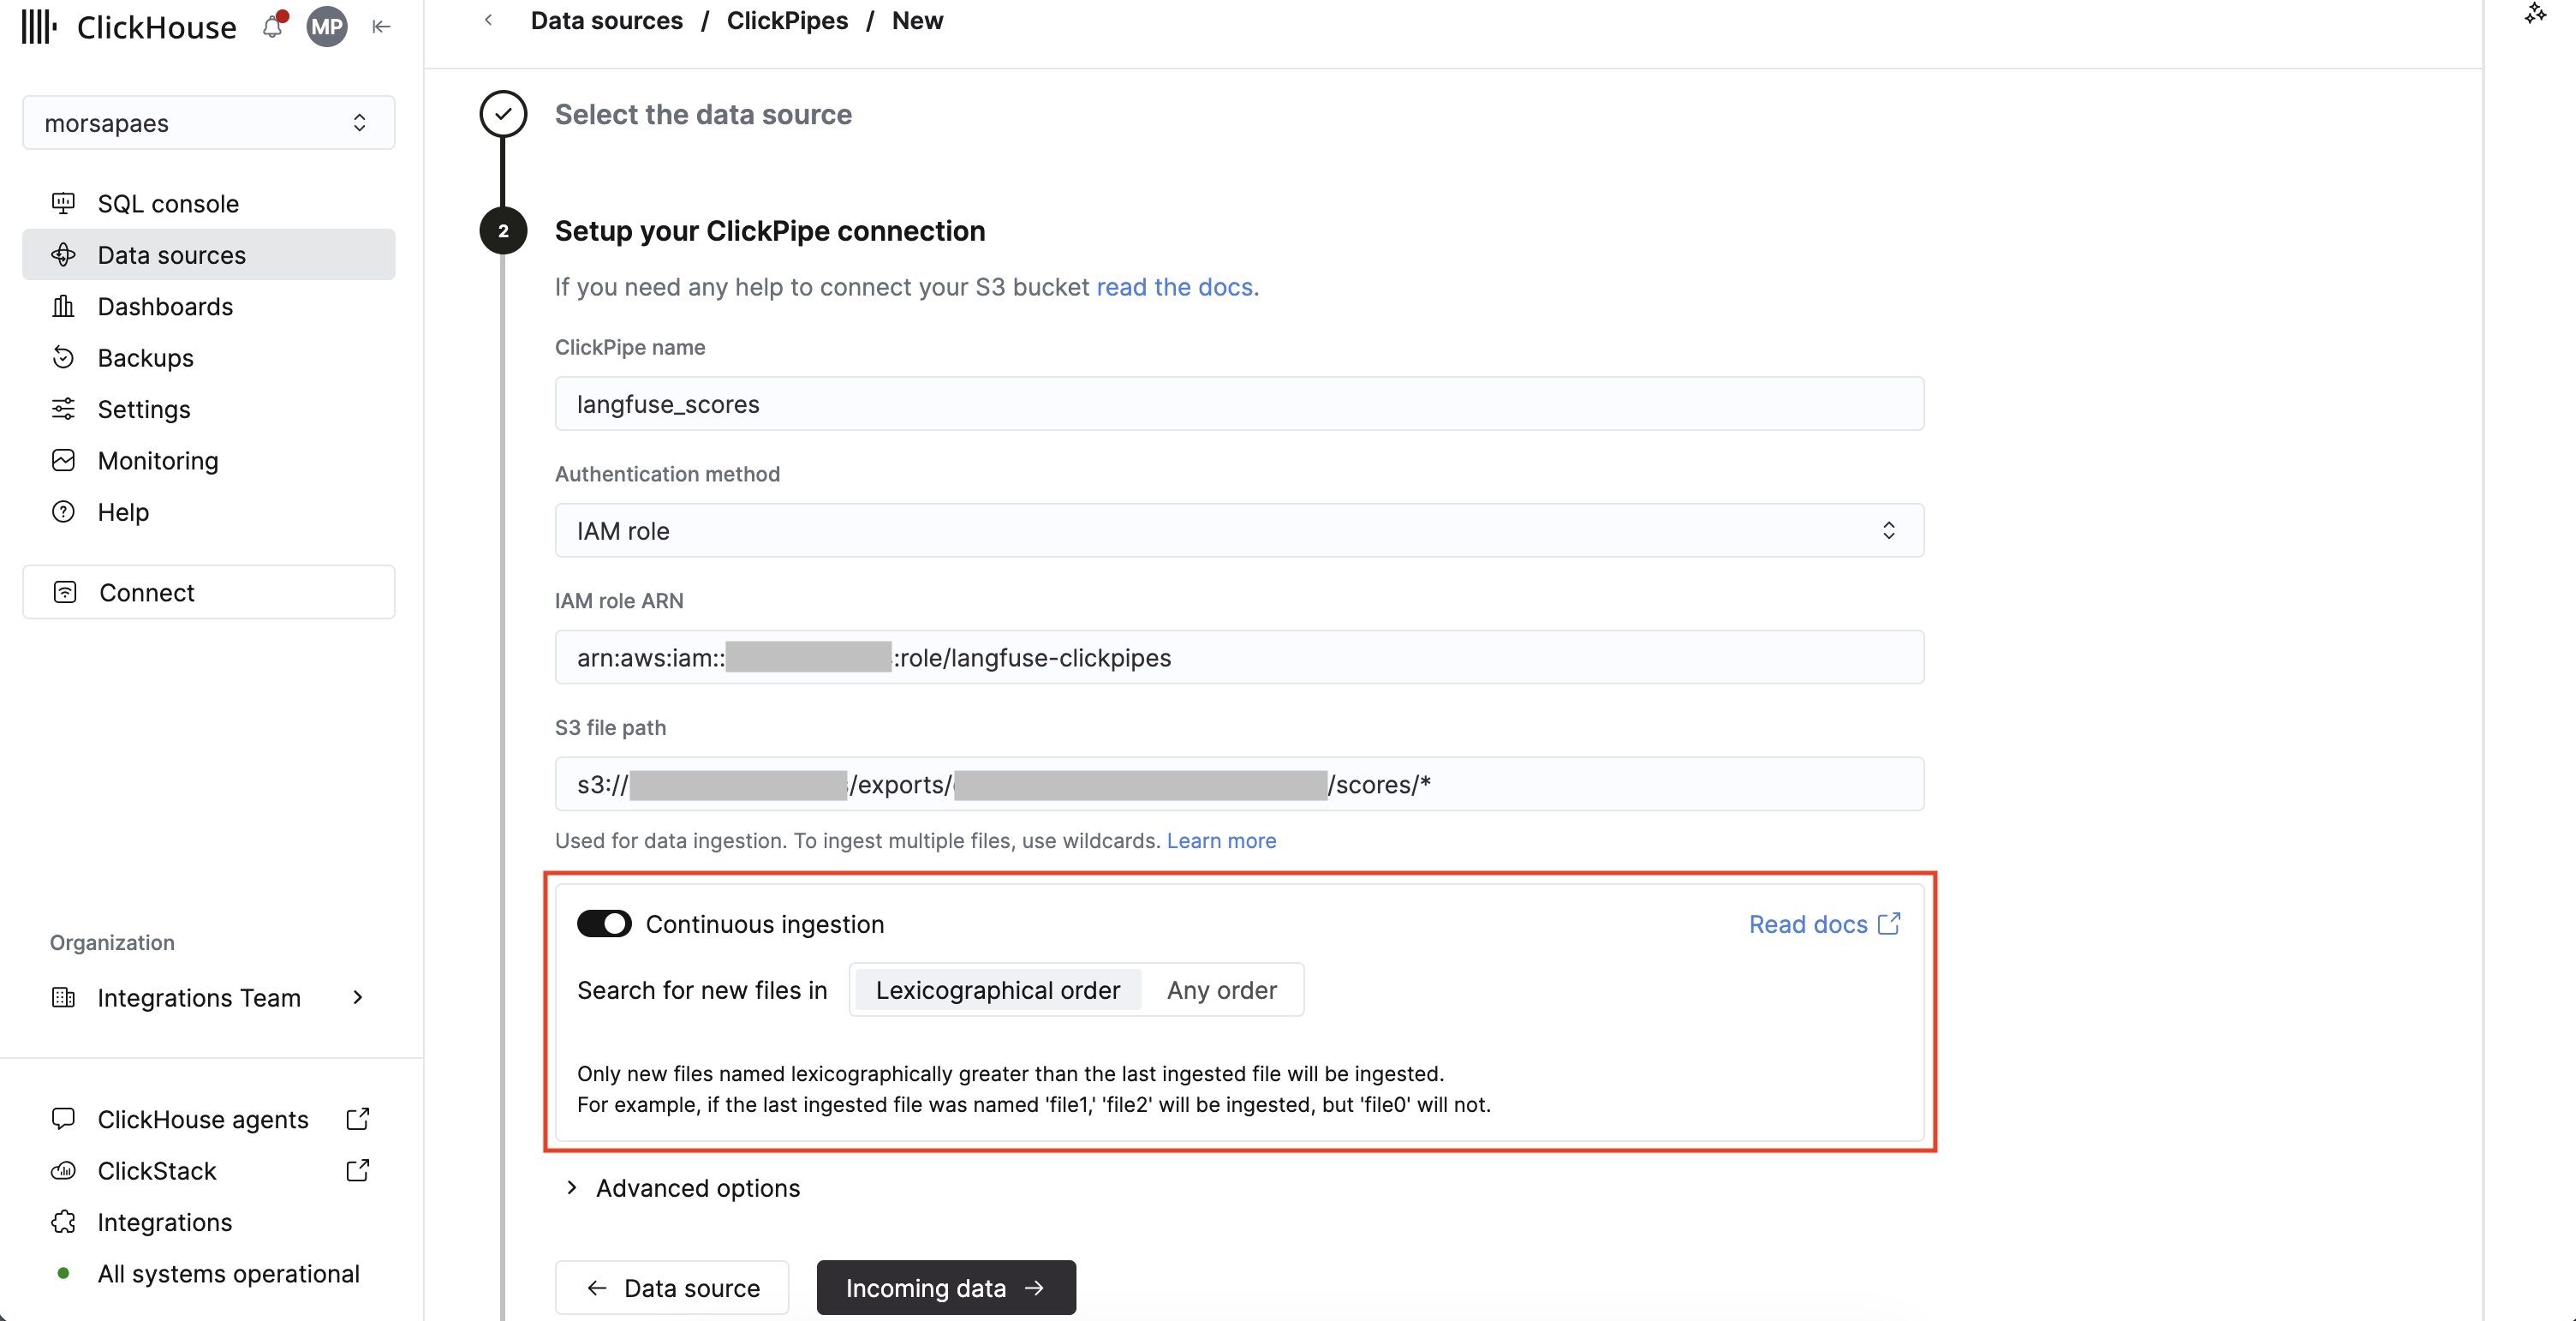
-
Authentication method: S3 ClickPipe は IAM 認証情報 (
Credentials) と IAM role ベースの認証 (IAM role) をサポートしています。ClickPipes に必要なのは、バケットへの読み取りアクセス権のみです。認証とアクセス許可の詳細については、リファレンスドキュメントを参照してください。 -
S3 file path: ClickPipe の参照先としてサブディレクトリを指定し、
*ワイルドカードを使用してエクスポートされたすべてのファイルにマッチさせます。サブディレクトリごとにエクスポートファイルのスキーマが異なるため、サブディレクトリごとに ClickPipe を 1 つずつ作成する必要があります。ネストされたプレフィックスをまたいでファイルをマッチさせる方法など、サポートされているパターンの詳細については、リファレンスドキュメントを参照してください。
3
取り込むデータを検証する
1. ClickPipes がバケットに接続し、指定したパス内のファイルを一覧表示して、ファイルフォーマットを推論します。この例では、Langfuse Cloud のデフォルトのエクスポートファイルフォーマット (Parquet) を使用しています。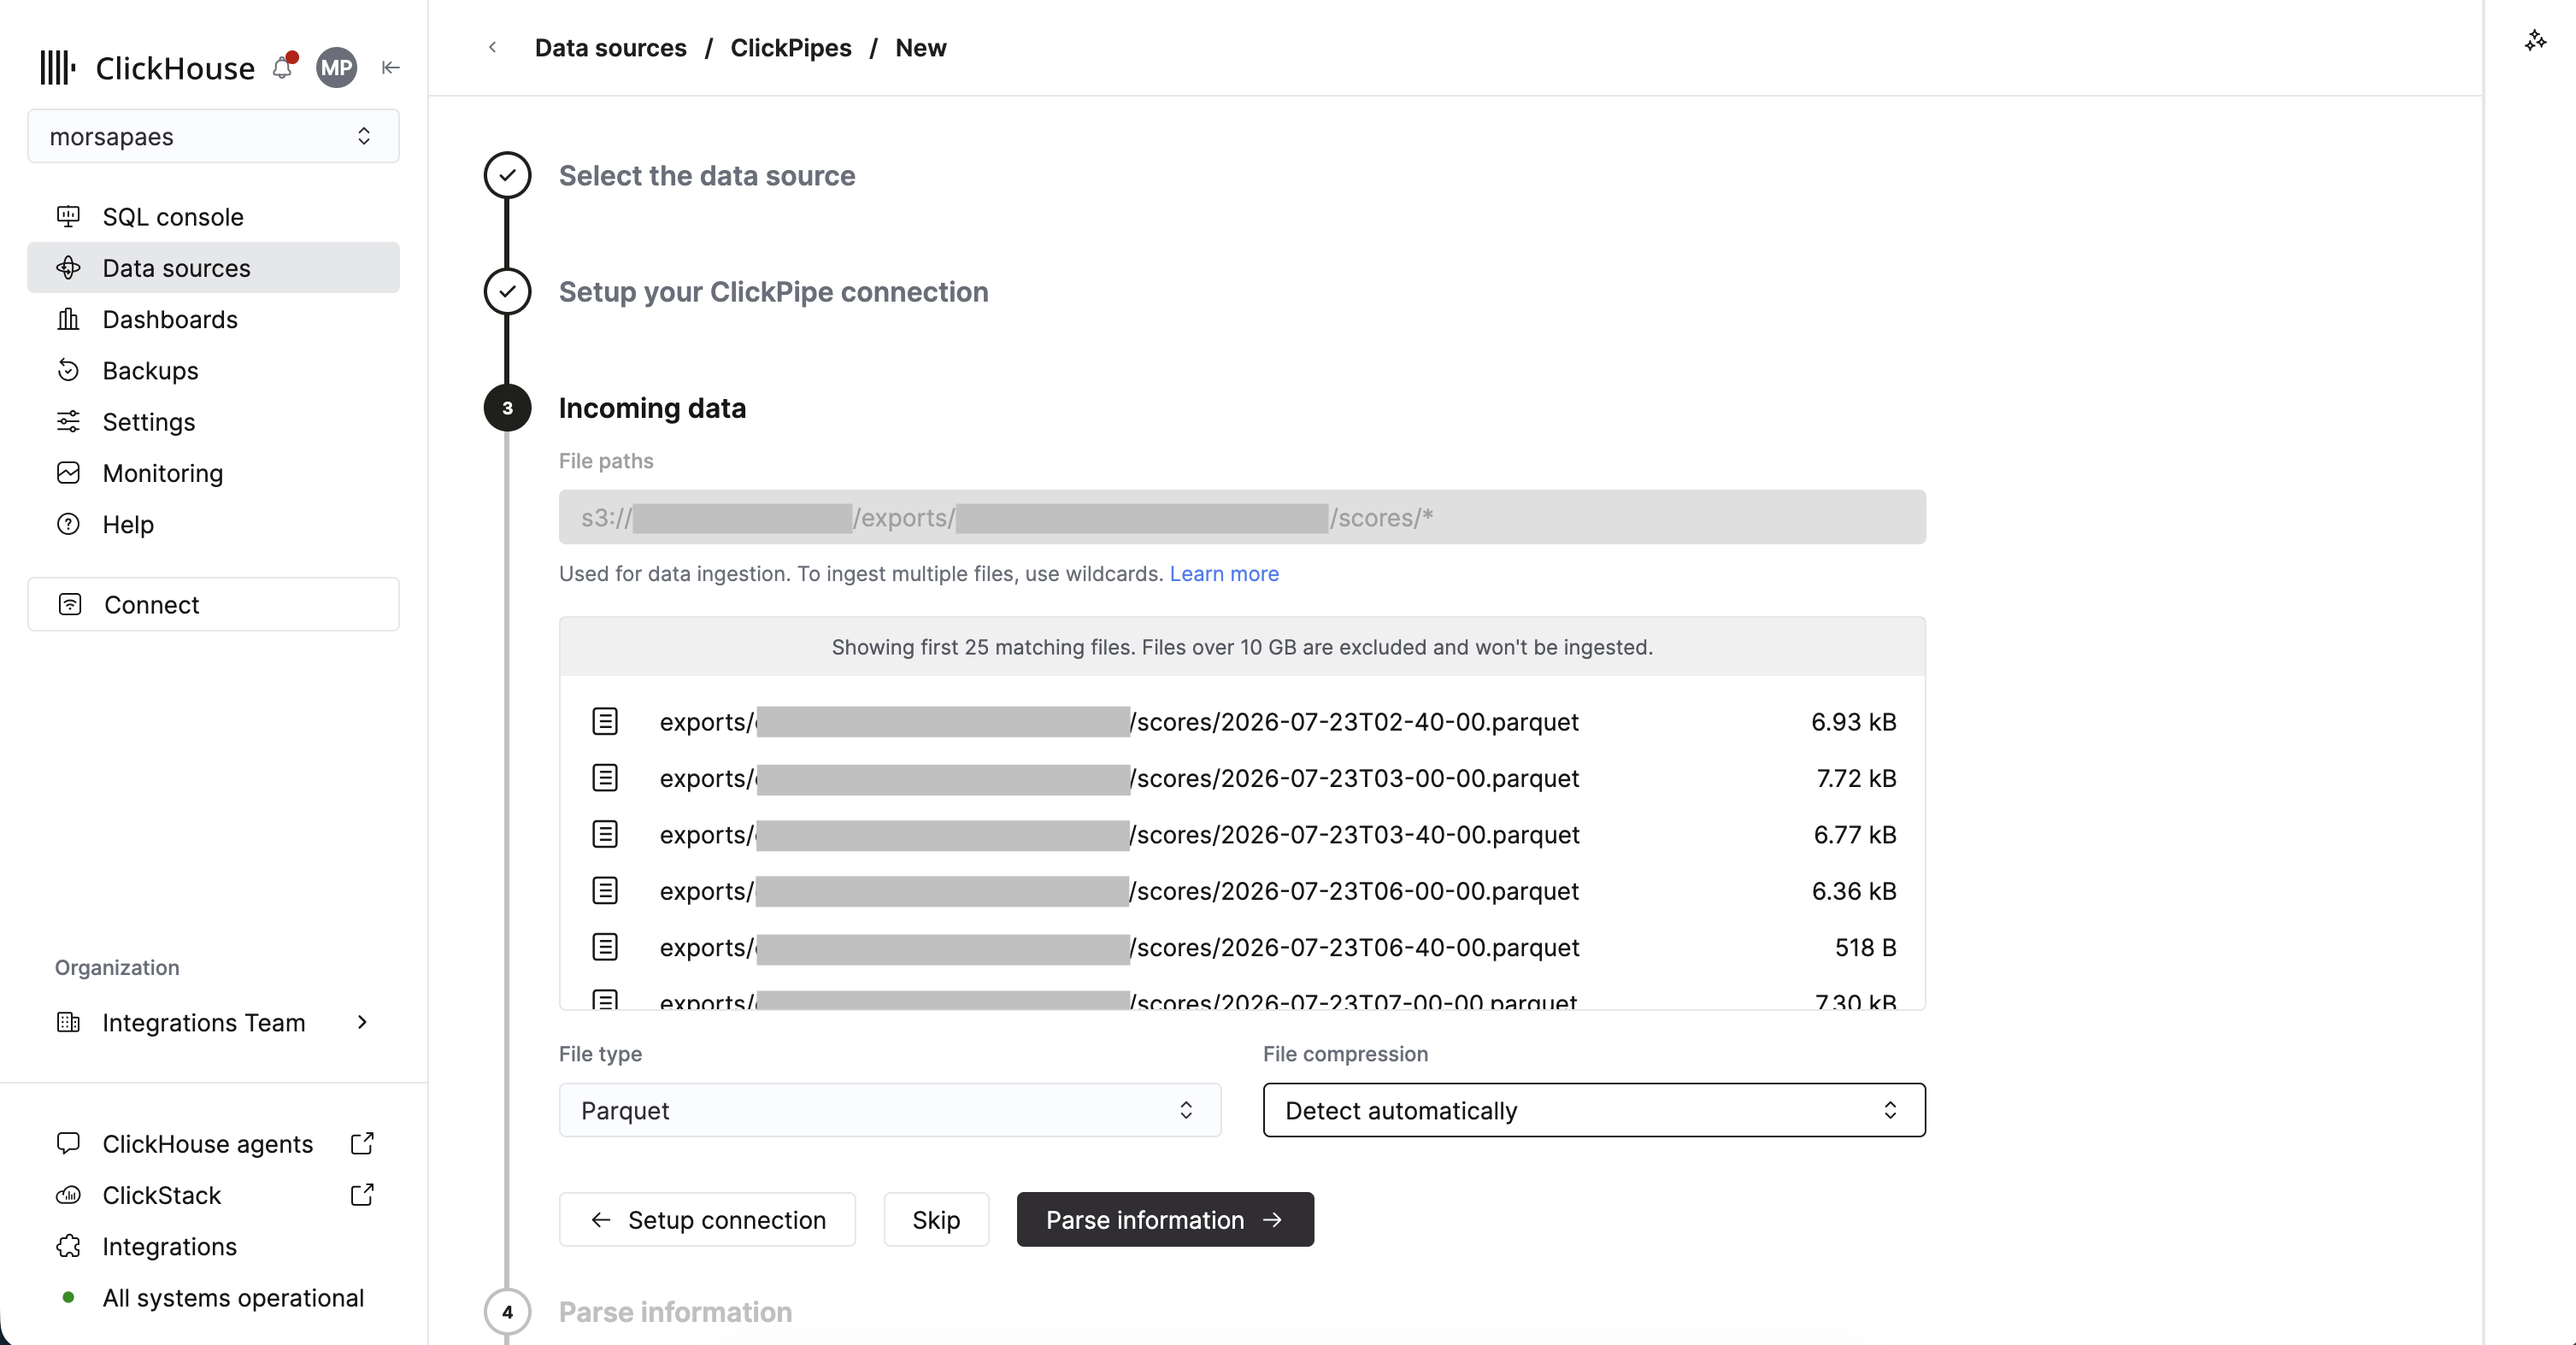
4
取り込み先を設定する
1. このステップでは、推定したスキーマを確認し、ターゲットテーブルの設定をカスタマイズできます。具体的には、データ型マッピングの調整、sorting key の定義、テーブルエンジン の選択などを行います。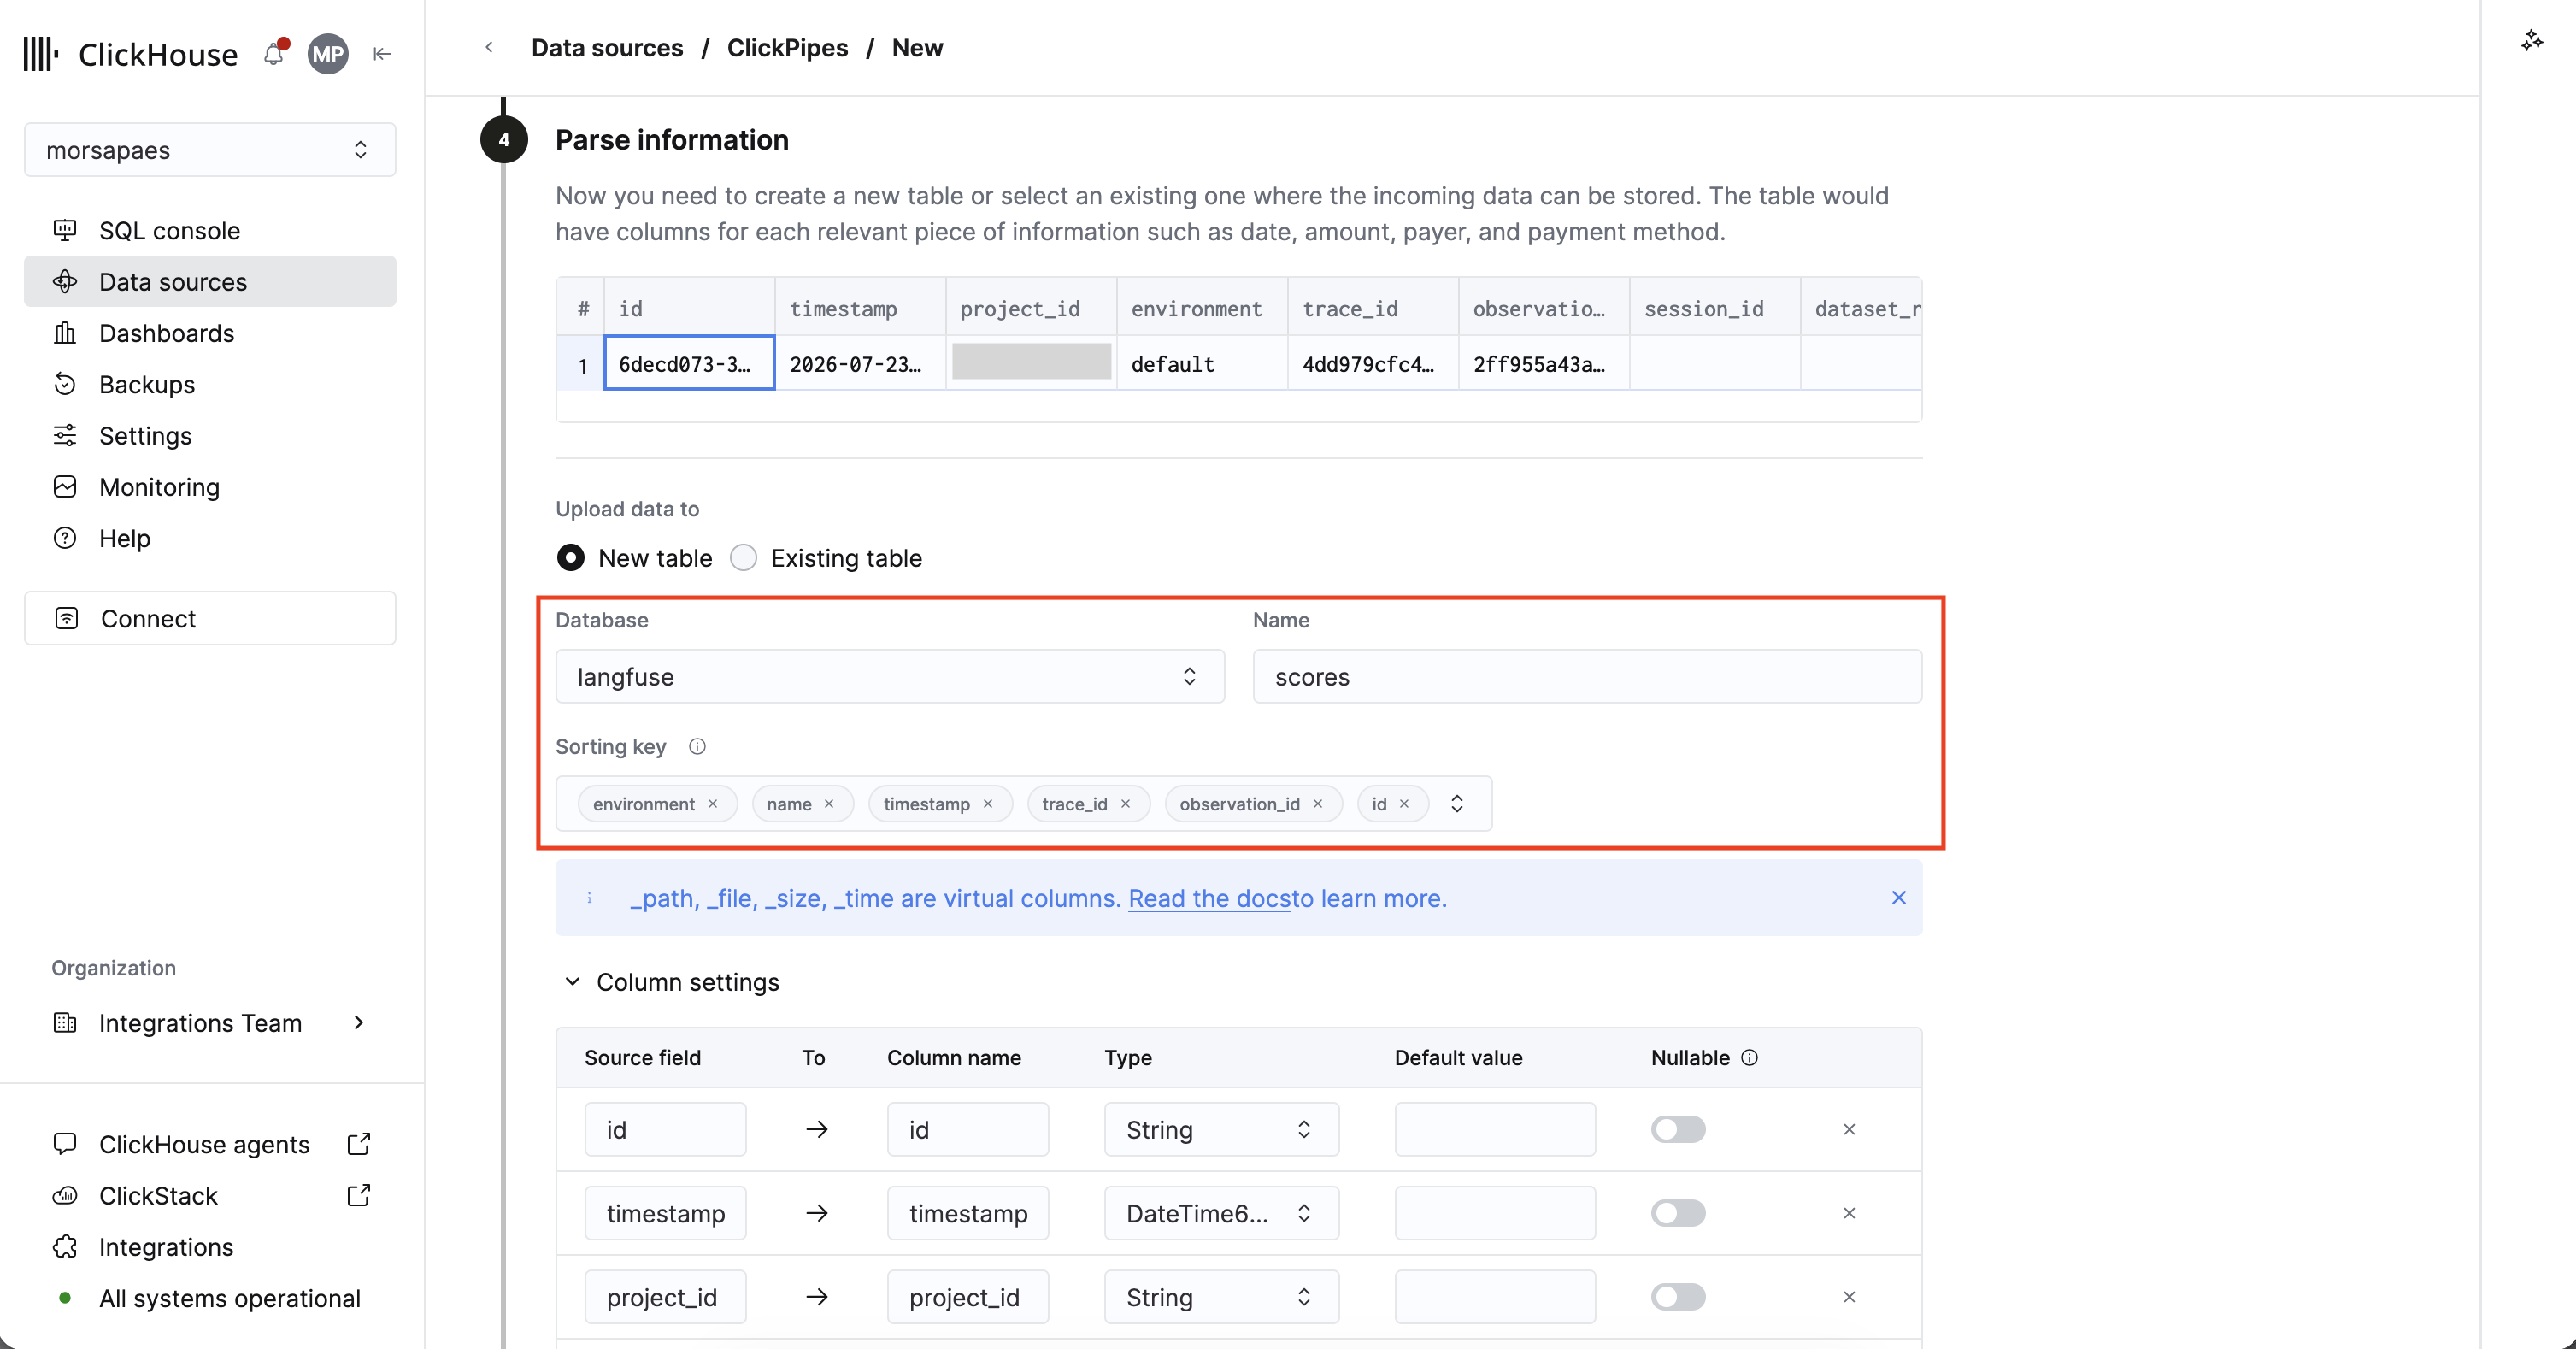
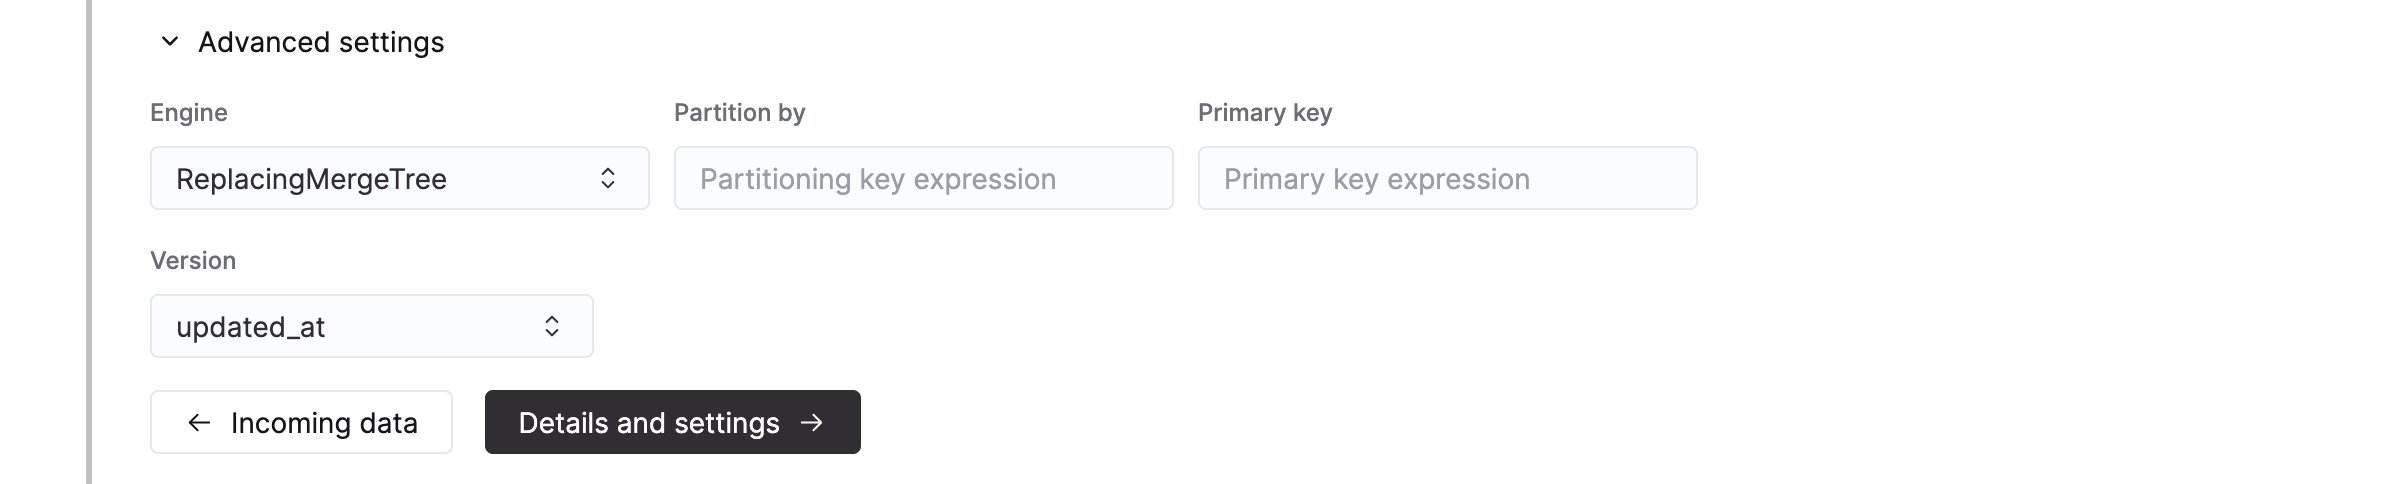
-
Database と Name: Langfuse データ用の専用データベース (例:
langfuse) と、宛先テーブルのわかりやすい名前 (例:scores) を指定します。ClickPipes では、名前の衝突を避けるため、デフォルトでdefault.s3-<uuid>が使用されます。 -
Sorting key: 宛先テーブルのソートキーです。ClickHouse がディスク上にデータをどのように格納するかを決定します。最適なパフォーマンスを得るには、sorting key をデータのアクセスパターンに合わせ、クエリがデータの読み取りをできるだけスキップできるようにする必要があります。
このキーは
ReplacingMergeTreeテーブルでの重複排除にも使用されるため、カラムの組み合わせでレコードを一意に識別できる必要があります。複数の Langfuse プロジェクトを 1 つのテーブルに読み込む場合は、sorting key の先頭にproject_idを追加してください。sorting key の選び方についてはリファレンスドキュメントを参照してください。 -
Partition by: 古いトレースを期限切れにする予定がなければ、空欄のままにします。ClickHouse におけるパーティション化はクエリ最適化ではなくデータ管理のための機能であり、時間範囲のクエリは推奨の sorting key によってすでに絞り込まれます。保持期間の管理が必要な場合は、時間カラム (
toYYYYMM(start_time)、scoresの場合はtoYYYYMM(timestamp)) でパーティション化してください。こうすることで、1 か月分のトレースを 1 回のDROP PARTITION操作で削除できます。
ReplacingMergeTree に設定して、Version カラムに updated_at を指定します。uniq()、max()、min()) でない限り、ターゲットエンジンに ReplacingMergeTree を使用し、下流のデータモデルで重複排除を必ず行ってください。ReplacingMergeTree による重複排除このテーブルエンジンは、バックグラウンドマージによって重複を統合します。読み取り時に完全な重複排除 (すなわち merge-on-read のセマンティクス) を行うには、クエリ実行時に
FINAL 修飾子 (または argMax() 形式の集計) を必ず使用してください。5
アクセス許可を設定する
ClickPipes は、宛先テーブルへのデータ書き込み用に専用ユーザーを作成します。この内部ユーザーには、カスタムロールまたは事前定義済みロールのいずれかを選択して割り当てます。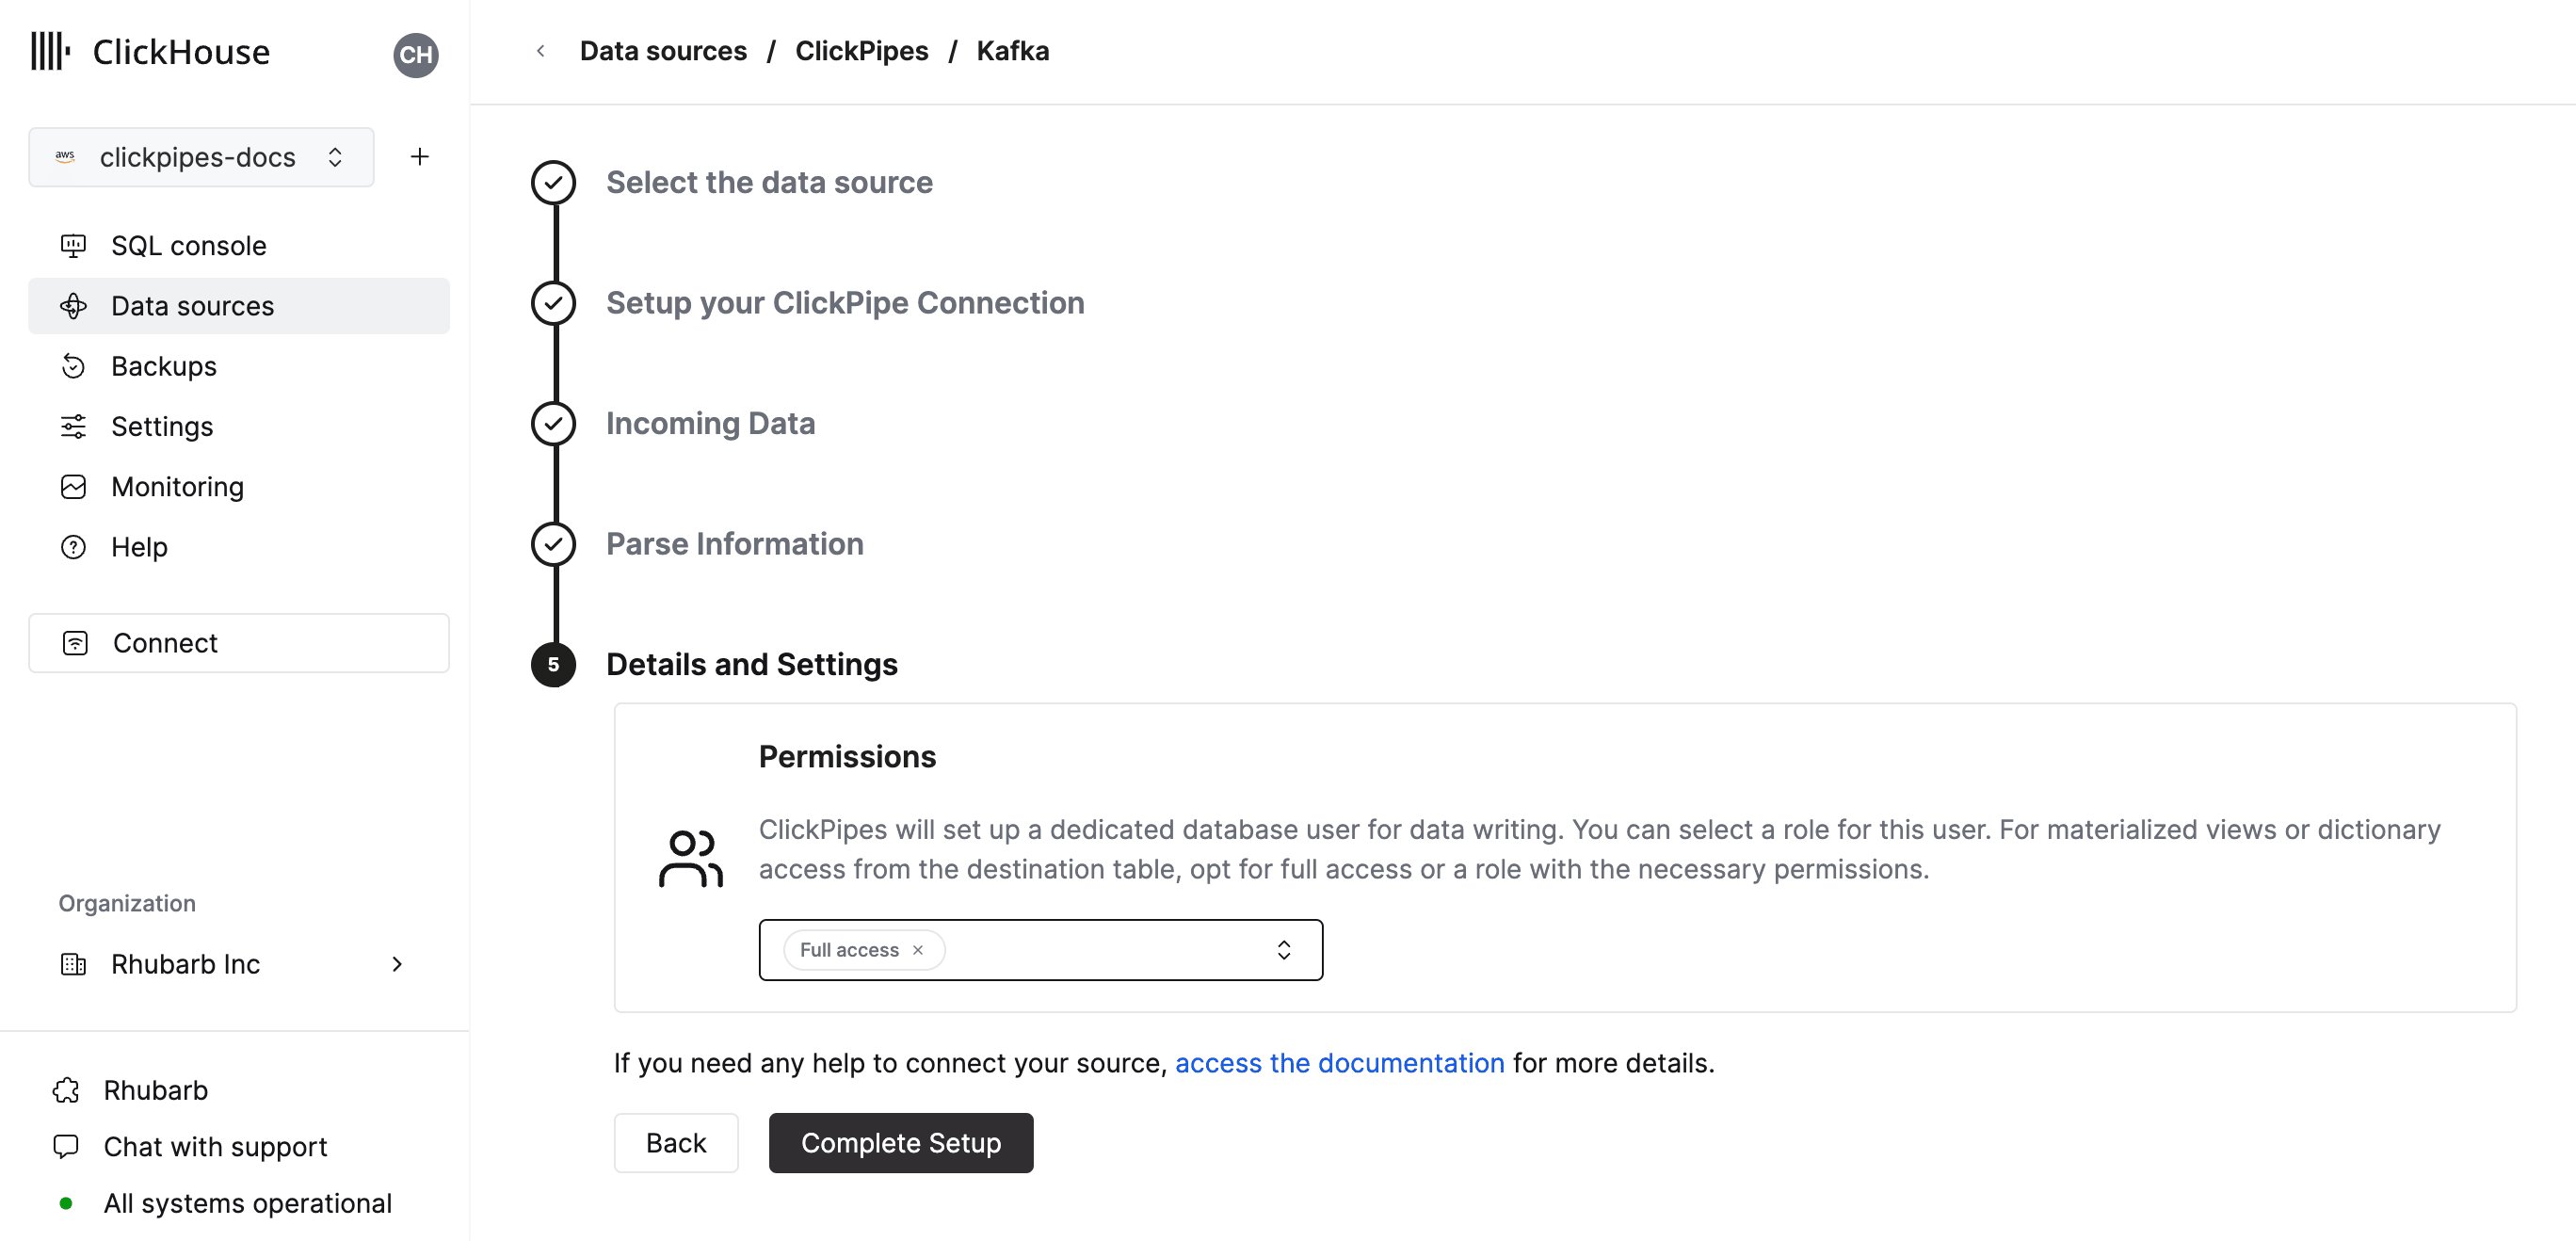
Full access: クラスターへのフルアクセス権を持ちます。宛先テーブルで materialized view または Dictionary を使用する場合は、このロールが必要です。Only destination table: 宛先テーブルに対するINSERTアクセス許可のみを持ちます。
6
設定を完了する
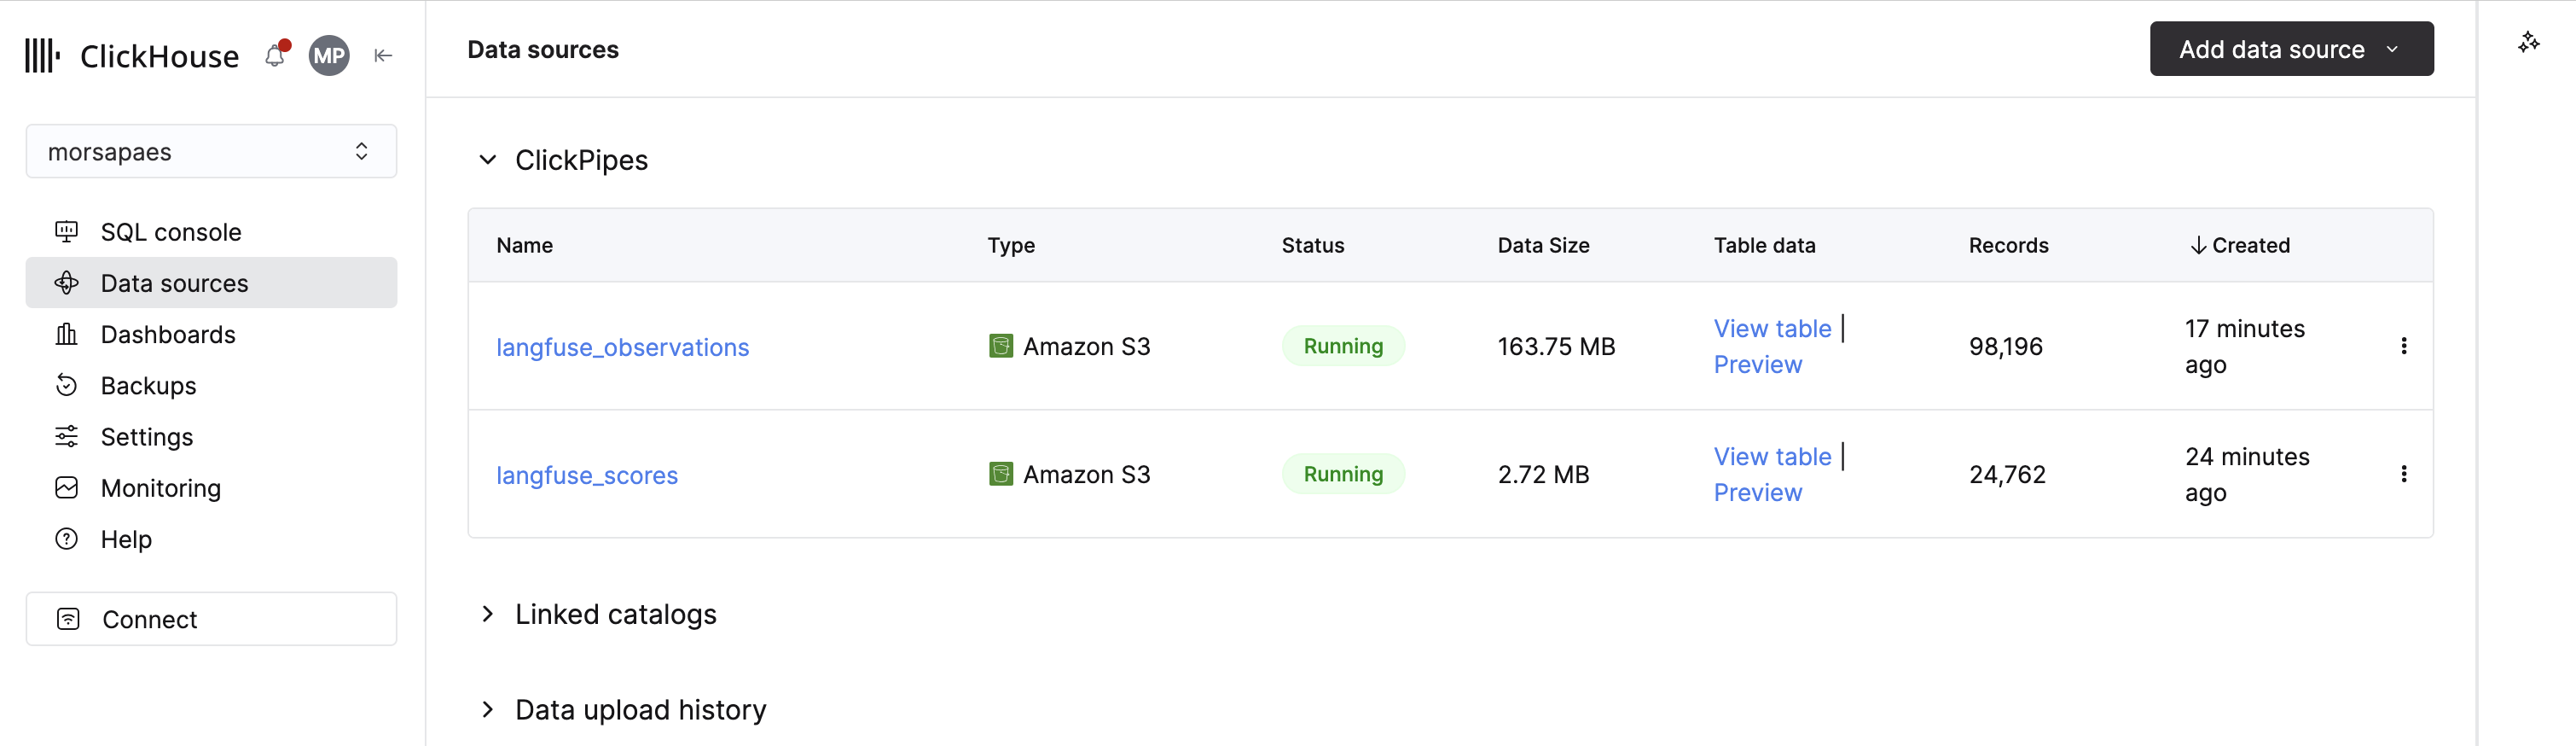
これで設定は完了です。ClickPipes はまず、指定したパス内のすべてのファイルを対象に過去データのバックフィルを実行し、その後はバケットに新しいファイルが到着するたびに取り込みを開始します。