> ## Documentation Index
> Fetch the complete documentation index at: https://private-7c7dfe99-vortex-format.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# 导入 Langfuse Cloud 链路追踪数据
> 如何使用 ClickPipes 将从 Langfuse Cloud 导出的 LLM 链路追踪数据加载到 ClickHouse Cloud。
本指南将逐步介绍如何将 [Langfuse Cloud](https://cloud.langfuse.com/) 中的 LLM 链路追踪数据加载到 ClickHouse Cloud,以便进行实时分析。
从 Langfuse Cloud 导出
请按照[此指南](https://langfuse.com/docs/api-and-data-platform/features/export-to-blob-storage)在 Langfuse Cloud 中配置 blob 存储集成,以启用定时导出。您可以将链路追踪数据定时导出到对象存储,最快每 `20 minutes` 导出一次,也可以按 `hourly`、`daily` 或 `weekly` 频率执行。默认情况下,每次导出都包含 `observations` (已使用 trace 属性富化) 和 `scores`。
导出文件布局
Langfuse Cloud 中的 blob 存储集成会按以下目录结构,将数据写入目标桶或存储容器:
```text theme={null}
{prefix}{project-id}/
├── observations_v2/ # observations enriched with trace attributes
├── scores/ # scores
└── manifests/ # one JSON file per completed run with export metadata
```
导入到 ClickHouse Cloud
在 Langfuse Cloud 中配置好 blob 存储集成后,链路追踪数据会定期导出到目标桶或存储容器中。要将这些数据导入 ClickHouse Cloud,可以使用 [ClickPipes](/zh/integrations/clickpipes) 及其托管的对象存储连接器:
| 数据源 | 详情 |
| - | - |
|  Amazon S3
及兼容 S3 的对象存储 | 通过 [S3 ClickPipes](/zh/integrations/clickpipes/object-storage/amazon-s3/overview) 集成。 |
|  **Google Cloud Storage** | 通过 [GCS ClickPipes](/zh/integrations/clickpipes/object-storage/google-cloud-storage/overview) 集成。 |
|
 **Azure blob 存储** | 通过 [ABS ClickPipes](/zh/integrations/clickpipes/object-storage/azure-blob-storage/overview) 集成。 |
创建 ClickPipe
本示例使用 S3 ClickPipe,从接收 Langfuse Cloud 定时导出数据的 S3 桶中导入数据,可作为所有对象存储导出目标的通用参考模板。如需了解特定数据源的配置指南,请参阅 [ClickPipes 文档](/zh/integrations/clickpipes)。
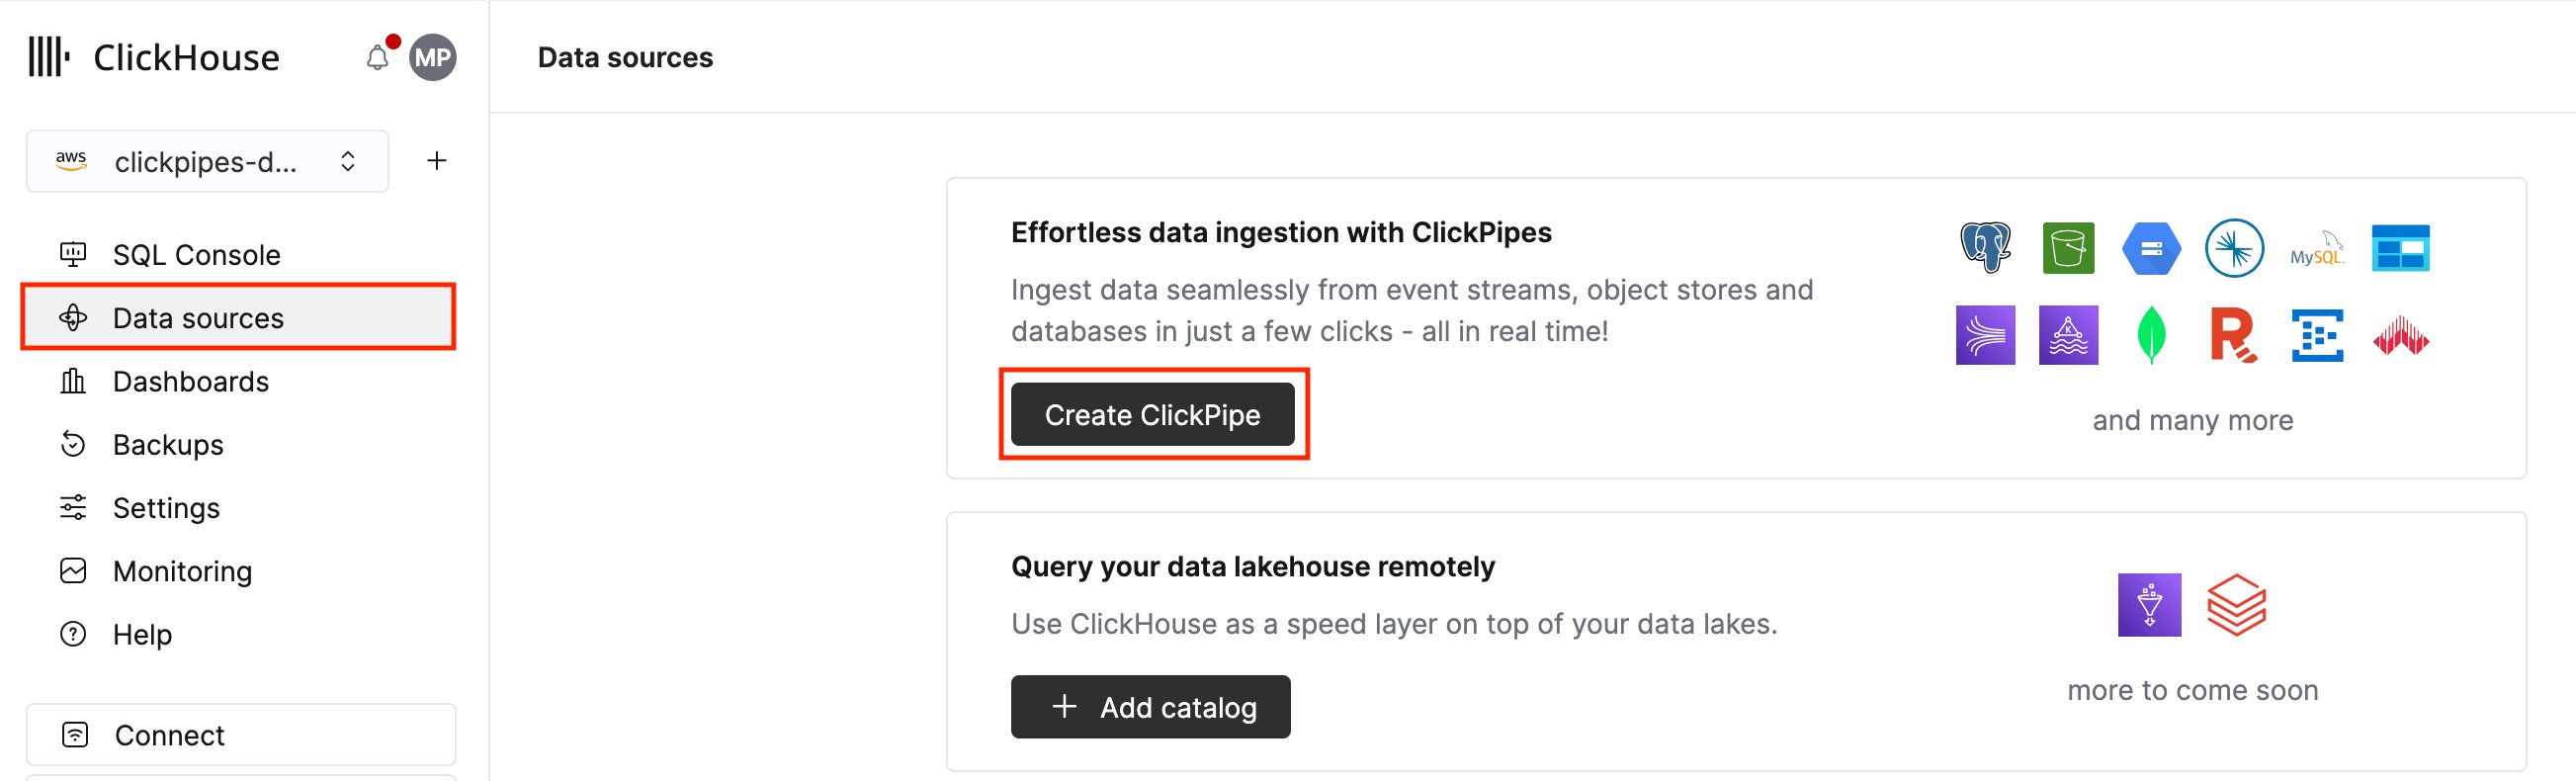
**1.** 在 ClickHouse Cloud 的主导航菜单中选择 **Data sources**,然后点击 **Create ClickPipe**。
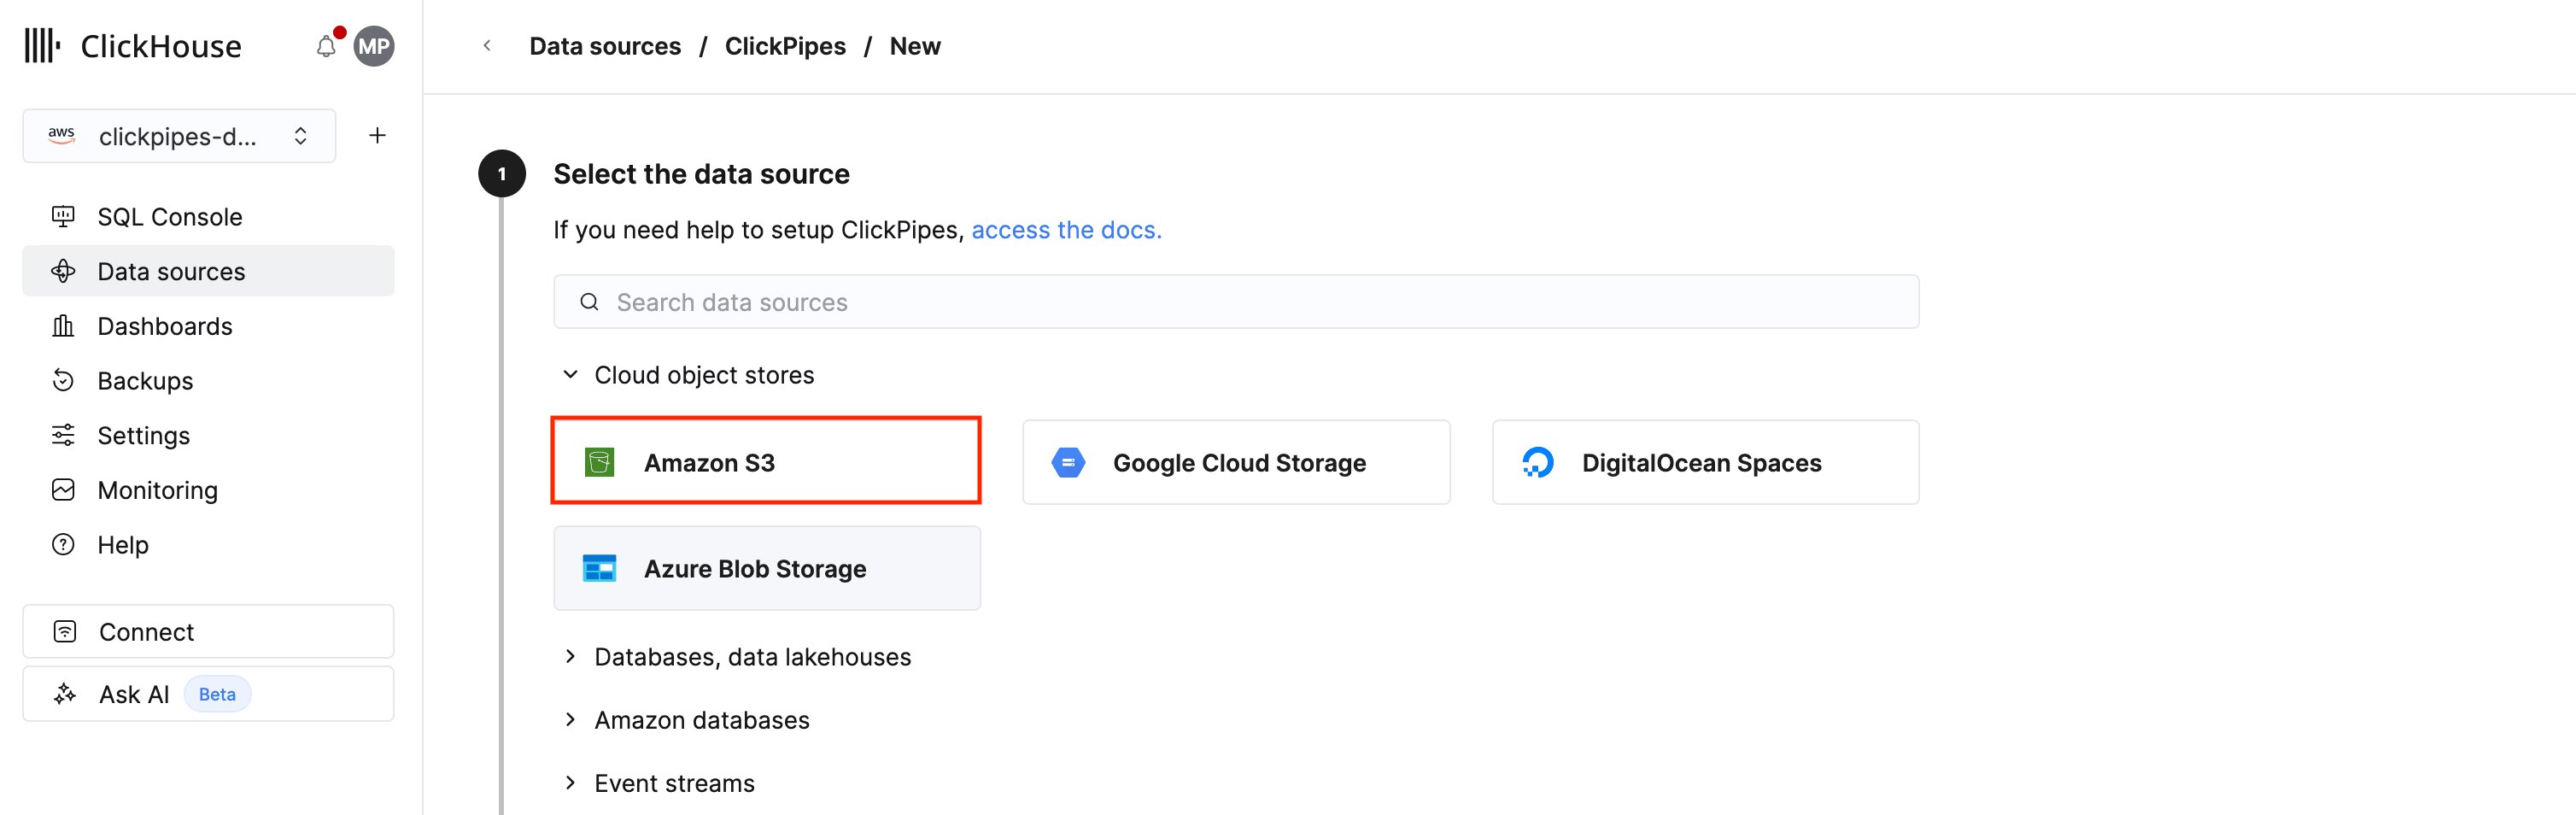
 **2.** 点击 **Amazon S3** 卡片。对于 ClickPipes UI 中未列出的其他兼容 S3 的服务,也可以通过此卡片进行连接。
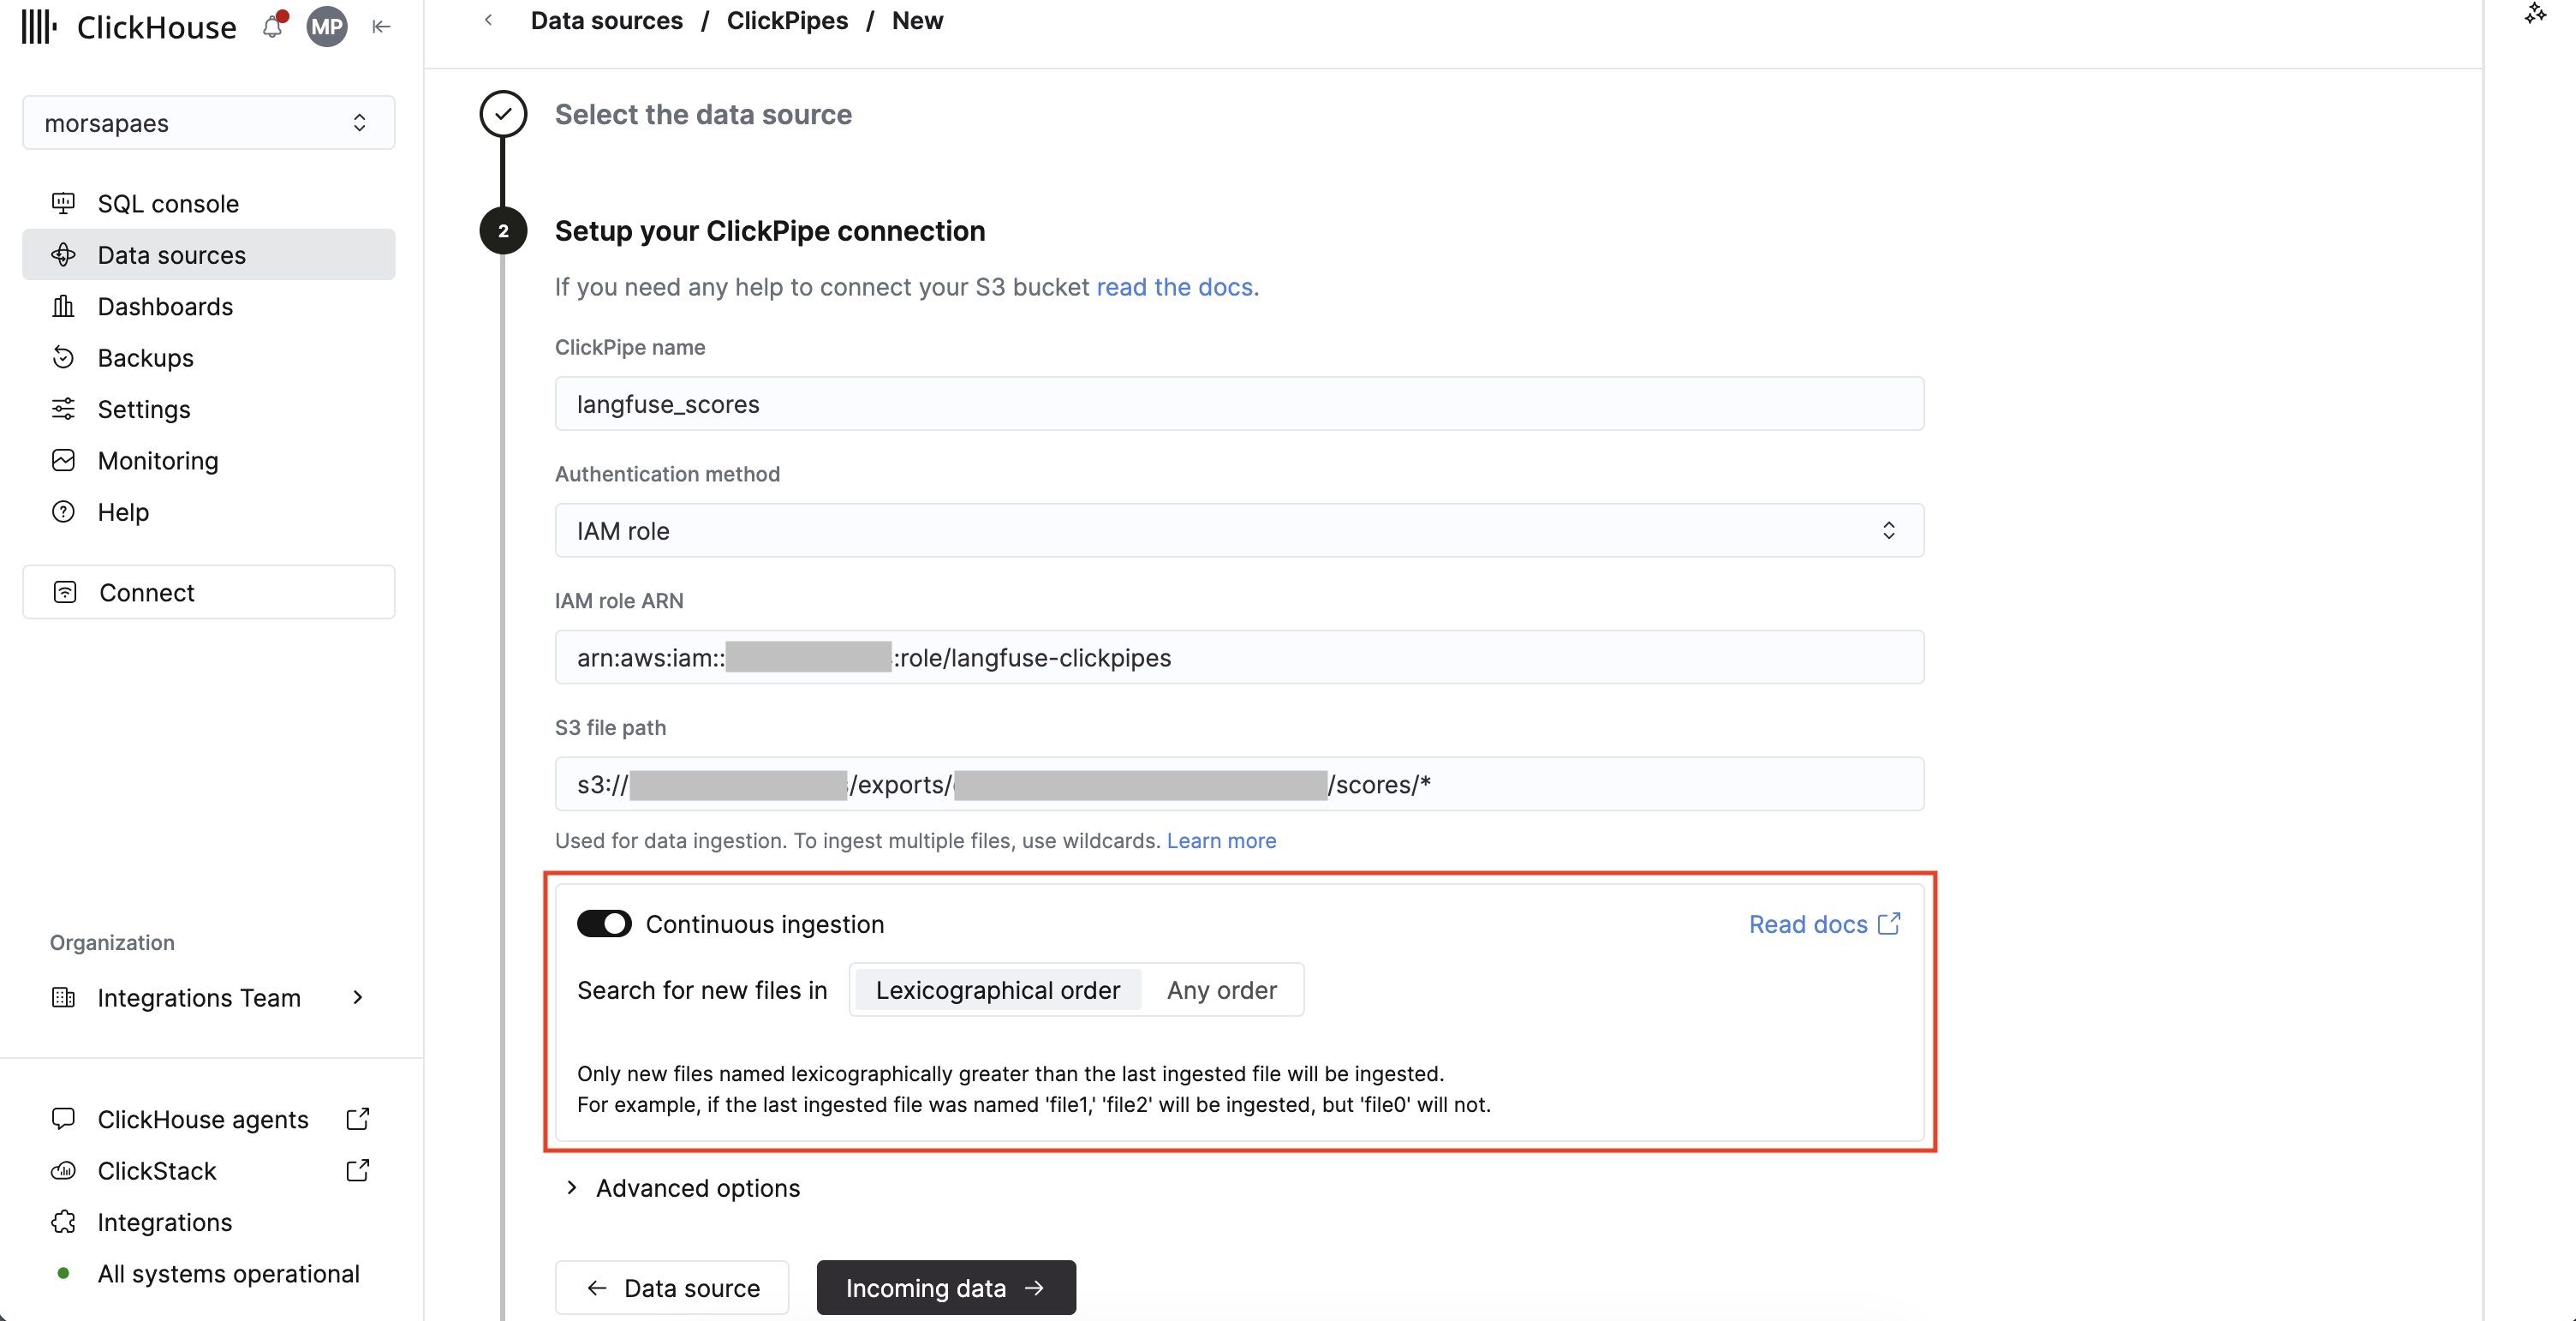
 **1.** 填写 ClickPipes 连接到接收 Langfuse Cloud 导出数据的桶并完成身份验证所需的详细信息。
* **Authentication method**:S3 ClickPipe 支持 [IAM 凭证](/zh/integrations/clickpipes/object-storage/amazon-s3/overview#iam-credentials) (`Credentials`) 和[基于 IAM role 的身份验证](/zh/integrations/clickpipes/object-storage/amazon-s3/overview#iam-role) (`IAM role`) 。ClickPipes 只需要该桶的读取权限。有关身份验证和权限配置的说明,请参阅[参考文档](/zh/integrations/clickpipes/object-storage/amazon-s3/overview#access-control)。
* **S3 文件路径**:将 ClickPipe 指向某个子目录,并使用 `*` 通配符匹配其中所有导出文件。由于各子目录下导出文件的 schema 各不相同,您**必须**为每个子目录分别创建一个 ClickPipe。
| 子目录 | 文件路径 |
| - | - |
| `observations_v2/` | `https://{bucket-name}.s3.{region-code}.amazonaws.com/{prefix}{project-id}/observations_v2/*` |
| `scores/` | `https://{bucket-name}.s3.{region-code}.amazonaws.com/{prefix}{project-id}/scores/*` |
有关支持的匹配模式 (包括如何跨嵌套前缀匹配文件) 的说明,请参阅[参考文档](/zh/integrations/clickpipes/object-storage/amazon-s3/overview#file-pattern-matching)。
**2.** 选择 **Continuous ingestion**,这样 Langfuse 每次向目标桶写入新文件时,这些文件都会被自动摄取。
 **3.** 点击 **Incoming data**。ClickPipes 将从您的桶中拉取元数据,并在下一步中推断 target table 的 schema。
**1.** ClickPipes 会连接到您的桶,列出指定路径下的文件,并自动推断文件格式。本示例使用的是 Langfuse Cloud 的默认导出文件格式 (Parquet) 。
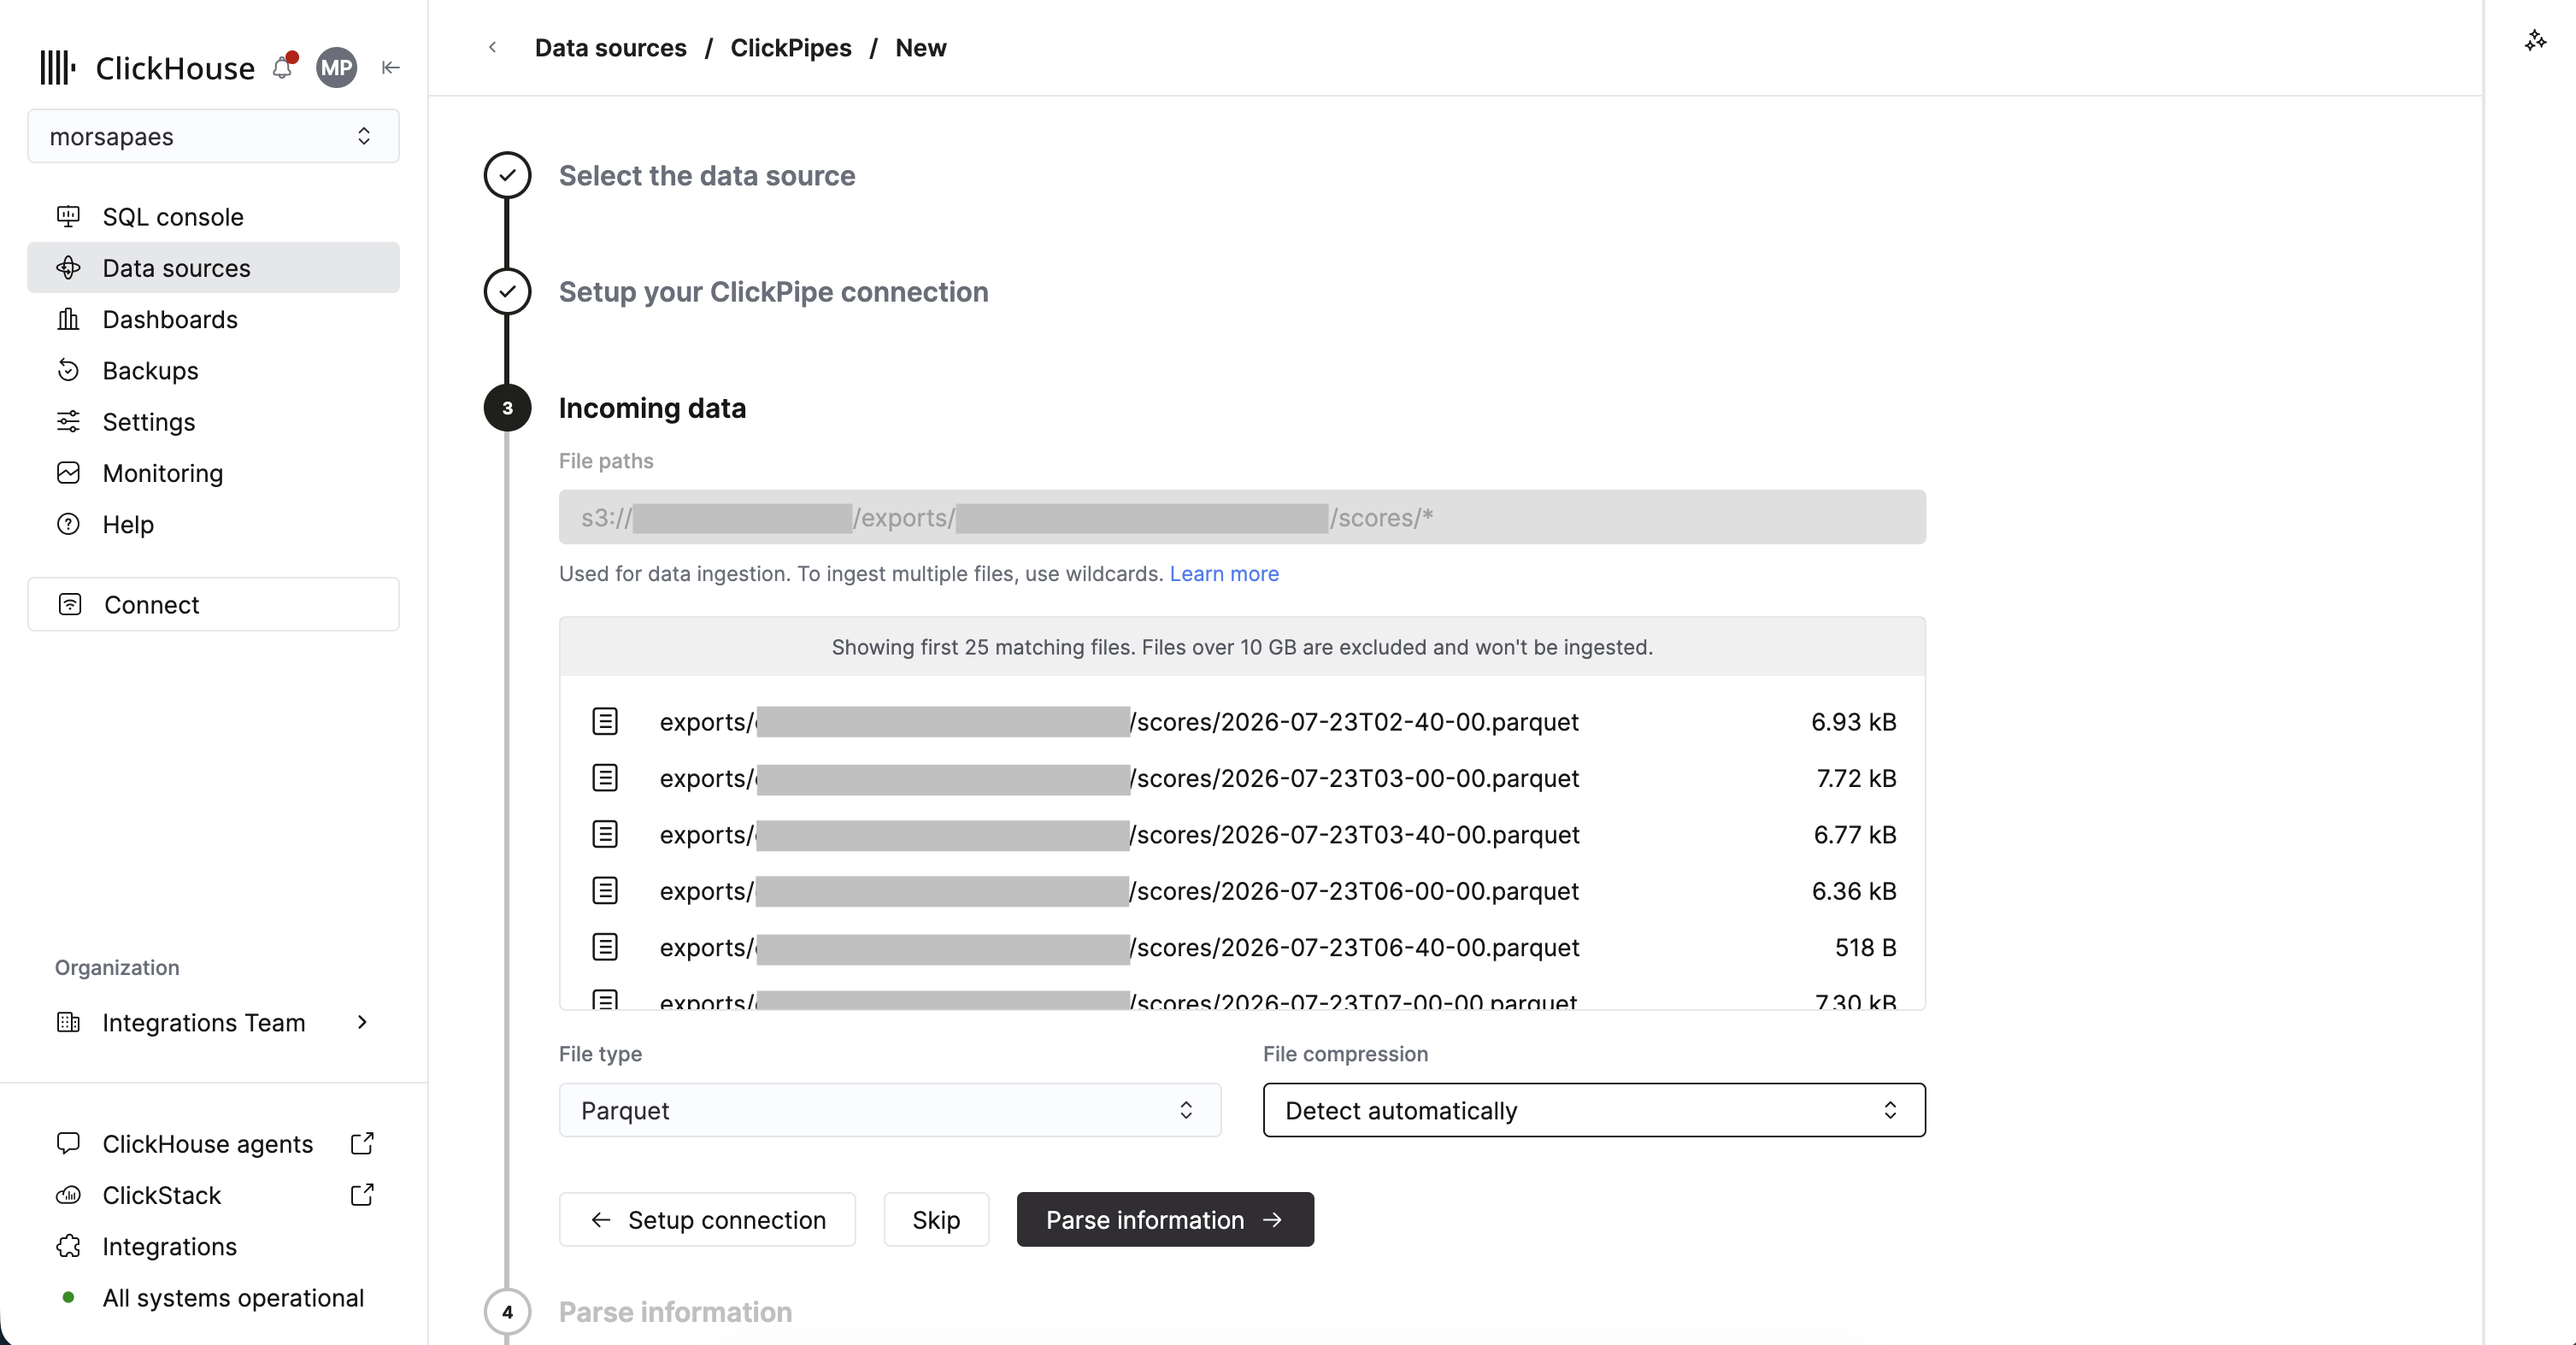 **2.** 点击 **Parse information**。ClickPipes 会使用一个样本文件推断导出数据的 schema,并自动将源字段映射到 ClickHouse target table。
**1.** 在此步骤中,您可以查看推断出的表结构,并自定义 target table 的配置,包括调整数据类型映射、定义 [sorting key](/zh/best-practices/choosing-a-primary-key),以及选择[表引擎](/zh/reference/engines/table-engines)。
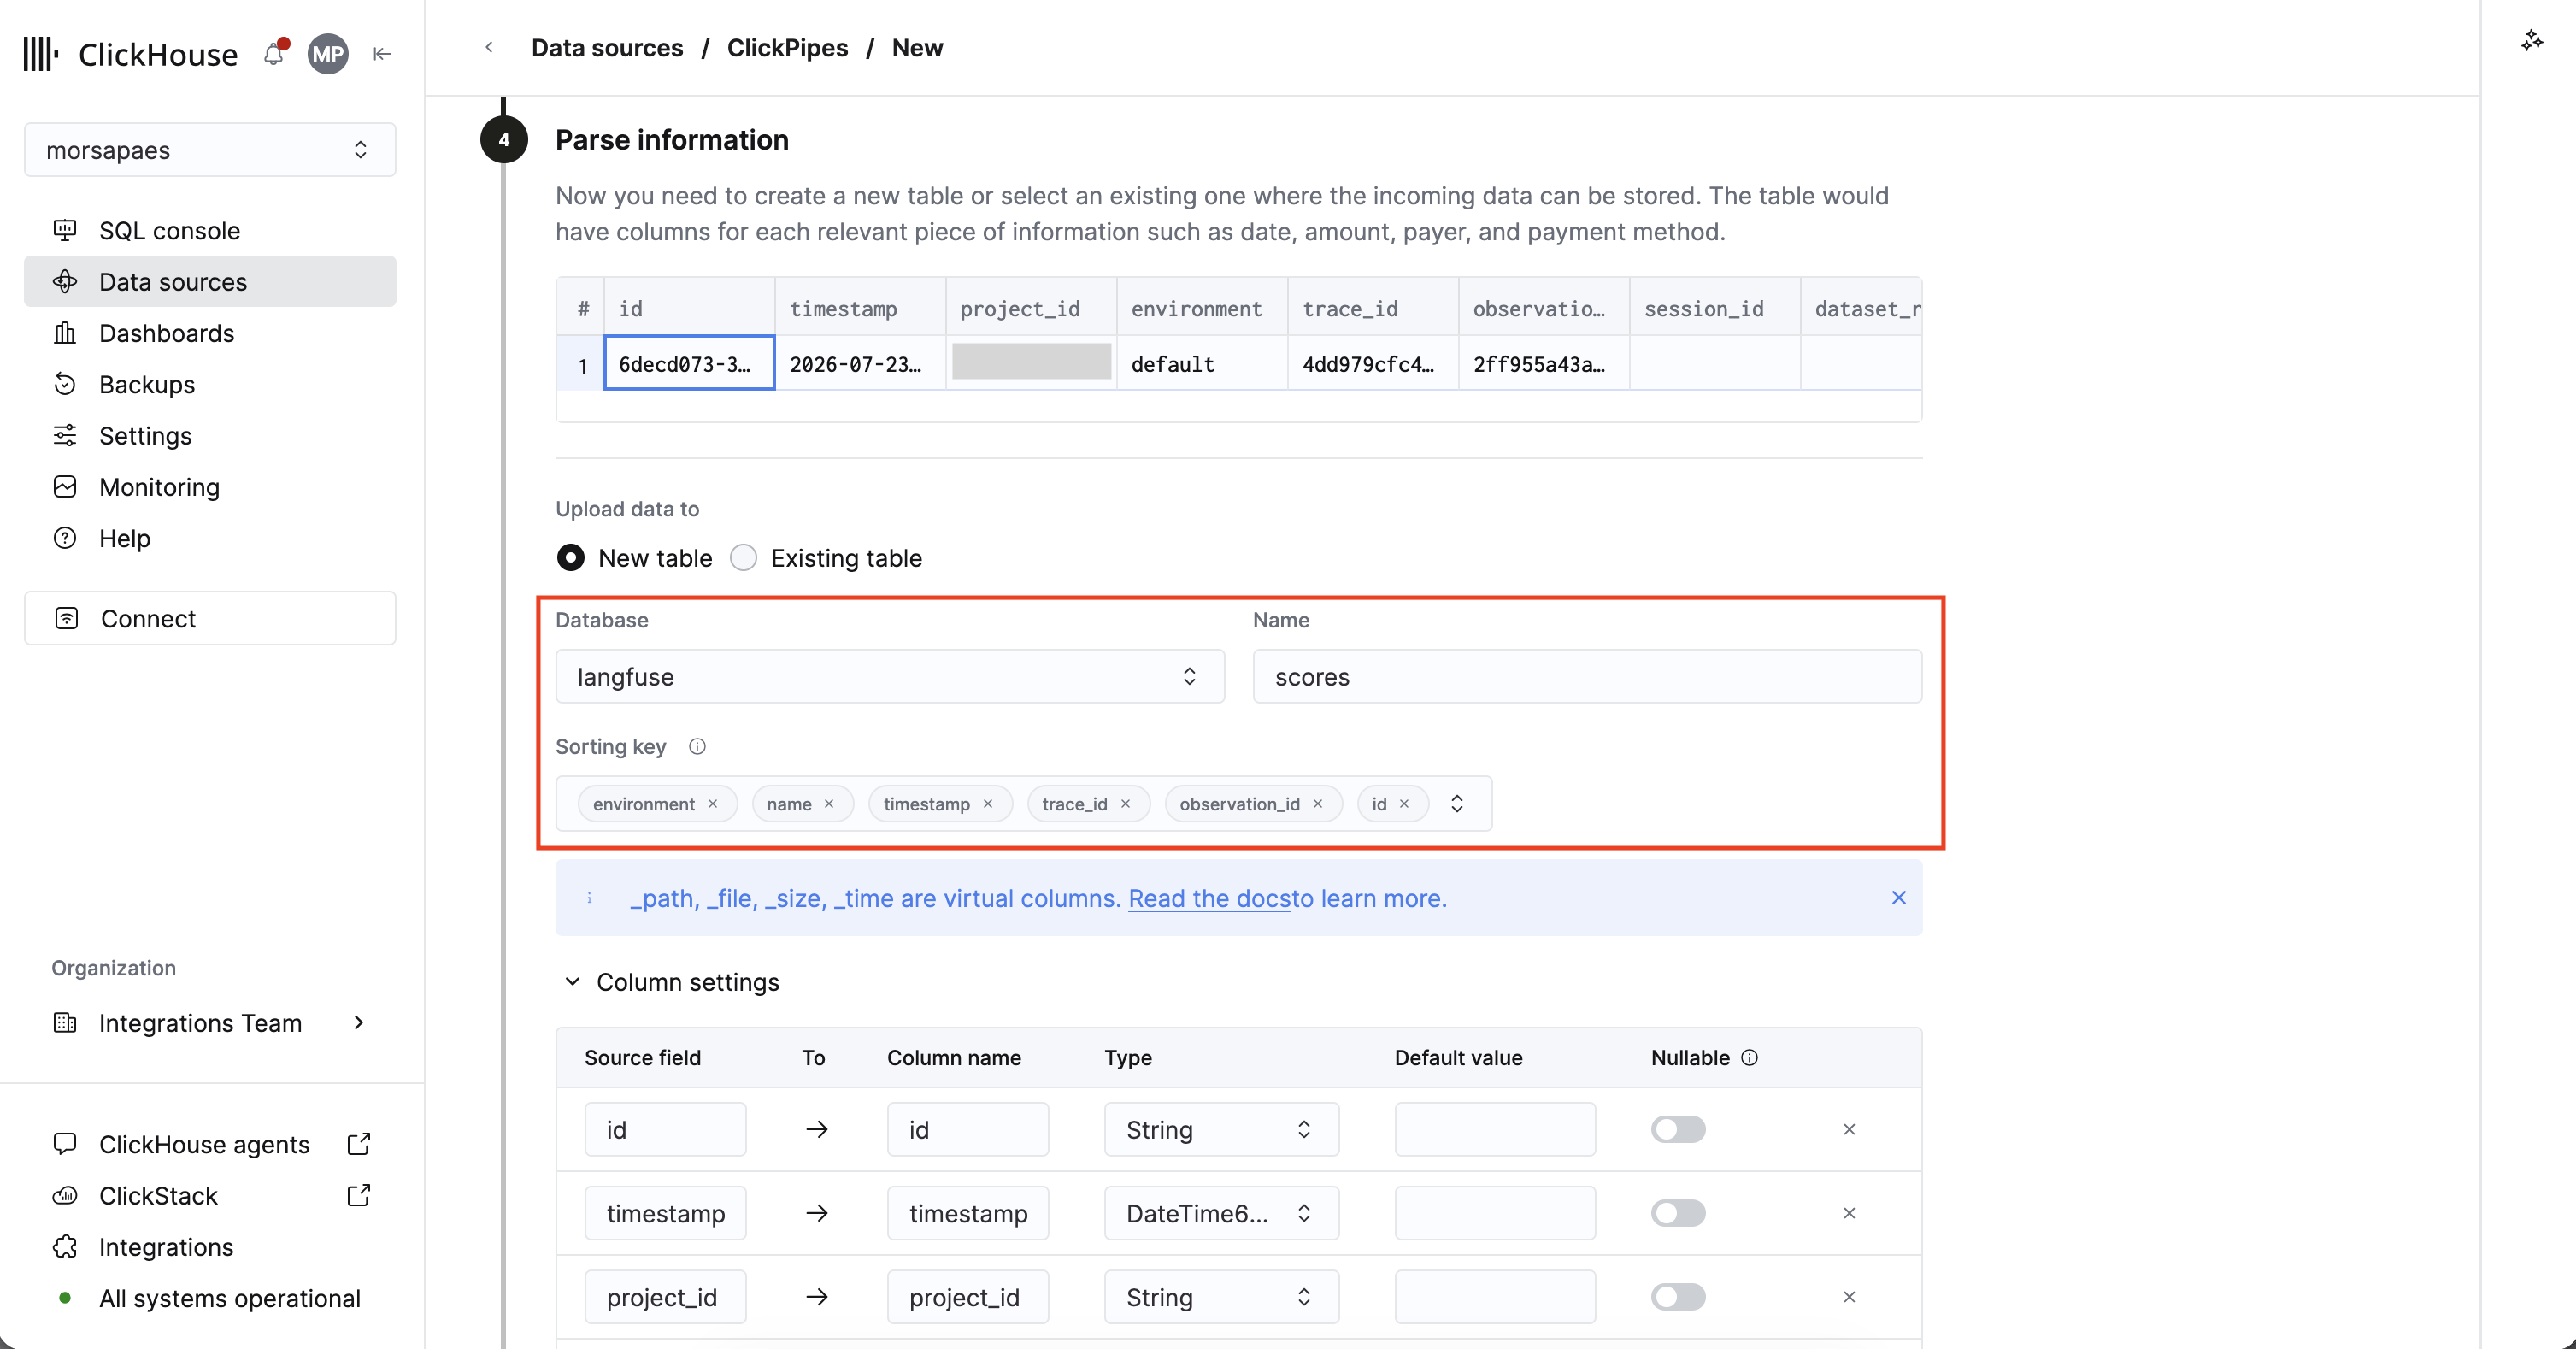 在 **Upload data to** 下,保持选中 **New table**,并进行如下设置:
* **Database** 和 **Name**:为 Langfuse 数据指定一个专用数据库 (例如 `langfuse`) ,并为目标表指定一个易于理解的名称 (例如 `scores`) 。ClickPipes 默认使用 `default.s3-`,以避免命名冲突。
* **Sorting key**:目标表的[排序键](/zh/best-practices/choosing-a-primary-key),决定了 ClickHouse 在磁盘上持久化数据的方式。为获得最佳性能,sorting key 应与您的数据访问模式相匹配,使查询能够尽可能多地跳过无需读取的数据。
| 子目录 | 目标表 | 建议的 sorting key |
| - | - | - |
| `observations_v2/` | `observations_v2` | `environment, start_time, trace_id, id` |
| `scores/` | `scores` | `environment, name, timestamp, trace_id, observation_id, id` |
在 `ReplacingMergeTree` 表中,该键还用于去重,因此这组列还必须能够唯一标识一条记录。如果您将**多个 Langfuse 项目**加载到同一张表中,请在 sorting key 的最前面添加 `project_id`。有关如何选择 sorting key,请参阅[参考文档](/zh/best-practices/choosing-a-primary-key)。
* **Partition by**:除非您计划让旧的链路追踪数据过期,否则请留空。ClickHouse 中的[分区](/zh/best-practices/choosing-a-partitioning-key)用于数据管理,而非查询优化;建议的 sorting key 已能对时间范围查询进行裁剪。如果确实需要数据保留策略,请按时间列分区 (`toYYYYMM(start_time)`,`scores` 则使用 `toYYYYMM(timestamp)`) ,这样只需执行一次 `DROP PARTITION` 操作即可清除一个月的链路追踪数据。
**2.** 接下来,展开 **Advanced settings**,将 **Engine** 设置为 [`ReplacingMergeTree`](/zh/engines/table-engines/mergetree-family/replacingmergetree) 以确保去重,并将 `updated_at` 用作 **Version** 列。
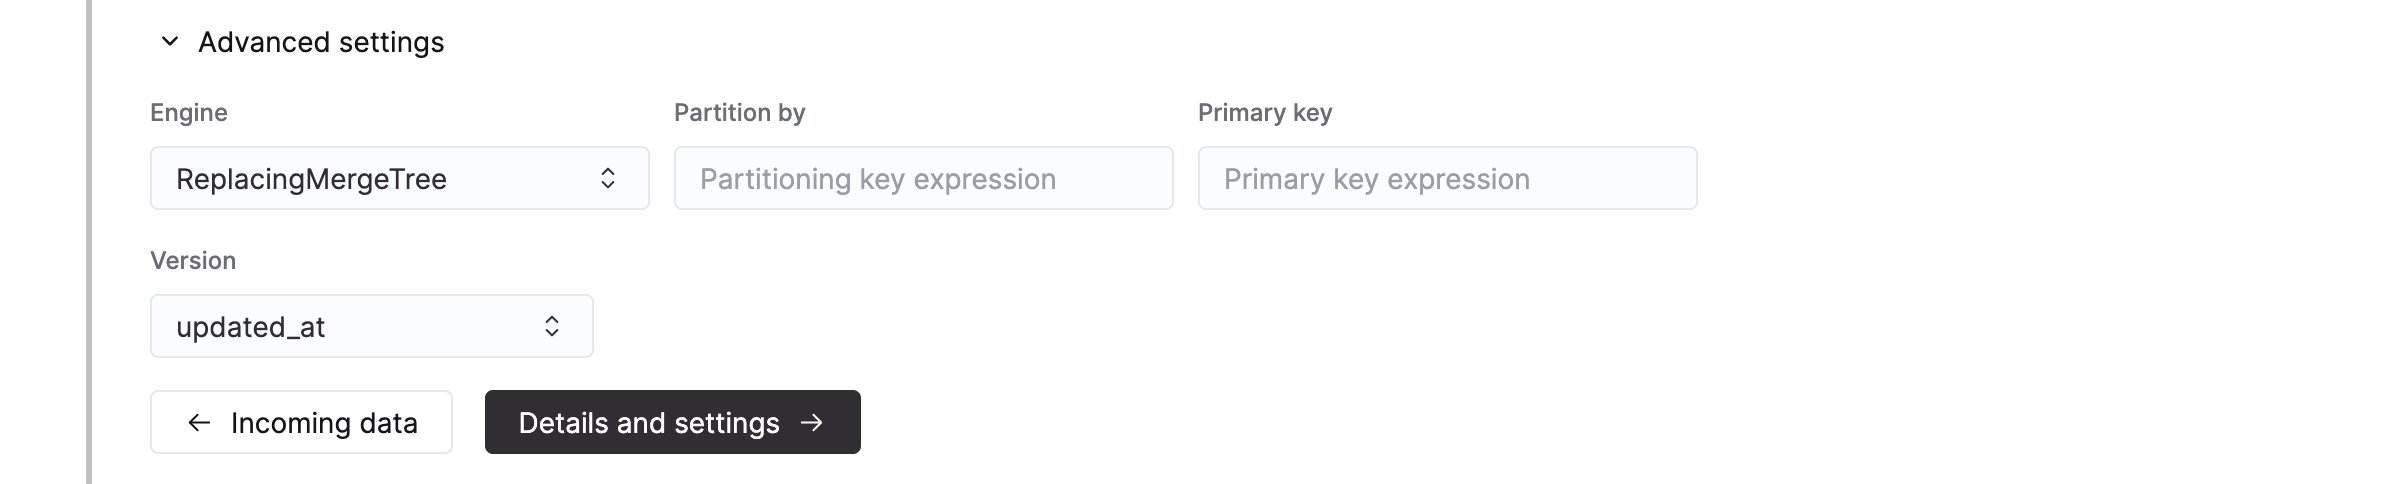 Langfuse Cloud Blob Storage 集成的导出时间窗口两端均为闭区间,因此同一条记录可能出现在多个导出文件中。除非您的分析查询模式是幂等的 (例如 `uniq()`、`max()`、`min()`) ,否则您**必须**在下游数据模型中处理去重,即使用 `ReplacingMergeTree` 作为目标引擎。
**使用 ReplacingMergeTree 去重**
该表引擎通过后台合并来折叠重复数据。若要在读取时实现完全去重 (即读时合并语义) ,您**必须**在查询时使用 `FINAL` 修饰符 (或 `argMax()` 类聚合) 。
ClickPipes 会创建一个专用用户,用于向目标表写入数据。你可以为该内部用户指定一个自定义角色,或选择以下预定义角色之一:
* `Full access`:拥有集群的完全访问权限。如果目标表关联了 materialized view 或字典,则必须选择此角色。
* `Only destination table`:仅拥有目标表的 `INSERT` 权限。
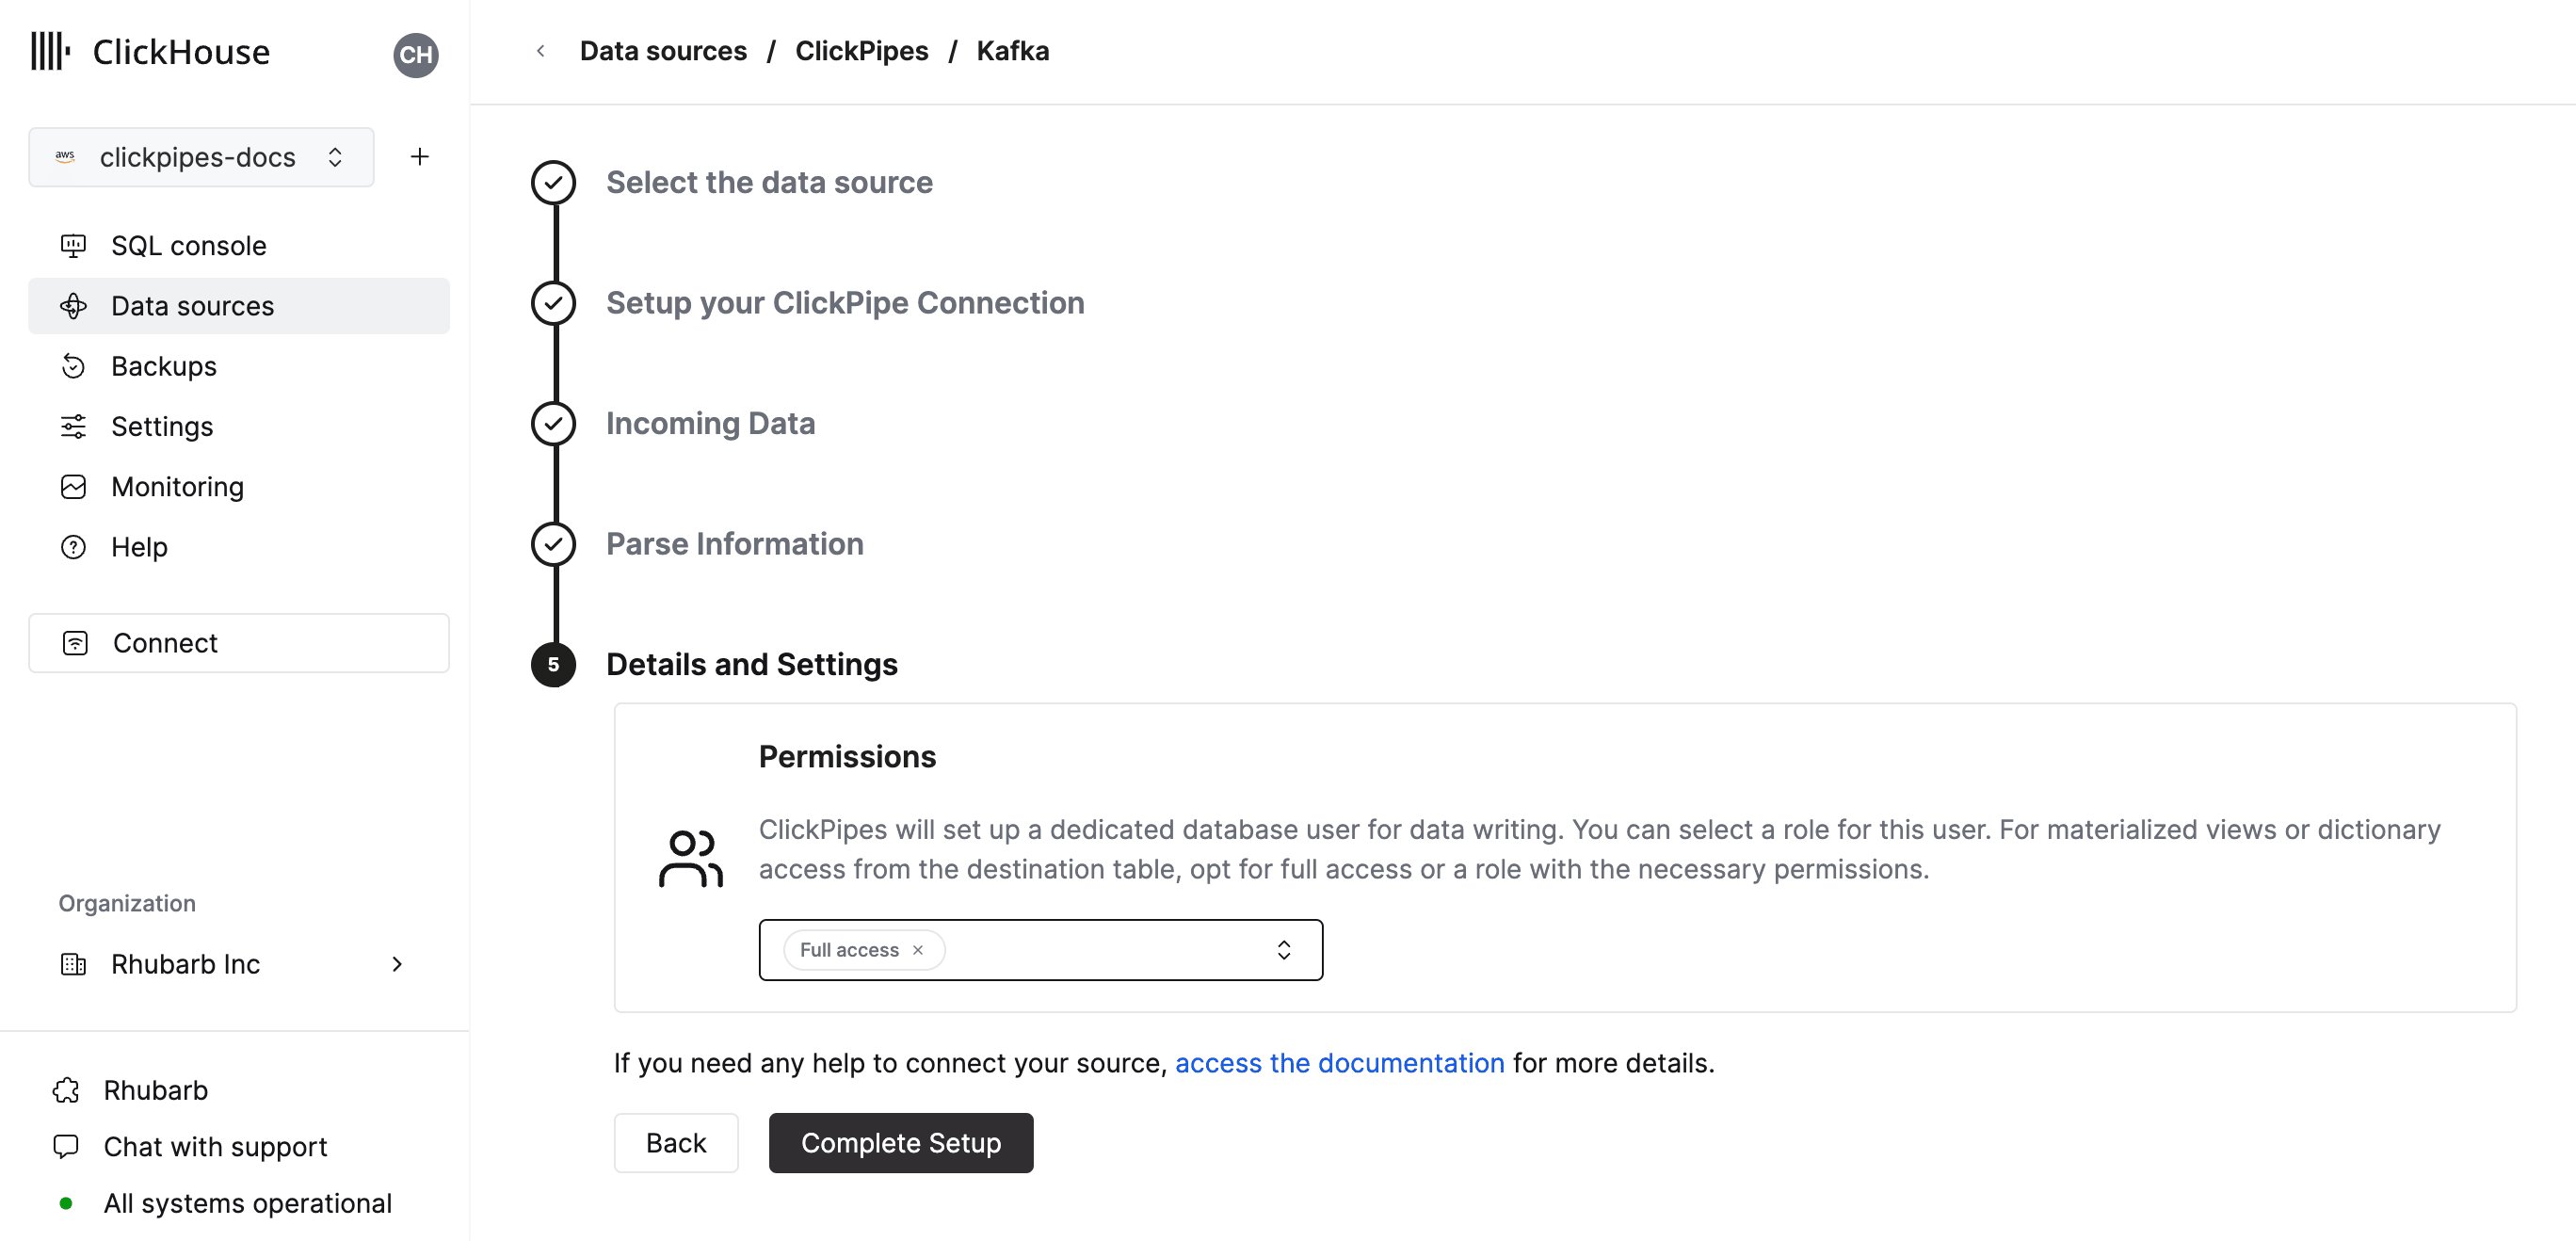 点击 **Complete setup** 即可创建 ClickPipe。
至此,一切就绪!ClickPipes 会先对指定路径中的所有文件执行历史数据回填,之后每当有新文件写入桶中,便会开始摄取这些文件。
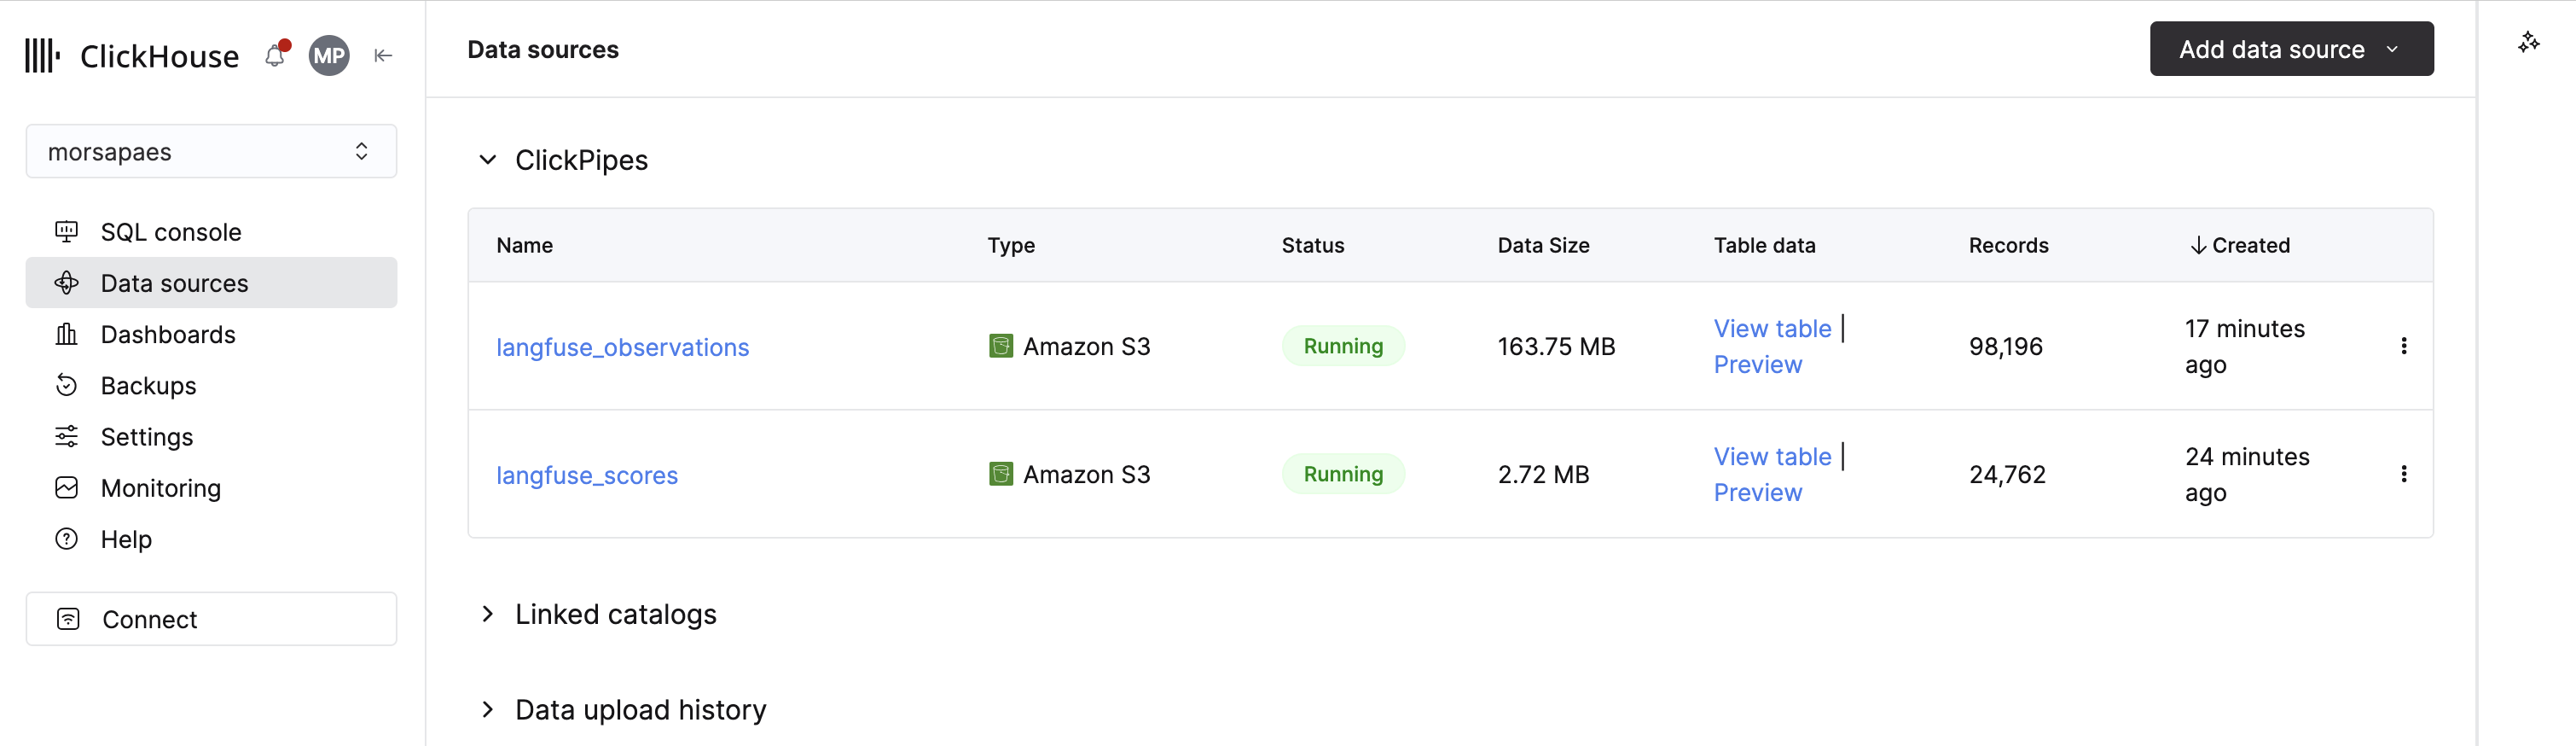 如需将其他子目录导入 ClickHouse Cloud,请针对每个子目录重复本指南中的步骤。
查询链路追踪数据
ClickPipes 启动并正常运行后,即可直接在 ClickHouse Cloud 中查询 Langfuse Cloud 的链路追踪数据。以下示例涵盖了几种常见的查询模式:成本与延迟汇总、还原单个 trace,以及将评分与模型和提示词进行关联分析。
按时间分桶的指标汇总
部分字段 (例如 `usage_details` 和 `cost_details`) 以 `Map` 列的形式导出。可通过键查找读取单个值 (例如 `sum(cost_details['total'])`) 。
```sql theme={null}
SELECT
toStartOfHour(start_time) AS t,
provided_model_name,
count() AS spans,
quantile(0.95)(latency) AS p95_latency,
sum(total_cost) AS cost,
sum(usage_details['total']) AS tokens
FROM observations_v2 FINAL
WHERE start_time >= now() - INTERVAL 7 DAY
-- AND environment = ''
GROUP BY t, provided_model_name
ORDER BY t;
```
trace 重建
```sql theme={null}
SELECT *
FROM observations_v2 FINAL
WHERE trace_id = ''
ORDER BY start_time;
```
质量分析
```sql theme={null}
SELECT
o.provided_model_name,
s.name,
avg(s.value) AS avg_score
FROM "s3-26237f63-84dc-4a7d-a0e1-7361cf55ee0b" AS s FINAL
JOIN "s3-80899034-ce1e-4dc9-a4e6-b059ddec4175" AS o FINAL ON s.trace_id = o.trace_id
--WHERE s.environment = ''
GROUP BY o.provided_model_name, s.name
ORDER BY avg_score DESC;
```
另请参见
* [Langfuse 与 ClickHouse](/zh/products/cloud/features/ai-ml/langfuse)
* [Langfuse Cloud blob 存储导出](https://langfuse.com/docs/api-and-data-platform/features/export-to-blob-storage)
* [适用于对象存储的 ClickPipes](/zh/integrations/clickpipes/object-storage/amazon-s3/overview)