> ## Documentation Index
> Fetch the complete documentation index at: https://private-7c7dfe99-vortex-format.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
> Importe e exporte dados do Postgres para uma ampla variedade de formatos de dados e armazenamentos de objetos.
# Documentação de referência da extensão chdb
Introdução
Esta biblioteca fornece extensões do PostgreSQL para executar consultas [chDB] no
Postgres e para copiar dados de e para diversos formatos e armazenamentos de objetos.
Extensão chdb
A extensão `chdb` executa consultas [chDB]. A função `chdb_query()` executa
uma única consulta. Por exemplo, esta consulta:
```sql theme={null}
SELECT * FROM chdb_query($$
SELECT * FROM s3('s3://datasets-documentation/my-test-bucket-768/some_prefix/some_file_1.csv')
$$) AS (id int, months int, days int);
```
Saída:
```
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(3 rows)
```
Consulte a [documentação do chdb](/pt-BR/products/managed-postgres/extensions/chdb/chdb)
para mais detalhes.
Módulo chdb\_hook
O módulo `chdb_hook` se conecta ao comando [COPY] para copiar dados de ou para
o S3, o GCS, o Azure Blob, um arquivo ou uma URL http. Este exemplo carrega registros de
vários arquivos CSV no S3 em um único comando [COPY]:
```sql theme={null}
CREATE TABLE times (
id INT NOT NULL,
months INT NOT NULL,
days INT NOT NULL
);
LOAD 'chdb_hook';
COPY times FROM 's3://datasets-documentation/my-test-bucket-768/{some,another}_prefix/some_file_{1..3}.csv';
```
Depois disso, a tabela `times` contém os registros de cada arquivo carregado:
```pgsql theme={null}
# SELECT * FROM times;
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(18 rows)
```
Um [CREATE TABLE] também pode derivar suas colunas e carregar suas linhas a partir de uma
URL desse tipo:
```sql theme={null}
CREATE TABLE reviews () WITH (
copy_from = 'https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet'
);
```
Consulte a [documentação do chdb\_hook](/pt-BR/products/managed-postgres/extensions/chdb/chdb_hook)
para mais detalhes.
Um [benchmark] compara o desempenho do `COPY` do \[chdb\_hook] com o de
\[aws\_s3], \[pg\_duckdb] e \[pg\_lake] para cerca de 1 milhão de linhas do [NYC Taxi dataset] em
diversos formatos.
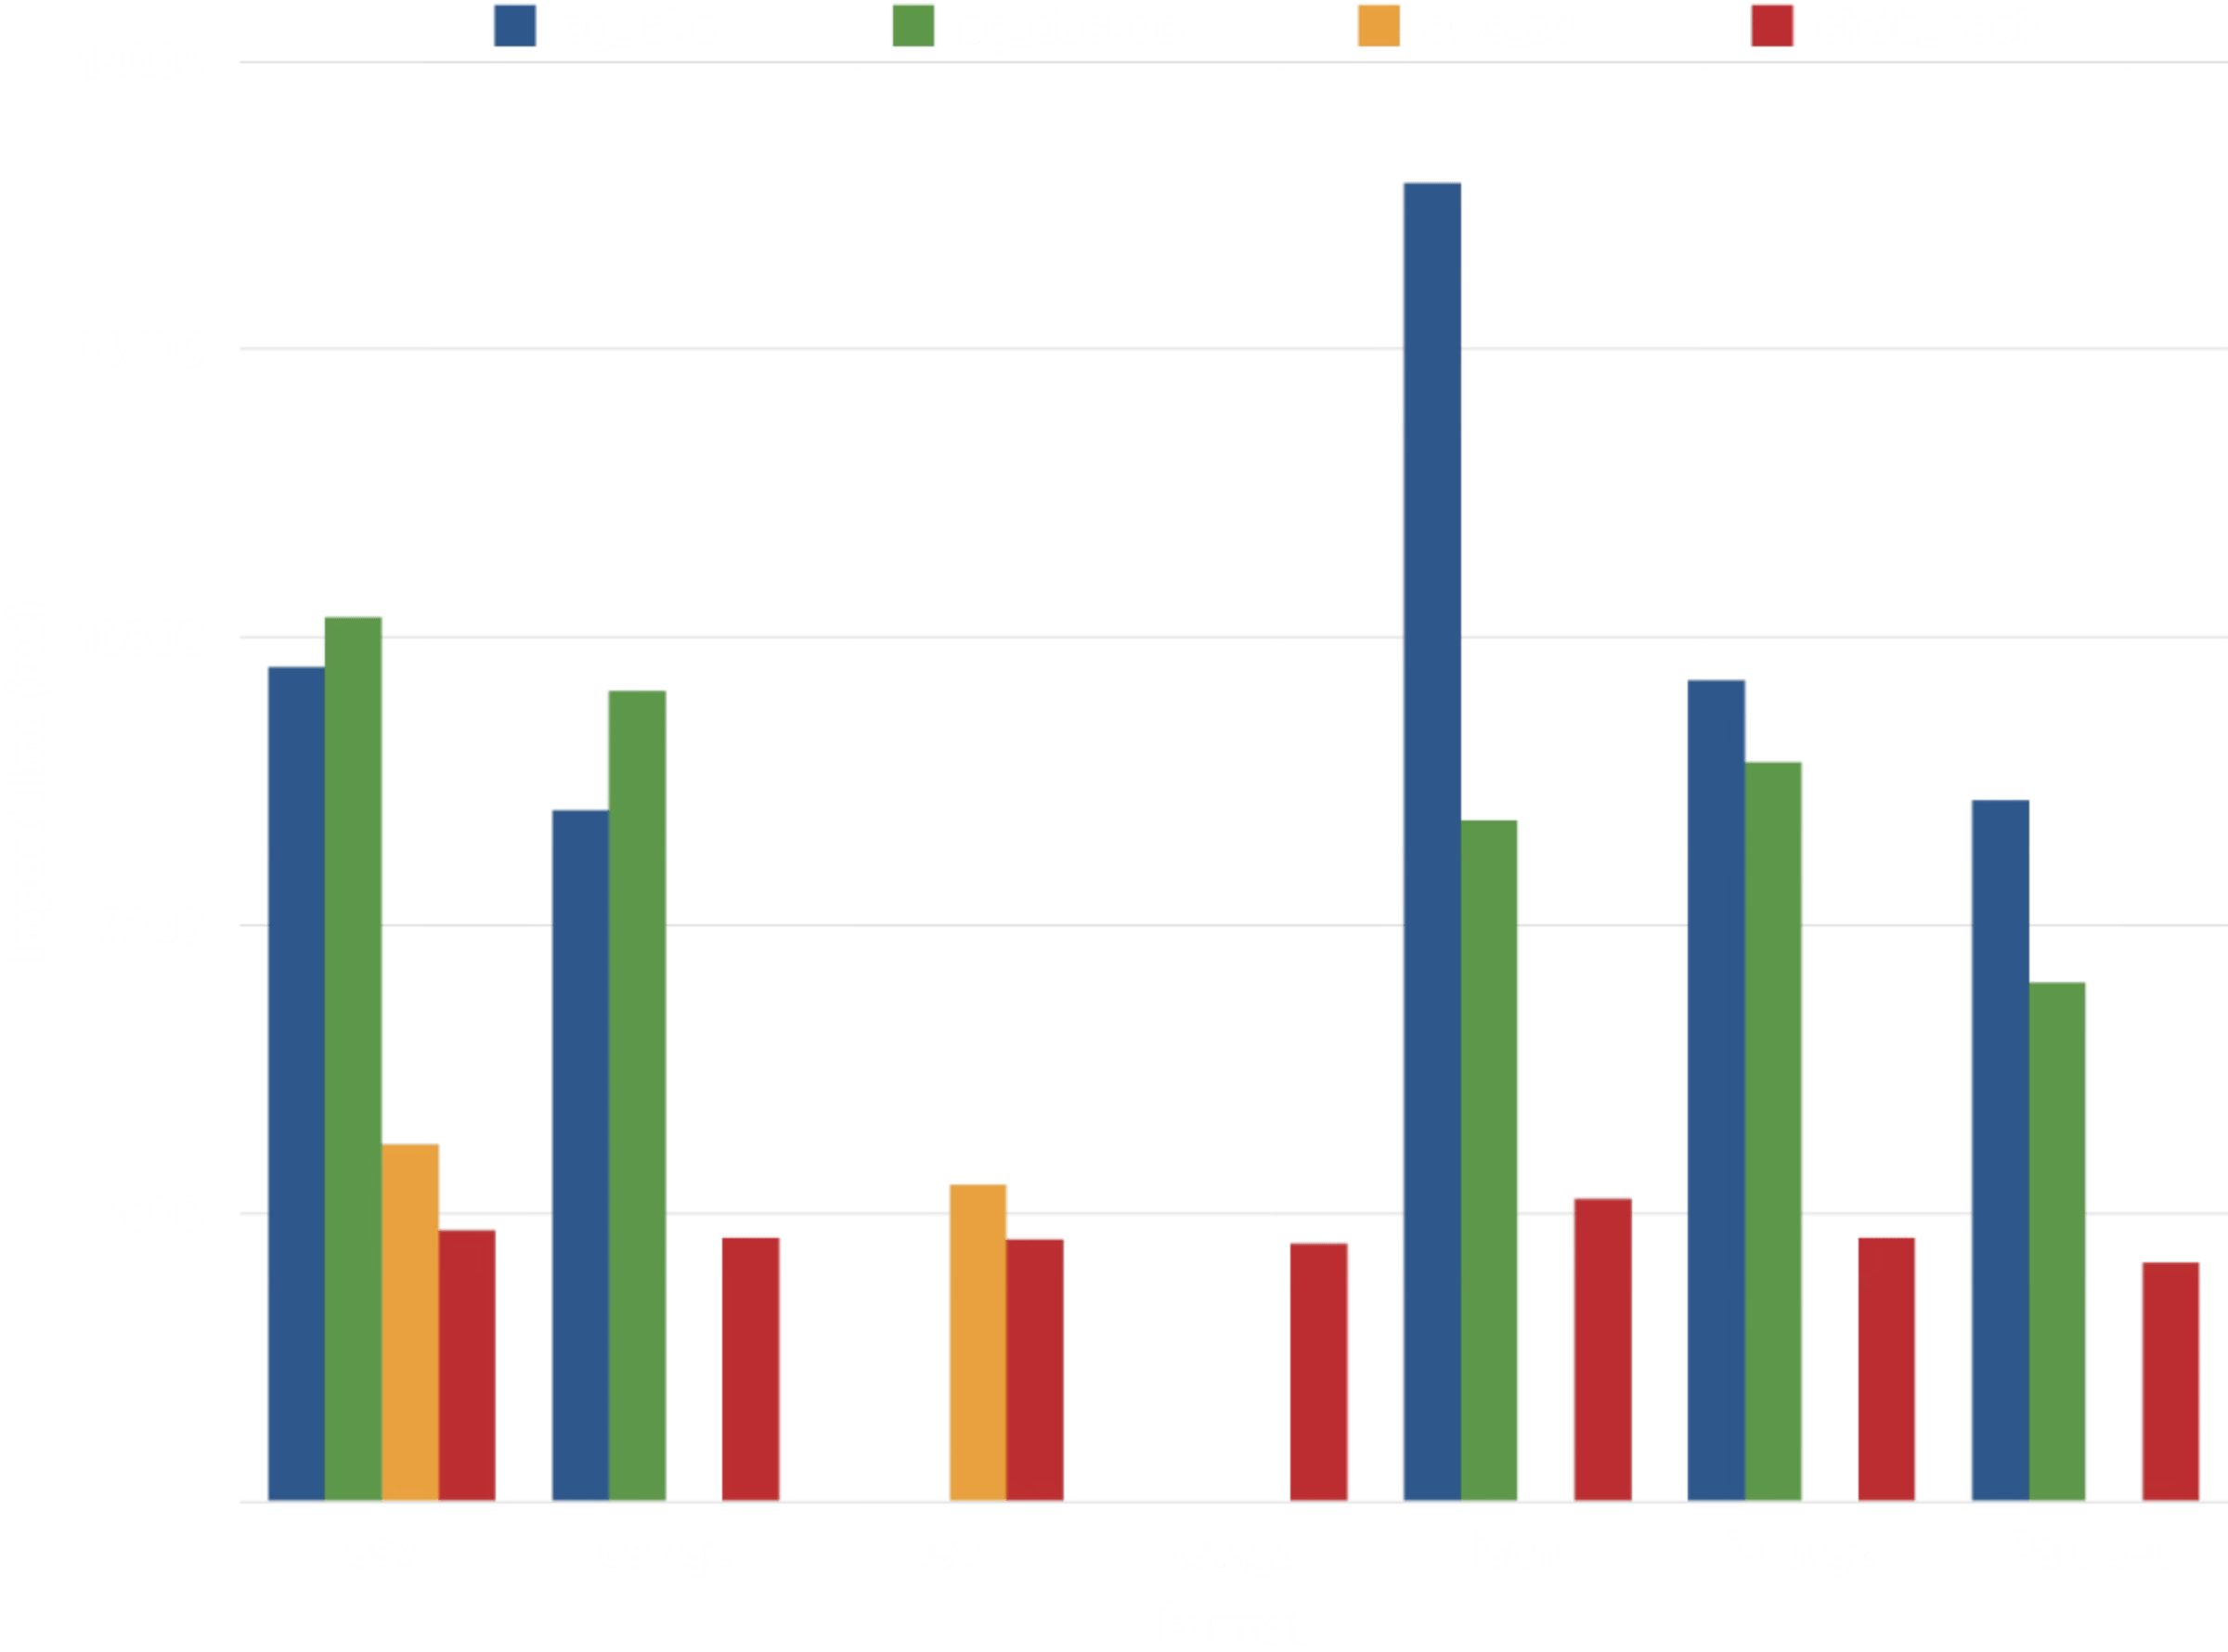 Das quatro extensões, o [chdb] apresenta o desempenho mais consistente.
\[pg\_duckdb] e \[pg\_lake], ambos baseados no [DuckDB], levam de 2 a 3 vezes mais tempo
para importar dados em CSV, JSON e Parquet. Apenas o \[aws\_s3] se aproxima
do desempenho do \[chdb\_hook], mas oferece suporte a um conjunto bem mais limitado de formatos
de dados:
| Extensão | Compressão | Formatos de dados |
| - | - | - |
| aws\_s3 | nenhuma | Texto (TSV), CSV, Postgres Binary |
| pg\_lake | gzip, zstd, snappy (apenas Parquet) | CSV, JSON, Parquet |
| pg\_duckdb | gzip, zstd, snappy (apenas Parquet) | CSV, JSON, Parquet |
| chdb | gzip, zstd, lz4, bz2, snappy, brotli | TSV, CSV, JSON, BSON, Prometheus, Protobuf, Avro, Parquet, Arrow, XML, CapnProto, Markdown, MsgPack, ORC e [muito mais][formats]! |
Benchmarkings adicionais mostram um desempenho relativamente consistente na
importação do [NYC Taxi dataset] em diversos formatos:
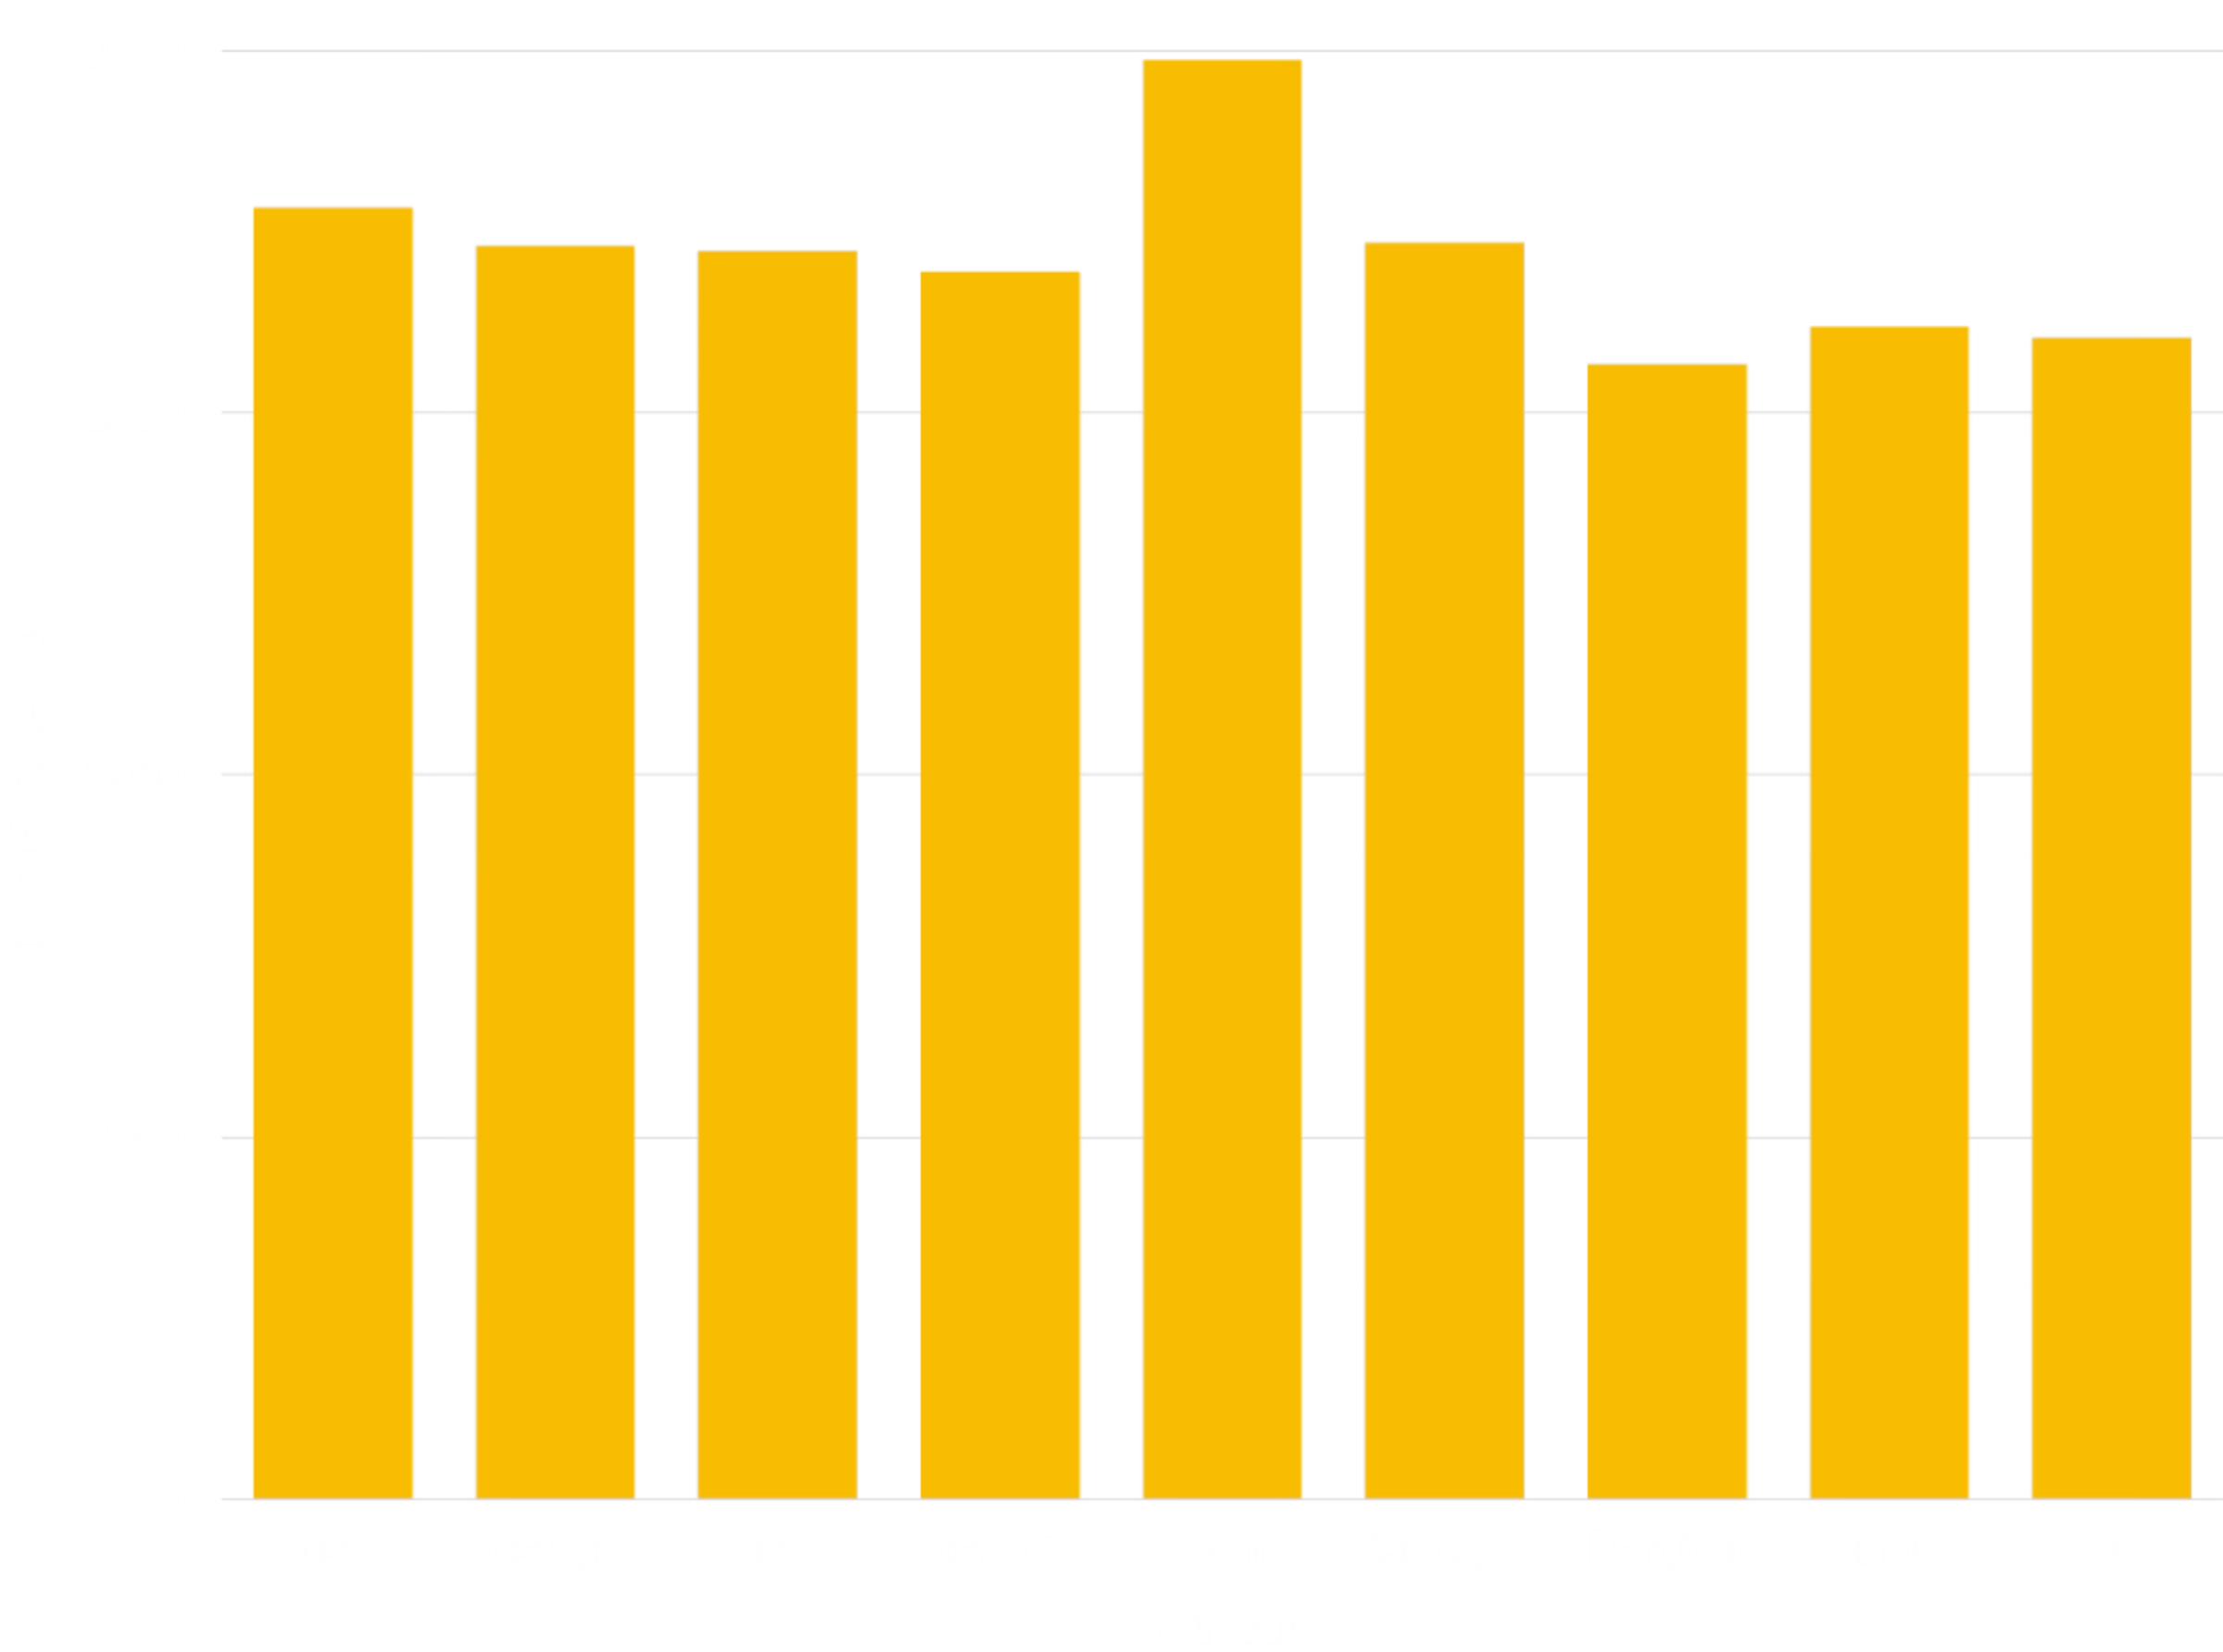 O benchmark usa o formato [JSONCompact] para manter a compatibilidade com as outras
extensões; outros formatos JSON, como o [JSONCompactEachRow], chegam mais
perto do desempenho dos demais formatos.
Arquitetura
As extensões chdb e chdb\_hook dependem de um processo `chdb_helper` para executar
consultas [chDB]. O helper mantém o consumo de recursos do [chDB] separado
do processo principal do Postgres, o que é uma vantagem para fluxos de trabalho de uso ocasional,
como o carregamento de dados de um lago de dados.
```
+-------------+
| helper |
+----------+ | app | +------+
| Postgres | | +---------+ | | chDB |
| Backend |----->| | chDB | |----->| Data |
+----------+ | | Library | | +------+
| +---------+ |
+-------------+
```
Diferentemente de um worker em background, o helper não mantém memória compartilhada do Postgres
e o postmaster não o gerencia. Isso isola falhas, evitando que afetem o Postgres.
Um helper que morre gera um erro apenas no backend que o iniciou,
deixando as demais sessões intactas.
Para cada consulta, o helper se conecta a um novo banco de dados chDB temporário em disco
para executá-la. Como consequência, atualmente cada consulta é executada em total
isolamento de todas as outras. Não crie uma tabela esperando consultá-la
em uma consulta subsequente.
Dependências
A extensão `chdb` requer o PostgreSQL 15 ou superior e a library [chDB]
v26.7.0 ou superior (atualmente disponível apenas para Linux e macOS). A
maneira mais simples de instalá-la é por meio do script de shell [lib.chdb.io]:
```sh theme={null}
curl -sL https://lib.chdb.io | bash
```
Para compilar estaticamente o [chDB] no aplicativo auxiliar, defina as seguintes variáveis
antes de executar os comandos `make` da
[Instalação](#compile-from-source).
```sh theme={null}
export BUNDLE_LIBCHDB=1 LIBCHDB_BUILD=static
```
O `Makefile` fará o download da biblioteca estática `libchdb` e a compilará
no aplicativo.
No Linux, você também pode fazer com que o processo de instalação baixe e instale a
biblioteca dinâmica `libchdb`, definindo `export BUNDLE_LIBCHDB=1` antes de executar
os comandos `make` da [Instalação](#compile-from-source).
Compilar a partir do código-fonte
Para compilar o chdb, basta fazer o seguinte:
```sh theme={null}
make
make installcheck
make install
```
Se você encontrar um erro como:
```
"Makefile", line 8: Need an operator
```
Você precisa usar o GNU make, que provavelmente já está instalado no seu sistema como
`gmake`:
```sh theme={null}
gmake
gmake install
gmake installcheck
```
Se você encontrar um erro como:
```
make: pg_config: Command not found
```
Certifique-se de que o `pg_config` esteja instalado e disponível no seu path. Se
você usou um sistema de gerenciamento de pacotes como o RPM para instalar o PostgreSQL,
verifique se o pacote `-devel` também está instalado. Se necessário, informe ao processo de compilação
onde encontrá-lo:
```sh theme={null}
env PG_CONFIG=/path/to/pg_config make && make installcheck && make install
```
Se você encontrar um erro como:
```
chdb_helper.c:22:10: fatal error: 'chdb.h' file not found
```
Você precisa instalar o [chDB] ou informar ao compilador onde encontrá-lo. Se,
por exemplo, você o instalou pelo script de shell [lib.chdb.io], aponte para
`/usr/local`:
```sh theme={null}
make CFLAGS=-I/usr/local/include \
LDFLAGS=-L/usr/local/lib
```
Se você encontrar um erro como:
```
ERROR: must be owner of database regression
```
É necessário executar o conjunto de testes com um superusuário, como o superusuário
padrão "postgres":
```sh theme={null}
make installcheck PGUSER=postgres
```
Para instalar a extensão em um prefixo personalizado no PostgreSQL 18 ou posterior, passe o argumento `prefix` para `install` (mas para nenhum outro target do `make`):
```sh theme={null}
make install prefix=/usr/local/extras
```
Em seguida, certifique-se de que o prefixo esteja incluído nos seguintes \[parâmetros do
`postgresql.conf`]:
```ini theme={null}
extension_control_path = '/usr/local/extras/postgresql/share:$system'
dynamic_library_path = '/usr/local/extras/postgresql/lib:$libdir'
```
Autores
* [David E. Wheeler](https://justatheory.com/)
* [serprex](https://github.com/serprex)
Direitos autorais
Copyright (c) 2026, ClickHouse
[chDB]: https://clickhouse.com/chdb "chDB - banco de dados in-process rápido, confiável e escalável"
[COPY]: https://www.postgresql.org/docs/current/sql-copy.html "Documentação do Postgres: COPY"
[CREATE TABLE]: https://www.postgresql.org/docs/current/sql-createtable.html "Documentação do Postgres: CREATE TABLE"
[lib.chdb.io]: https://lib.chdb.io "curl -sL https://lib.chdb.io | bash"
[`postgresql.conf` parameters]: https://www.postgresql.org/docs/devel/runtime-config-client.html#RUNTIME-CONFIG-CLIENT-OTHER
[chdb_hook]: https://pgxn.org/dist/chdb/doc/chdb_hook.html "Documentação do chdb_hook no PGXN"
[aws_s3]: https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/USER_PostgreSQL.S3Import.html "Importando dados do Amazon S3 para uma instância de banco de dados RDS para PostgreSQL"
[pg_duckdb]: https://github.com/duckdb/pg_duckdb "Postgres com DuckDB para aplicações e analytics de alto desempenho"
[pg_lake]: https://github.com/Snowflake-Labs/pg_lake "pg_lake: Postgres com Iceberg e acesso a lago de dados"
[formats]: https://clickhouse.com/docs/reference/formats/index "Documentação do ClickHouse: Formatos para dados de entrada e saída"
[NYC Taxi dataset]: /get-started/sample-datasets/nyc-taxi "Documentação do ClickHouse: Dados de táxis de Nova York"
[benchmark]: https://github.com/ClickHouse/pg_chdb/tree/main/dev/benchmark "Postgres Lake Copy Benchmark"
[JSONCompact]: /reference/formats/JSON/JSONCompact "Documentação do ClickHouse: JSONCompact"
[JSONCompactEachRow]: /reference/formats/JSON/JSONCompactEachRow "Documentação do ClickHouse: JSONCompactEachRow"
[DuckDB]: https://duckdb.org "DuckDB: sua ferramenta universal de manipulação de dados"