> ## Documentation Index
> Fetch the complete documentation index at: https://private-7c7dfe99-vortex-format.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
> Postgres から多様なデータフォーマットやオブジェクトストアへ、データをインポート・エクスポートします。
# chdb 拡張機能リファレンスドキュメント
はじめに
このライブラリは、Postgres 上で [chDB] クエリを実行したり、さまざまなフォーマットやオブジェクトストアとの間でデータをコピーしたりするための PostgreSQL 拡張機能を提供します。
chdb 拡張機能
`chdb` 拡張機能は [chDB] のクエリを実行します。`chdb_query()` 関数は単一のクエリを実行します。たとえば、次のクエリの場合:
```sql theme={null}
SELECT * FROM chdb_query($$
SELECT * FROM s3('s3://datasets-documentation/my-test-bucket-768/some_prefix/some_file_1.csv')
$$) AS (id int, months int, days int);
```
Output:
```
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(3 rows)
```
詳細については、[chdb のドキュメント](/ja/products/managed-postgres/extensions/chdb/chdb)を参照してください。
chdb\_hook モジュール
`chdb_hook` モジュールは [COPY] コマンドにフックし、S3、GCS、Azure Blob、ファイル、http URL との間でデータをコピーします。次の例では、S3 上にある複数の CSV ファイルのレコードを、1 つの [COPY] コマンドで読み込みます:
```sql theme={null}
CREATE TABLE times (
id INT NOT NULL,
months INT NOT NULL,
days INT NOT NULL
);
LOAD 'chdb_hook';
COPY times FROM 's3://datasets-documentation/my-test-bucket-768/{some,another}_prefix/some_file_{1..3}.csv';
```
その後、`times` テーブルには読み込まれた各ファイルのレコードが格納されます:
```pgsql theme={null}
# SELECT * FROM times;
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(18 rows)
```
[CREATE TABLE] でも、そのような URL からカラムを導出し、行を読み込むことができます:
```sql theme={null}
CREATE TABLE reviews () WITH (
copy_from = 'https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet'
);
```
詳細については [chdb\_hook のドキュメント](/ja/products/managed-postgres/extensions/chdb/chdb_hook)
を参照してください。
[ベンチマーク][benchmark]では、[NYC Taxi dataset] の約 100 万行をさまざまなフォーマットで扱った場合の \[chdb\_hook] の `COPY` のパフォーマンスを、\[aws\_s3]、\[pg\_duckdb]、\[pg\_lake] と比較しています。
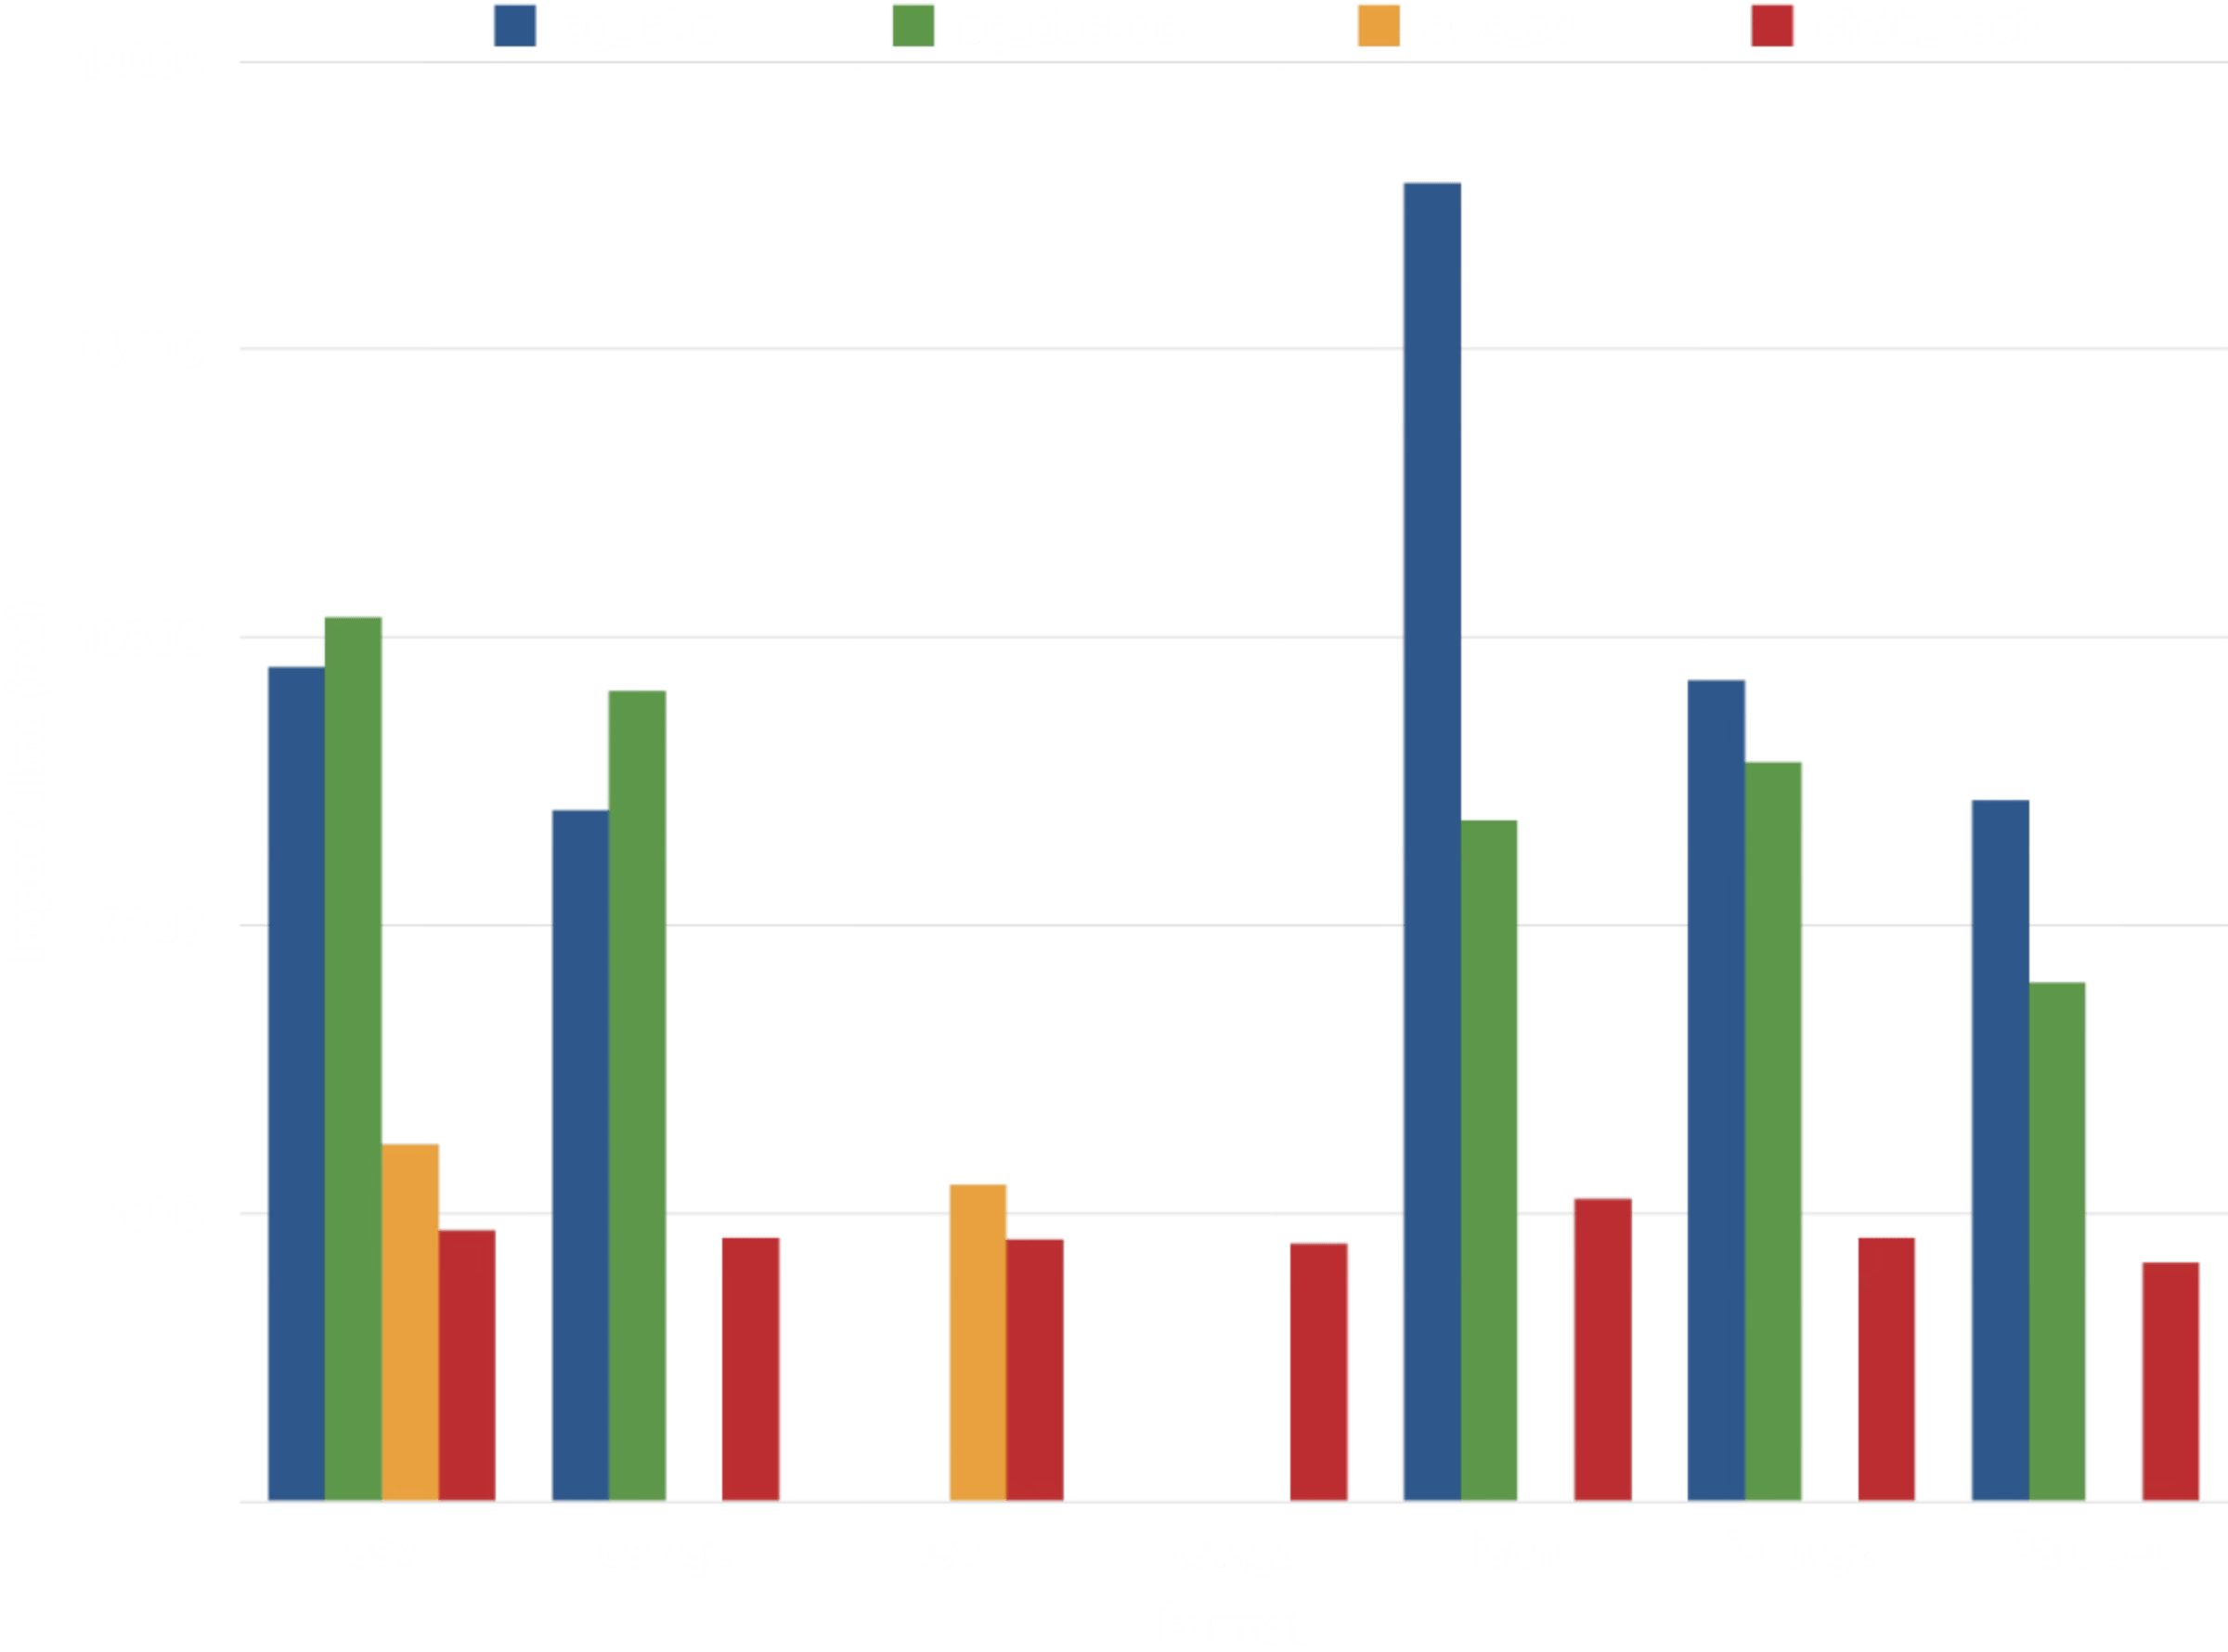 4 つの拡張機能のうち、最も安定したパフォーマンスを示したのは [chdb] です。いずれも [DuckDB] を基盤とする \[pg\_duckdb] と \[pg\_lake] は、CSV、JSON、Parquet からのデータ取り込みに約 2〜3 倍の時間を要します。\[chdb\_hook] のパフォーマンスに迫るのは \[aws\_s3] だけですが、対応するデータフォーマットの種類は大幅に限られます。
| 拡張機能 | Compression | データフォーマット |
| - | - | - |
| aws\_s3 | none | Text (TSV), CSV, Postgres Binary |
| pg\_lake | gzip, zstd, snappy (Parquet only) | CSV, JSON, Parquet |
| pg\_duckdb | gzip, zstd, snappy (Parquet only) | CSV, JSON, Parquet |
| chdb | gzip, zstd, lz4, bz2, snappy, brotli | TSV, CSV, JSON, BSON, Prometheus, Protobuf, Avro, Parquet, Arrow, XML, CapnProto, Markdown, MsgPack, ORC、そして[その他多数][formats]! |
さらにベンチマークを実施したところ、[NYC Taxi dataset] をさまざまなフォーマットで取り込む場合でも、比較的安定したパフォーマンスが得られることが確認できました。
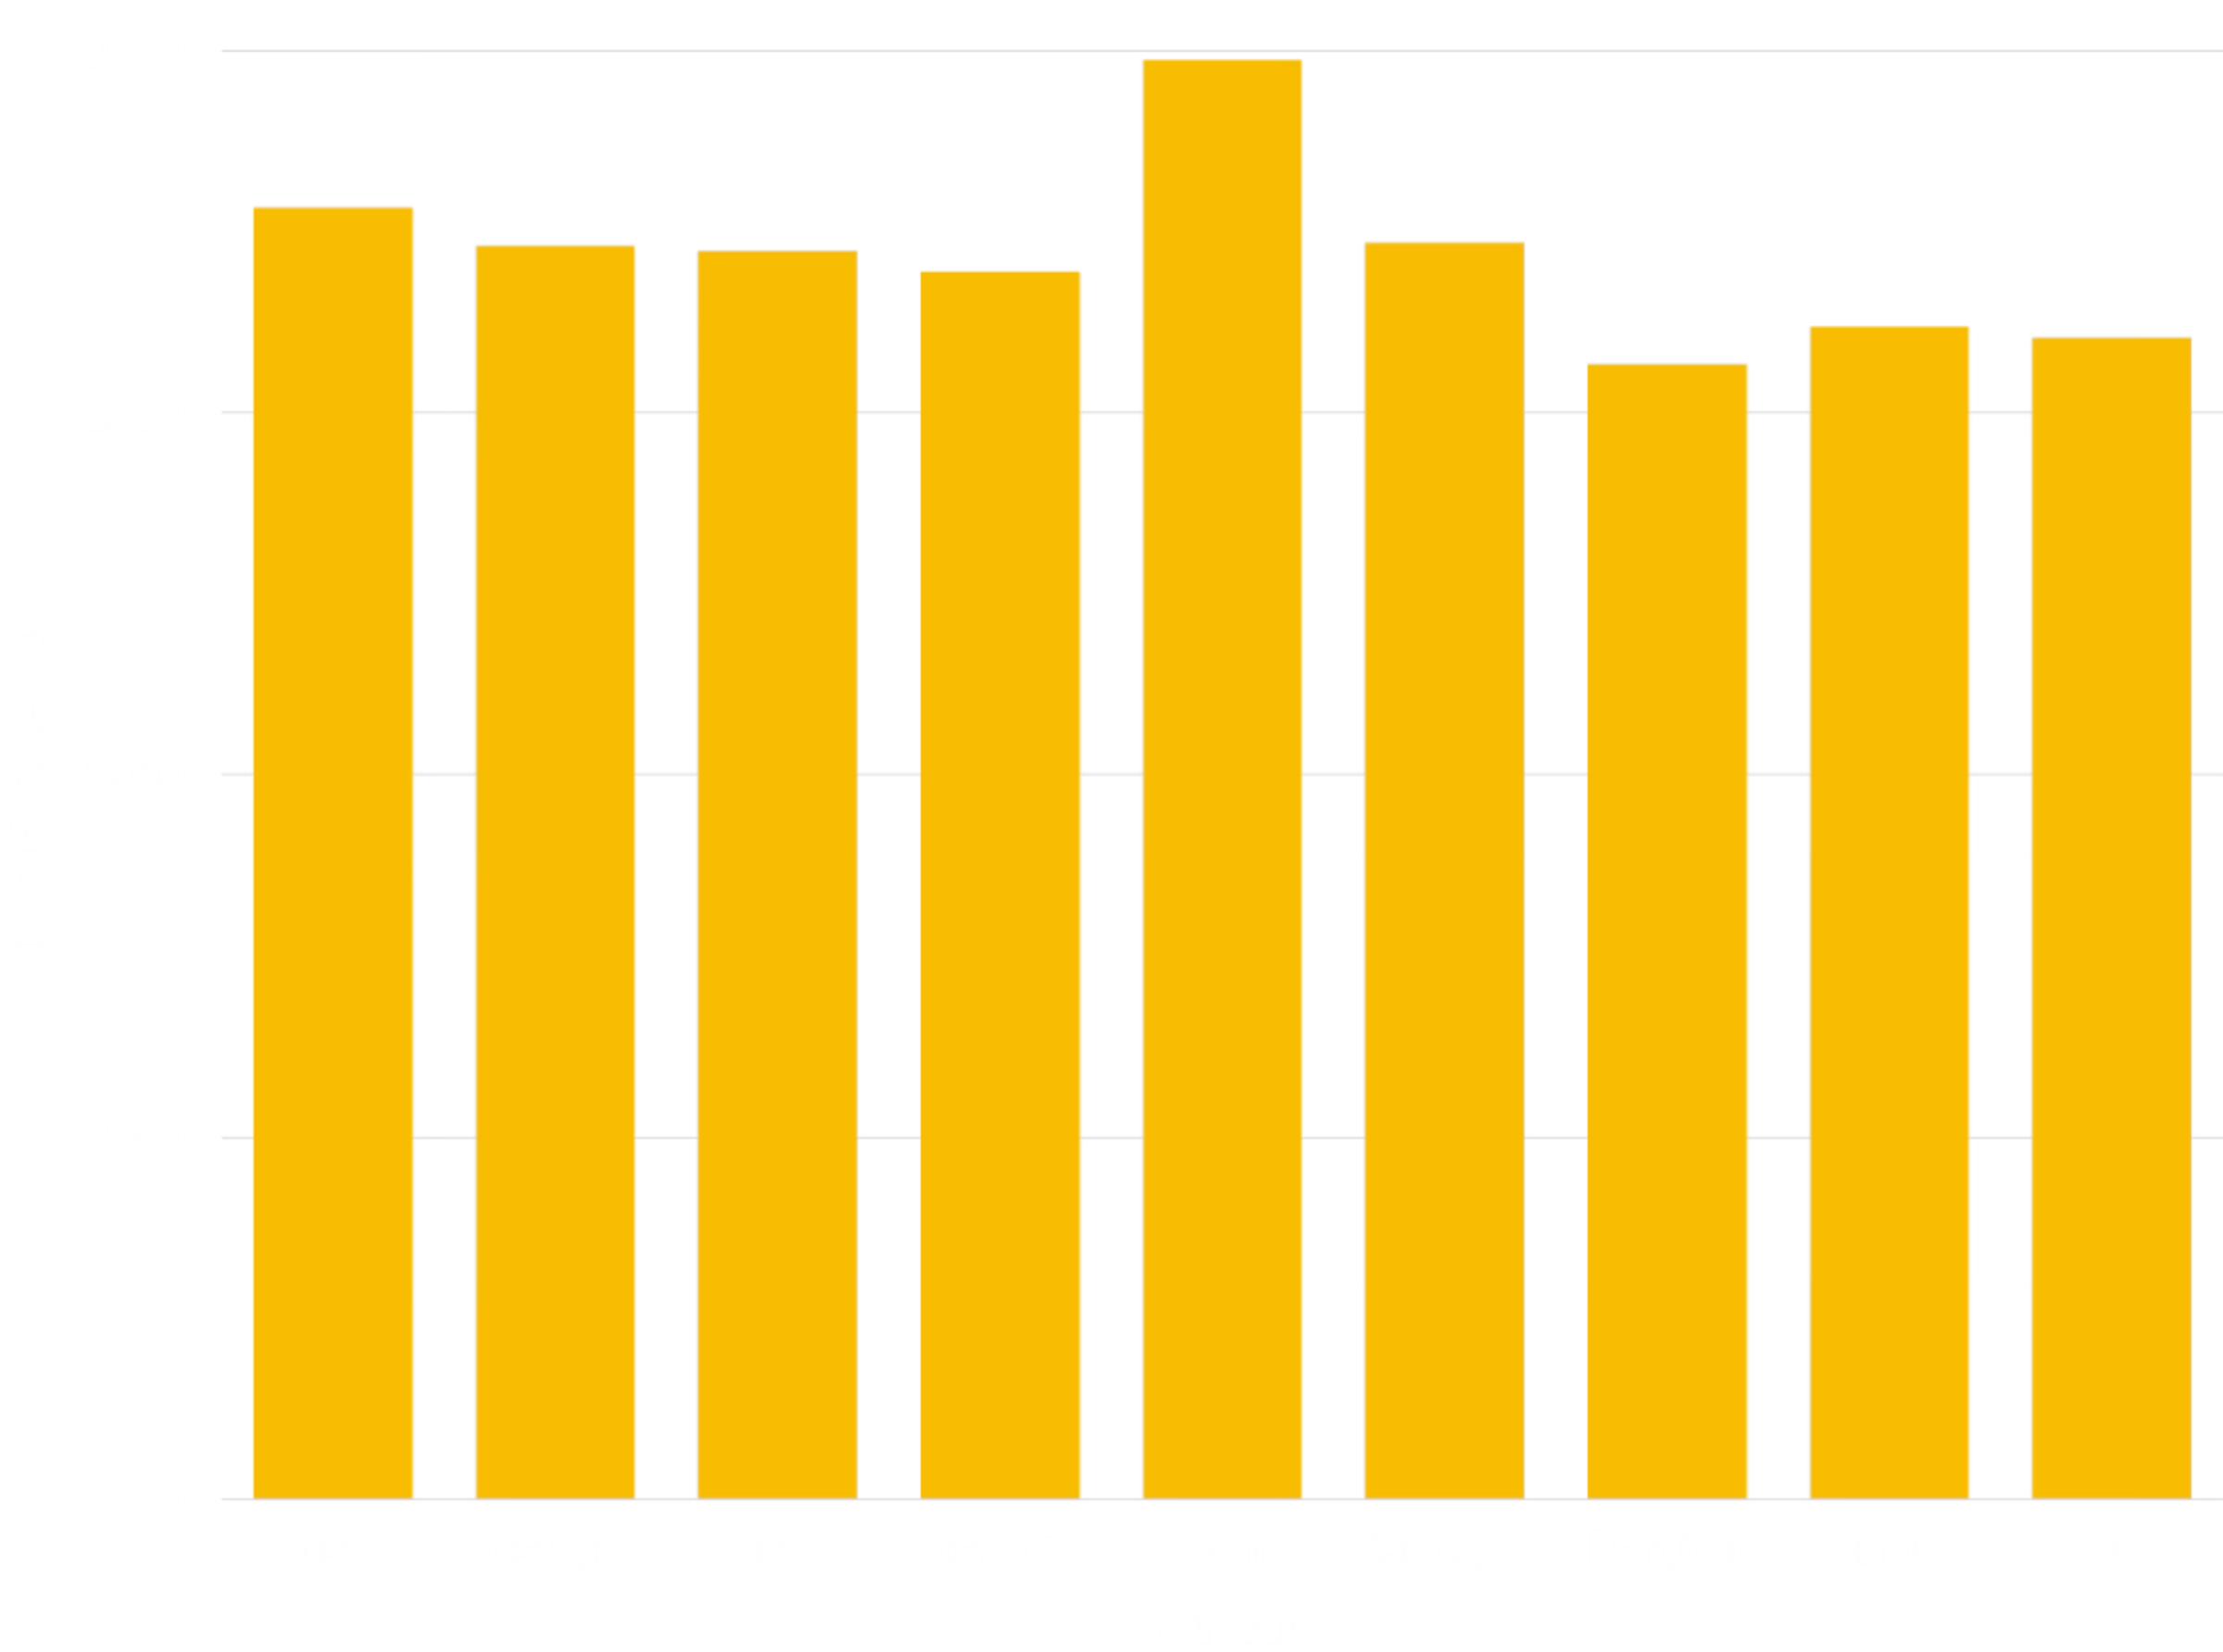 このベンチマークでは、他の拡張機能との互換性を保つために [JSONCompact] フォーマットを使用しています。[JSONCompactEachRow] などの他の JSON フォーマットを用いれば、他のフォーマットのパフォーマンスにより近い結果が得られます。
アーキテクチャ
chdb および chdb\_hook 拡張機能は、[chDB] クエリの実行に `chdb_helper` プロセスを使用します。このヘルパーにより [chDB] のリソース消費が Postgres のメインプロセスから切り離されるため、データレイクからのデータロードのように、たまにしか実行されないワークフローでは大きな利点となります。
```
+-------------+
| helper |
+----------+ | app | +------+
| Postgres | | +---------+ | | chDB |
| Backend |----->| | chDB | |----->| Data |
+----------+ | | Library | | +------+
| +---------+ |
+-------------+
```
バックグラウンドワーカーとは異なり、このヘルパーは Postgres の共有メモリを保持せず、postmaster の管理下にも置かれません。そのため、クラッシュが Postgres に波及することはありません。ヘルパーが異常終了しても、エラーが発生するのはそれを起動したバックエンドのみで、他のセッションには影響しません。
ヘルパーはクエリごとに、実行用としてディスク上に新しい一時的な chDB データベースを作成して接続します。そのため、現時点では各クエリは他のすべてのクエリから完全に独立した状態で実行されます。テーブルを作成しても、後続のクエリからそのテーブルを参照できるとは考えないでください。
Dependencies
`chdb` 拡張機能には、PostgreSQL 15 以降と [chDB] ライブラリ v26.7.0 以降が必要です (現在は Linux および macOS でのみ利用可能) 。最も簡単なインストール方法は、[lib.chdb.io] の シェルスクリプト を使用する方法です。
```sh theme={null}
curl -sL https://lib.chdb.io | bash
```
[chDB] をヘルパーアプリに静的にコンパイルするには、[インストール](#compile-from-source) の
`make` コマンドを実行する前に、以下の変数を設定してください。
```sh theme={null}
export BUNDLE_LIBCHDB=1 LIBCHDB_BUILD=static
```
`Makefile` は静的な `libchdb` ライブラリをダウンロードし、アプリに組み込んでコンパイルします。
Linux では、[インストール](#compile-from-source) の `make` コマンドを実行する前に `export BUNDLE_LIBCHDB=1` を設定しておくことで、インストール処理で動的な `libchdb` ライブラリをダウンロードしてインストールさせることもできます。
ソースからコンパイル
chdb をビルドするには、次のコマンドを実行します。
```sh theme={null}
make
make installcheck
make install
```
次のようなエラーが発生した場合:
```
"Makefile", line 8: Need an operator
```
GNU make を使用する必要があります。お使いのシステムでは `gmake` としてインストールされている場合があります:
```sh theme={null}
gmake
gmake install
gmake installcheck
```
次のようなエラーが発生した場合:
```
make: pg_config: Command not found
```
`pg_config` がインストールされ、path に含まれていることを確認してください。RPM などの package management system を使用して PostgreSQL をインストールした場合は、`-devel` package もインストールされているか確認してください。必要に応じて、build プロセスに対してその場所を指定します:
```sh theme={null}
env PG_CONFIG=/path/to/pg_config make && make installcheck && make install
```
次のようなエラーが発生した場合:
```
chdb_helper.c:22:10: fatal error: 'chdb.h' file not found
```
[chDB] をインストールするか、コンパイラにその場所を指定する必要があります。たとえば、[lib.chdb.io] のシェルスクリプト経由でインストールした場合は、`/usr/local` を指定します:
```sh theme={null}
make CFLAGS=-I/usr/local/include \
LDFLAGS=-L/usr/local/lib
```
次のようなエラーが発生した場合:
```
ERROR: must be owner of database regression
```
test suite は super user で実行する必要があります。たとえば、default の
"postgres" super user を使用します。
```sh theme={null}
make installcheck PGUSER=postgres
```
PostgreSQL 18 以降でカスタムプレフィックスに拡張機能をインストールするには、`install` に `prefix` 引数を渡します (他の `make` ターゲットには渡しません) :
```sh theme={null}
make install prefix=/usr/local/extras
```
次に、そのプレフィックスが以下の \[`postgresql.conf` の parameters] に含まれていることを確認してください。
```ini theme={null}
extension_control_path = '/usr/local/extras/postgresql/share:$system'
dynamic_library_path = '/usr/local/extras/postgresql/lib:$libdir'
```
著者
* [David E. Wheeler](https://justatheory.com/)
* [serprex](https://github.com/serprex)
著作権
Copyright (c) 2026, ClickHouse
[chDB]: https://clickhouse.com/chdb "chDB - 高速で信頼性が高く、スケーラブルなin-processデータベース"
[COPY]: https://www.postgresql.org/docs/current/sql-copy.html "Postgres Docs: COPY"
[CREATE TABLE]: https://www.postgresql.org/docs/current/sql-createtable.html "Postgres Docs: CREATE TABLE"
[lib.chdb.io]: https://lib.chdb.io "curl -sL https://lib.chdb.io | bash"
[`postgresql.conf` parameters]: https://www.postgresql.org/docs/devel/runtime-config-client.html#RUNTIME-CONFIG-CLIENT-OTHER
[chdb_hook]: https://pgxn.org/dist/chdb/doc/chdb_hook.html "PGXN上のchdb_hookドキュメント"
[aws_s3]: https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/USER_PostgreSQL.S3Import.html "Amazon S3からRDS for PostgreSQL DBインスタンスへのデータのインポート"
[pg_duckdb]: https://github.com/duckdb/pg_duckdb "高パフォーマンスなアプリケーションとanalyticsのためのDuckDB搭載Postgres"
[pg_lake]: https://github.com/Snowflake-Labs/pg_lake "pg_lake: Icebergとデータレイクへのアクセスを備えたPostgres"
[formats]: https://clickhouse.com/docs/reference/formats/index "ClickHouse Docs: 入力および出力データのフォーマット"
[NYC Taxi dataset]: /get-started/sample-datasets/nyc-taxi "ClickHouse Docs: ニューヨークのタクシーデータ"
[benchmark]: https://github.com/ClickHouse/pg_chdb/tree/main/dev/benchmark "Postgres Lake Copy Benchmark"
[JSONCompact]: /reference/formats/JSON/JSONCompact "ClickHouse Docs: JSONCompact"
[JSONCompactEachRow]: /reference/formats/JSON/JSONCompactEachRow "ClickHouse Docs: JSONCompactEachRow"
[DuckDB]: https://duckdb.org "DuckDB: universalなデータ加工ツール"