> ## Documentation Index
> Fetch the complete documentation index at: https://private-7c7dfe99-vortex-format.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
> Importez et exportez des données depuis Postgres vers un large éventail de formats de données et de stockages d'objets.
# Documentation de référence de l'extension chdb
Introduction
Cette bibliothèque fournit des extensions PostgreSQL permettant d'exécuter des requêtes [chDB] dans
Postgres, ainsi que de copier des données depuis et vers divers formats et stockage d’objet.
Extension chdb
L'extension `chdb` exécute des requêtes [chDB]. La fonction `chdb_query()` exécute
une seule requête. Par exemple, cette requête :
```sql theme={null}
SELECT * FROM chdb_query($$
SELECT * FROM s3('s3://datasets-documentation/my-test-bucket-768/some_prefix/some_file_1.csv')
$$) AS (id int, months int, days int);
```
Sorties :
```
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(3 rows)
```
Consultez la [documentation chdb](/fr/products/managed-postgres/extensions/chdb/chdb)
pour plus de détails.
Module chdb\_hook
Le module `chdb_hook` se greffe sur la commande [COPY] afin de copier des données vers ou depuis
S3, GCS, Azure Blob, un fichier ou une URL http. Cet exemple charge des enregistrements issus de
plusieurs fichiers CSV sur S3 en une seule commande [COPY] :
```sql theme={null}
CREATE TABLE times (
id INT NOT NULL,
months INT NOT NULL,
days INT NOT NULL
);
LOAD 'chdb_hook';
COPY times FROM 's3://datasets-documentation/my-test-bucket-768/{some,another}_prefix/some_file_{1..3}.csv';
```
Après quoi la table `times` contient les enregistrements de chaque fichier chargé :
```pgsql theme={null}
# SELECT * FROM times;
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(18 rows)
```
Un [CREATE TABLE] peut également déduire ses colonnes, et charger ses lignes, à partir d'une telle
URL :
```sql theme={null}
CREATE TABLE reviews () WITH (
copy_from = 'https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet'
);
```
Voir la [documentation de chdb\_hook](/fr/products/managed-postgres/extensions/chdb/chdb_hook)
pour plus de détails.
Un [benchmark] compare les performances de `COPY` avec \[chdb\_hook] à celles
d'\[aws\_s3], \[pg\_duckdb] et \[pg\_lake] pour environ 1 million de rows du
[jeu de données des taxis de NYC] dans divers formats.
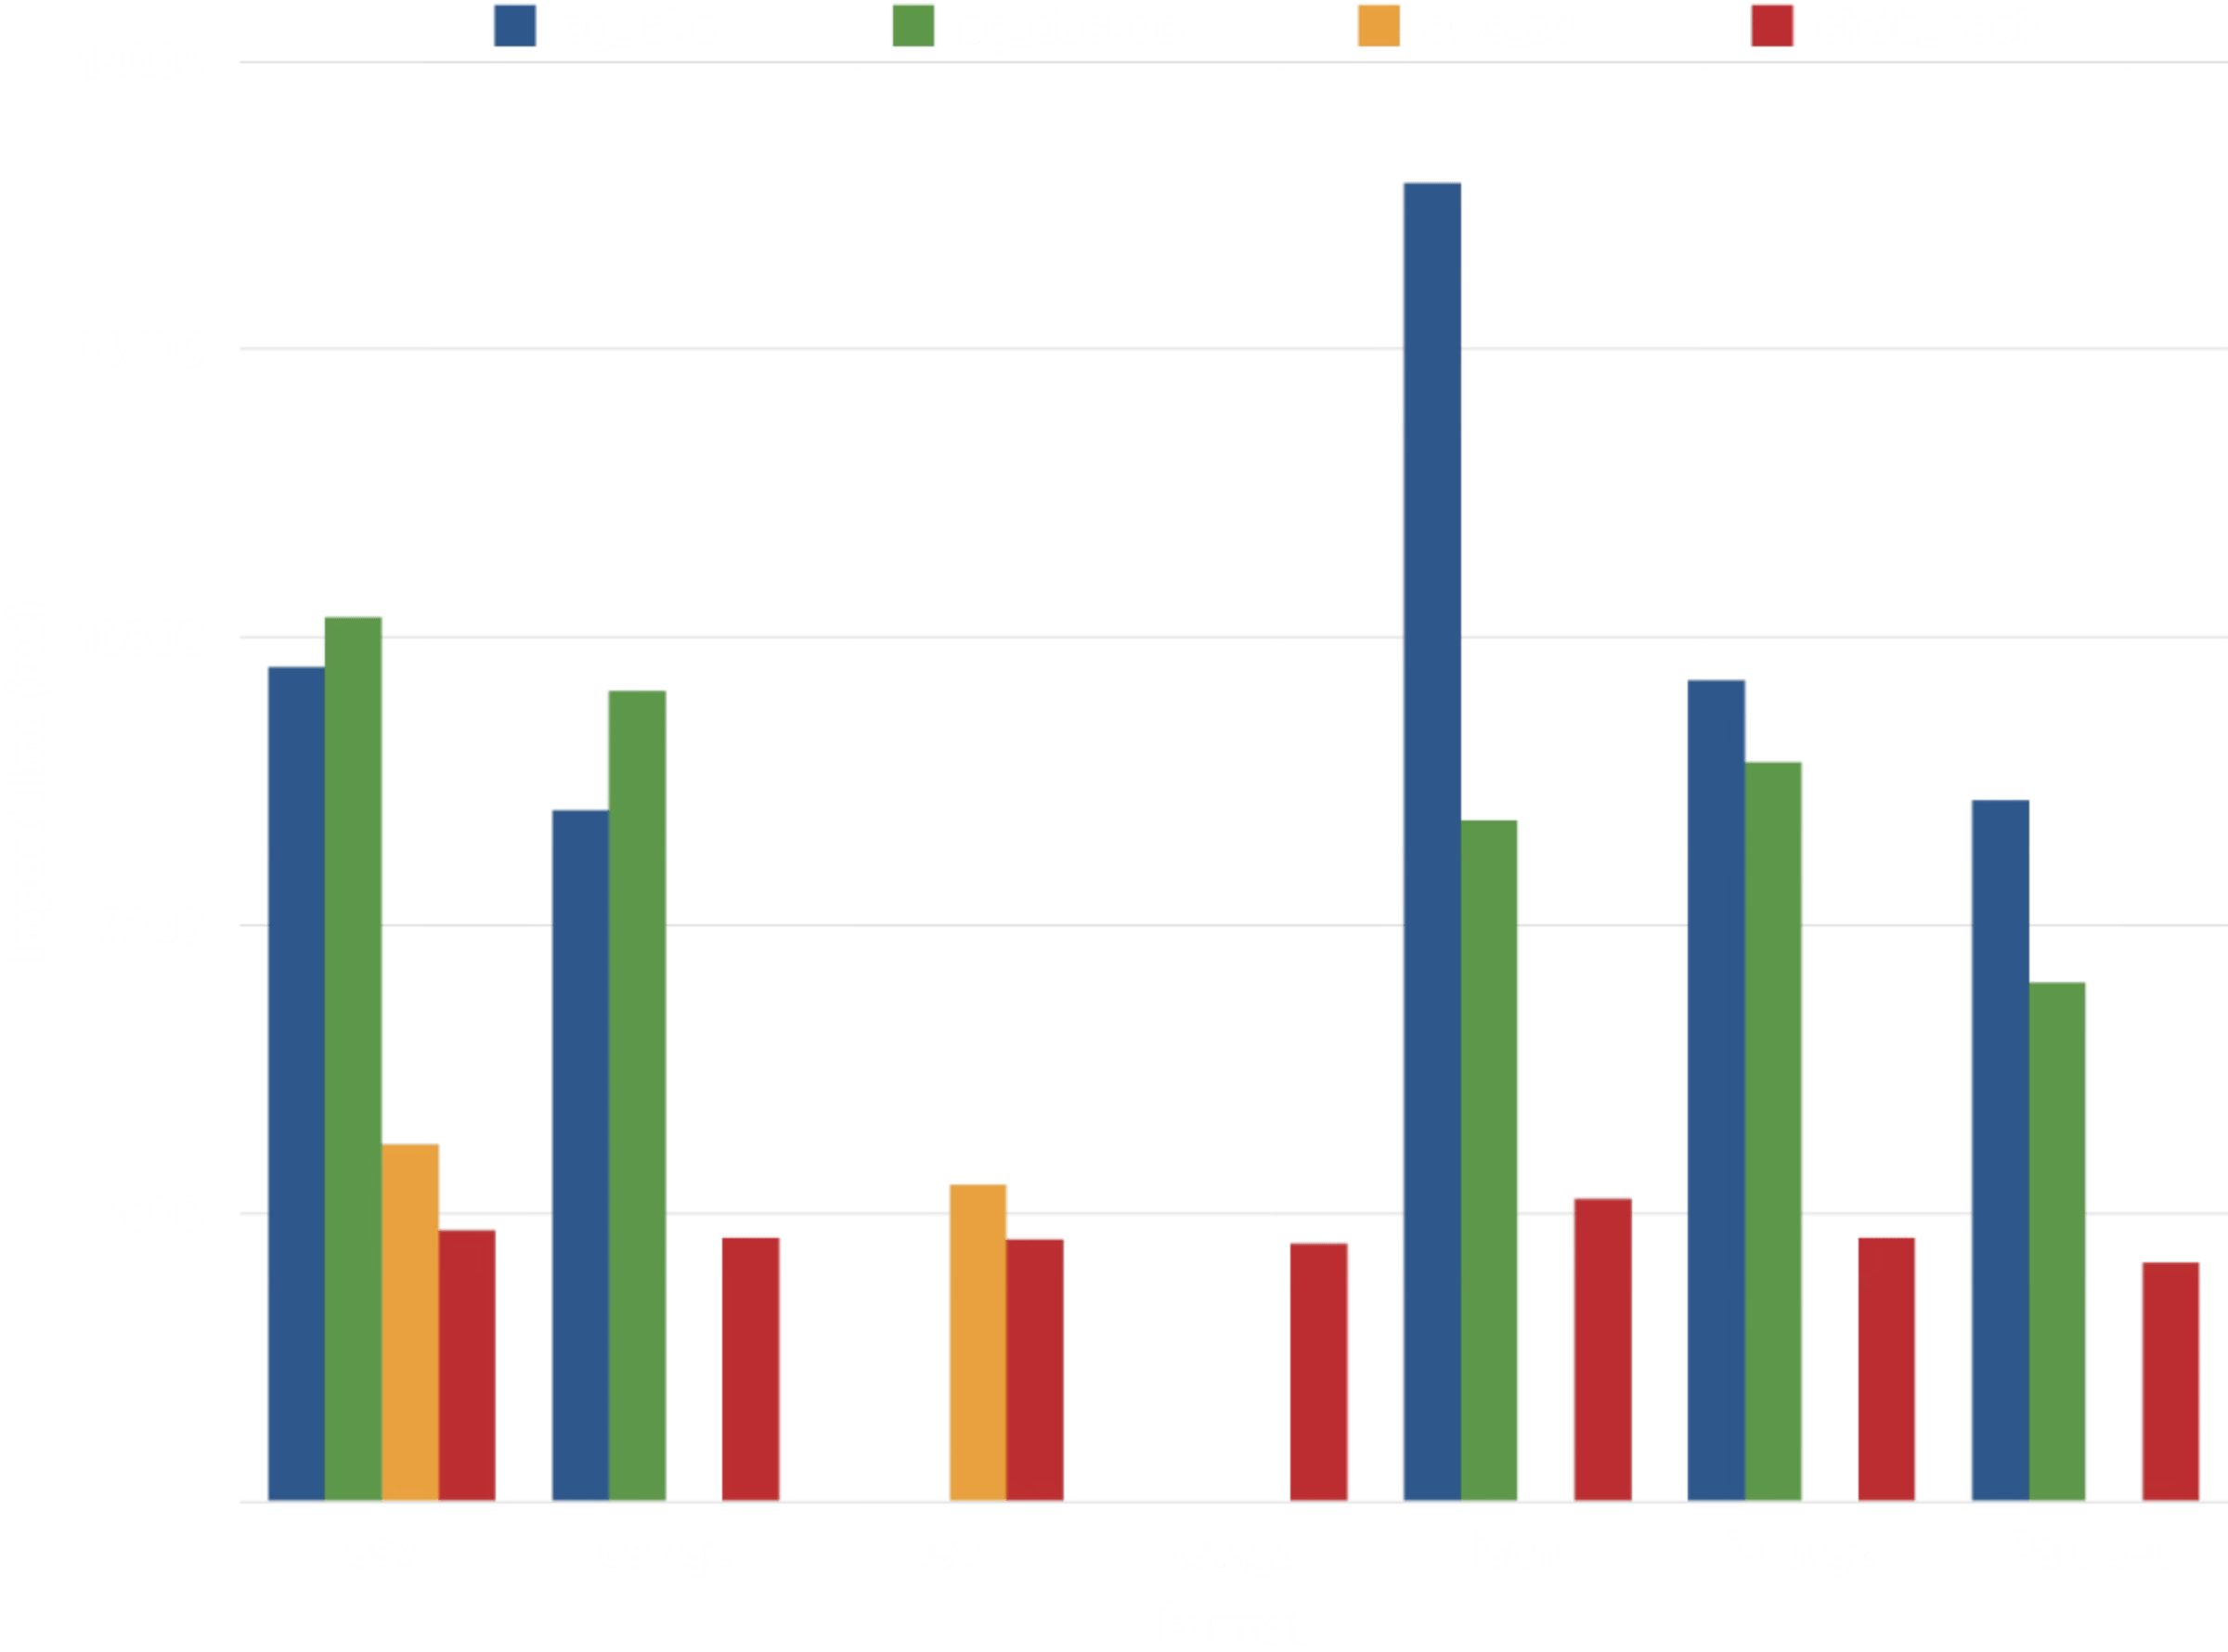 Parmi les quatre extensions, [chdb] offre les performances les plus
constantes. \[pg\_duckdb] et \[pg\_lake], tous deux reposant sur [DuckDB], mettent
environ 2 à 3 fois plus de temps à importer des données au format CSV, JSON et
Parquet. Seul \[aws\_s3] se rapproche des performances de \[chdb\_hook], mais il prend
en charge un éventail de formats de données bien plus restreint :
| Extension | Compression | Formats de données |
| - | - | - |
| aws\_s3 | aucune | Texte (TSV), CSV, Postgres Binary |
| pg\_lake | gzip, zstd, snappy (Parquet uniquement) | CSV, JSON, Parquet |
| pg\_duckdb | gzip, zstd, snappy (Parquet uniquement) | CSV, JSON, Parquet |
| chdb | gzip, zstd, lz4, bz2, snappy, brotli | TSV, CSV, JSON, BSON, Prometheus, Protobuf, Avro, Parquet, Arrow, XML, CapnProto, Markdown, MsgPack, ORC, et [bien plus][formats] ! |
D'autres mesures de benchmarking montrent des performances relativement
constantes lors de l'import du [jeu de données des taxis de NYC] dans divers formats :
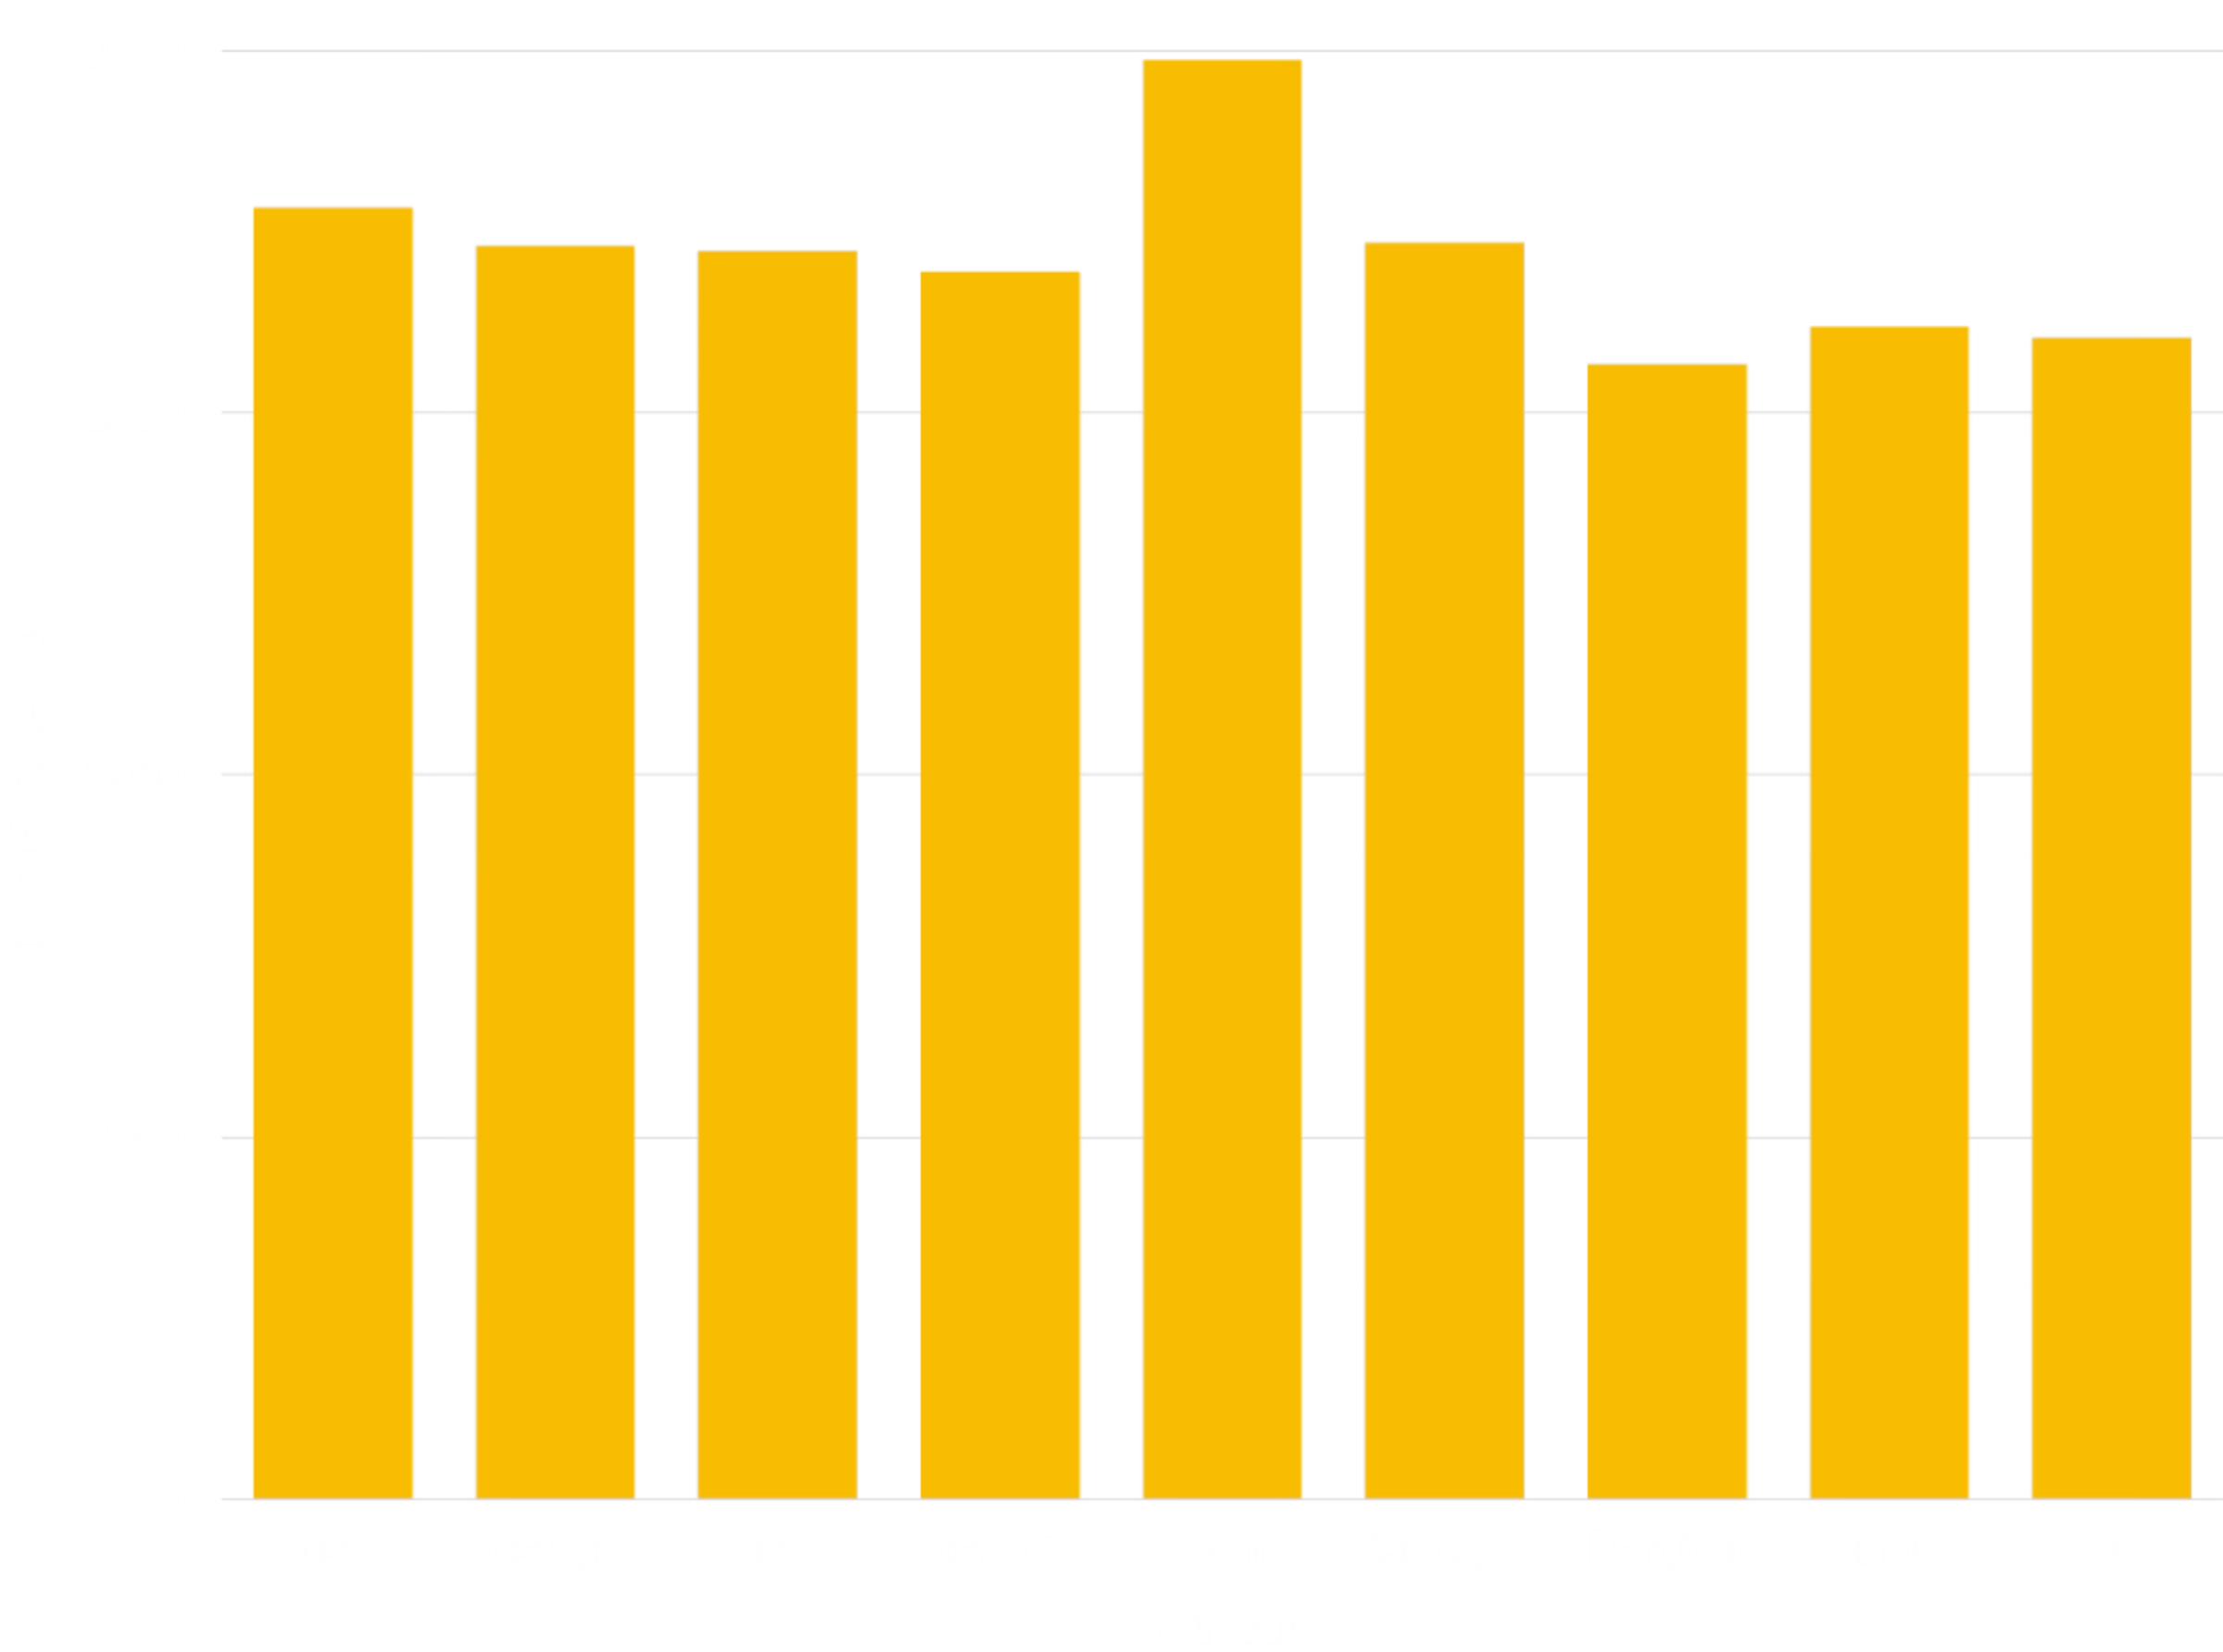 Le benchmark utilise le format [JSONCompact] par souci de compatibilité
avec les autres extensions ; d'autres formats JSON, tels que
[JSONCompactEachRow], se rapprocheront davantage des performances des autres
formats.
Architecture
Les extensions chdb et chdb\_hook s'appuient sur un processus `chdb_helper` pour exécuter
les requêtes [chDB]. Ce processus auxiliaire maintient la consommation de ressources de [chDB]
séparée de celle du processus Postgres principal, un avantage pour un workflow utilisé
occasionnellement, comme le chargement de données depuis un data lake.
```
+-------------+
| helper |
+----------+ | app | +------+
| Postgres | | +---------+ | | chDB |
| Backend |----->| | chDB | |----->| Data |
+----------+ | | Library | | +------+
| +---------+ |
+-------------+
```
Contrairement à un background worker, le processus auxiliaire ne détient aucune mémoire partagée Postgres et
n'est pas géré par le postmaster. Les crashs sont ainsi isolés et n'affectent pas Postgres.
Si un processus auxiliaire meurt, cela déclenche une error uniquement dans le backend qui l'a démarré,
sans incidence sur les autres sessions.
Pour chaque requête, le processus auxiliaire se connecte à une nouvelle database chDB temporaire sur disque
pour l'exécuter. Par conséquent, chaque requête s'exécute actuellement dans un isolement
total par rapport à toutes les autres. Ne créez pas de table en espérant l'interroger
dans une requête ultérieure.
Dépendances
L'extension `chdb` nécessite PostgreSQL 15 ou une version supérieure ainsi que la bibliothèque [chDB]
v26.7.0 ou ultérieure (actuellement disponible uniquement pour Linux et macOS). Le
plus simple est de l'installer via le script shell [lib.chdb.io] :
```sh theme={null}
curl -sL https://lib.chdb.io | bash
```
Pour compiler statiquement [chDB] dans l'application auxiliaire, définissez les variables suivantes
avant d'exécuter les commandes `make` de l'[Installation](#compile-from-source).
```sh theme={null}
export BUNDLE_LIBCHDB=1 LIBCHDB_BUILD=static
```
Le `Makefile` télécharge la bibliothèque statique `libchdb` et la compile dans
l'application.
Sur Linux, vous pouvez également faire en sorte que le processus d'installation télécharge et installe la
bibliothèque dynamique `libchdb` en définissant `export BUNDLE_LIBCHDB=1` avant d'exécuter
les commandes `make` de l'[Installation](#compile-from-source).
Compiler depuis les sources
Pour compiler chdb, il suffit de faire ceci :
```sh theme={null}
make
make installcheck
make install
```
Si vous rencontrez une erreur telle que :
```
"Makefile", line 8: Need an operator
```
Vous devez utiliser GNU make, qui est peut-être déjà installé sur votre système sous le nom
`gmake` :
```sh theme={null}
gmake
gmake install
gmake installcheck
```
Si vous rencontrez une erreur telle que :
```
make: pg_config: Command not found
```
Assurez-vous que `pg_config` est installé et accessible dans votre path. Si vous
avez installé PostgreSQL à l'aide d'un système de gestion de paquets tel que RPM,
vérifiez que le paquet `-devel` est également installé. Si nécessaire, indiquez au
processus de build où le trouver :
```sh theme={null}
env PG_CONFIG=/path/to/pg_config make && make installcheck && make install
```
Si vous rencontrez une erreur telle que :
```
chdb_helper.c:22:10: fatal error: 'chdb.h' file not found
```
Vous devez soit installer [chDB], soit indiquer au compilateur où le trouver. Si,
par exemple, vous l'avez installé via le script shell [lib.chdb.io], indiquez
`/usr/local` :
```sh theme={null}
make CFLAGS=-I/usr/local/include \
LDFLAGS=-L/usr/local/lib
```
Si vous rencontrez une erreur telle que :
```
ERROR: must be owner of database regression
```
Vous devez exécuter la test suite avec un super user, tel que le super user
"postgres" par défaut :
```sh theme={null}
make installcheck PGUSER=postgres
```
Pour installer l'extension dans un prefix personnalisé sur PostgreSQL 18 ou version ultérieure, passez
l'argument `prefix` à `install` (mais à aucune autre cible `make`) :
```sh theme={null}
make install prefix=/usr/local/extras
```
Assurez-vous ensuite que le prefix est inclus dans les \[paramètres
`postgresql.conf`]\[paramètres
\`postgresql.conf\`] suivants :
```ini theme={null}
extension_control_path = '/usr/local/extras/postgresql/share:$system'
dynamic_library_path = '/usr/local/extras/postgresql/lib:$libdir'
```
Auteurs
* [David E. Wheeler](https://justatheory.com/)
* [serprex](https://github.com/serprex)
Copyright
Copyright (c) 2026, ClickHouse
[chDB]: https://clickhouse.com/chdb "chDB — base de données in-process rapide, fiable et évolutive"
[COPY]: https://www.postgresql.org/docs/current/sql-copy.html "Documentation Postgres : COPY"
[CREATE TABLE]: https://www.postgresql.org/docs/current/sql-createtable.html "Documentation Postgres : CREATE TABLE"
[lib.chdb.io]: https://lib.chdb.io "curl -sL https://lib.chdb.io | bash"
[paramètres `postgresql.conf`]: https://www.postgresql.org/docs/devel/runtime-config-client.html#RUNTIME-CONFIG-CLIENT-OTHER
[chdb_hook]: https://pgxn.org/dist/chdb/doc/chdb_hook.html "Documentation chdb_hook sur PGXN"
[aws_s3]: https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/USER_PostgreSQL.S3Import.html "Importer des données depuis Amazon S3 vers une DB instance RDS pour PostgreSQL"
[pg_duckdb]: https://github.com/duckdb/pg_duckdb "Postgres propulsé par DuckDB pour des applications et de l'analytics haute performance"
[pg_lake]: https://github.com/Snowflake-Labs/pg_lake "pg_lake : Postgres avec accès à Iceberg et aux data lakes"
[formats]: https://clickhouse.com/docs/reference/formats/index "ClickHouse Docs : Formats for input and output data"
[jeu de données des taxis de NYC]: /get-started/sample-datasets/nyc-taxi "ClickHouse Docs : données des taxis de New York"
[benchmark]: https://github.com/ClickHouse/pg_chdb/tree/main/dev/benchmark "Postgres Lake Copy Benchmark"
[JSONCompact]: /reference/formats/JSON/JSONCompact "ClickHouse Docs : JSONCompact"
[JSONCompactEachRow]: /reference/formats/JSON/JSONCompactEachRow "ClickHouse Docs : JSONCompactEachRow"
[DuckDB]: https://duckdb.org "DuckDB : votre outil universel de manipulation de données"