> ## Documentation Index
> Fetch the complete documentation index at: https://private-7c7dfe99-vortex-format.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
> Importa y exporta datos desde Postgres a una amplia variedad de formatos de datos y almacenes de objetos.
# Documentación de referencia de la extensión chdb
Introducción
Esta biblioteca proporciona extensiones de PostgreSQL para ejecutar consultas [chDB] en
Postgres y para copiar datos desde y hacia diversos formatos y almacenes de objetos.
Extensión chdb
La extensión `chdb` ejecuta consultas de [chDB]. La función `chdb_query()` ejecuta
una única consulta. Por ejemplo, esta consulta:
```sql theme={null}
SELECT * FROM chdb_query($$
SELECT * FROM s3('s3://datasets-documentation/my-test-bucket-768/some_prefix/some_file_1.csv')
$$) AS (id int, months int, days int);
```
Salida:
```
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(3 rows)
```
Consulta la [documentación de chdb](/es/products/managed-postgres/extensions/chdb/chdb)
para obtener más detalles.
Módulo chdb\_hook
El módulo `chdb_hook` se engancha al comando [COPY] para copiar datos hacia o desde
S3, GCS, Azure Blob, un archivo o una URL http. Este ejemplo carga registros de
varios archivos CSV en S3 con un solo comando [COPY]:
```sql theme={null}
CREATE TABLE times (
id INT NOT NULL,
months INT NOT NULL,
days INT NOT NULL
);
LOAD 'chdb_hook';
COPY times FROM 's3://datasets-documentation/my-test-bucket-768/{some,another}_prefix/some_file_{1..3}.csv';
```
Tras lo cual, la tabla `times` contiene los registros de cada archivo que cargó:
```pgsql theme={null}
# SELECT * FROM times;
id | months | days
----+--------+------
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
1 | 2 | 3
3 | 2 | 1
4 | 5 | 6
(18 rows)
```
Un [CREATE TABLE] también puede derivar sus columnas y cargar sus filas desde
una URL de este tipo:
```sql theme={null}
CREATE TABLE reviews () WITH (
copy_from = 'https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet'
);
```
Consulta la [documentación de chdb\_hook](/es/products/managed-postgres/extensions/chdb/chdb_hook)
para más detalles.
Un [benchmark] compara el rendimiento de `COPY` de \[chdb\_hook] con el de
\[aws\_s3], \[pg\_duckdb] y \[pg\_lake] para aprox. 1 M de filas del [NYC Taxi dataset] en
diversos formatos.
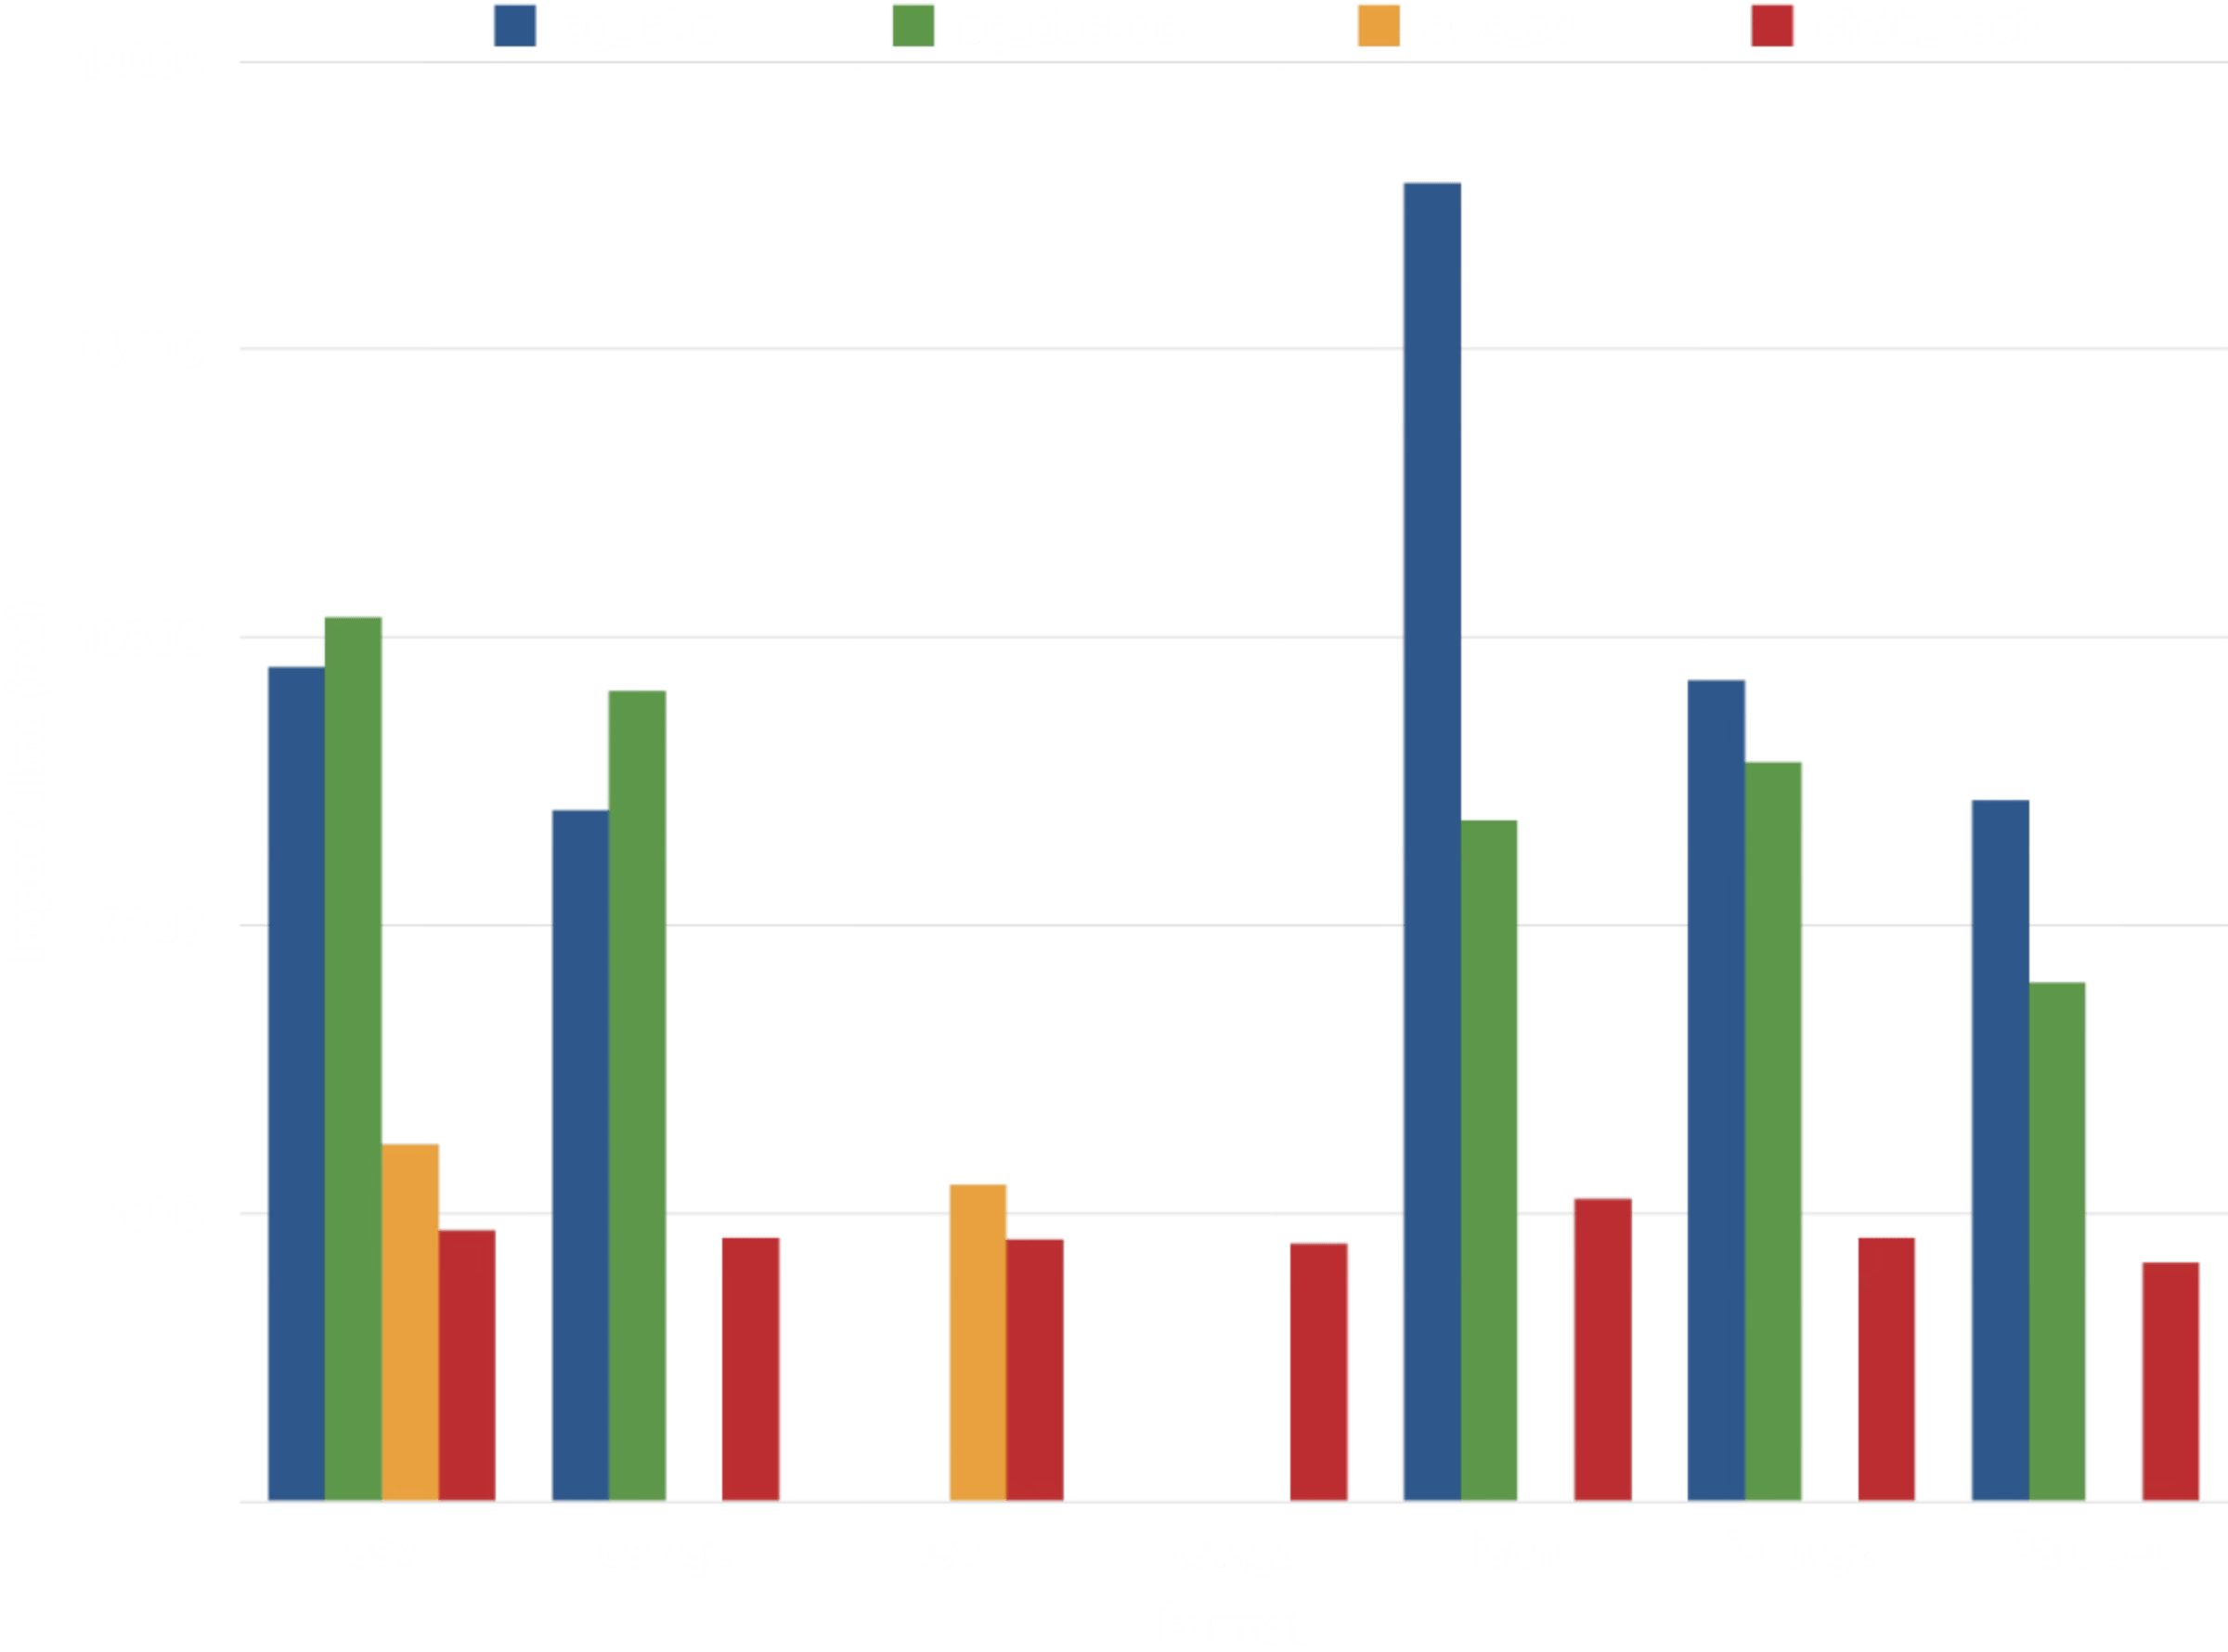 De las cuatro extensiones, [chdb] es la que muestra un rendimiento más consistente.
\[pg\_duckdb] y \[pg\_lake], ambos basados en [DuckDB], tardan entre 2 y 3 veces más
en importar datos desde CSV, JSON y Parquet. Solo \[aws\_s3] se acerca al
rendimiento de \[chdb\_hook], pero admite un conjunto de formatos de datos mucho
más limitado:
| Extensión | Compresión | Formatos de datos |
| - | - | - |
| aws\_s3 | ninguna | Texto (TSV), CSV, Postgres Binary |
| pg\_lake | gzip, zstd, snappy (solo Parquet) | CSV, JSON, Parquet |
| pg\_duckdb | gzip, zstd, snappy (solo Parquet) | CSV, JSON, Parquet |
| chdb | gzip, zstd, lz4, bz2, snappy, brotli | TSV, CSV, JSON, BSON, Prometheus, Protobuf, Avro, Parquet, Arrow, XML, CapnProto, Markdown, MsgPack, ORC ¡y [más][formats]! |
Otras pruebas de benchmarking demuestran un rendimiento relativamente consistente
al importar el [NYC Taxi dataset] en diversos formatos:
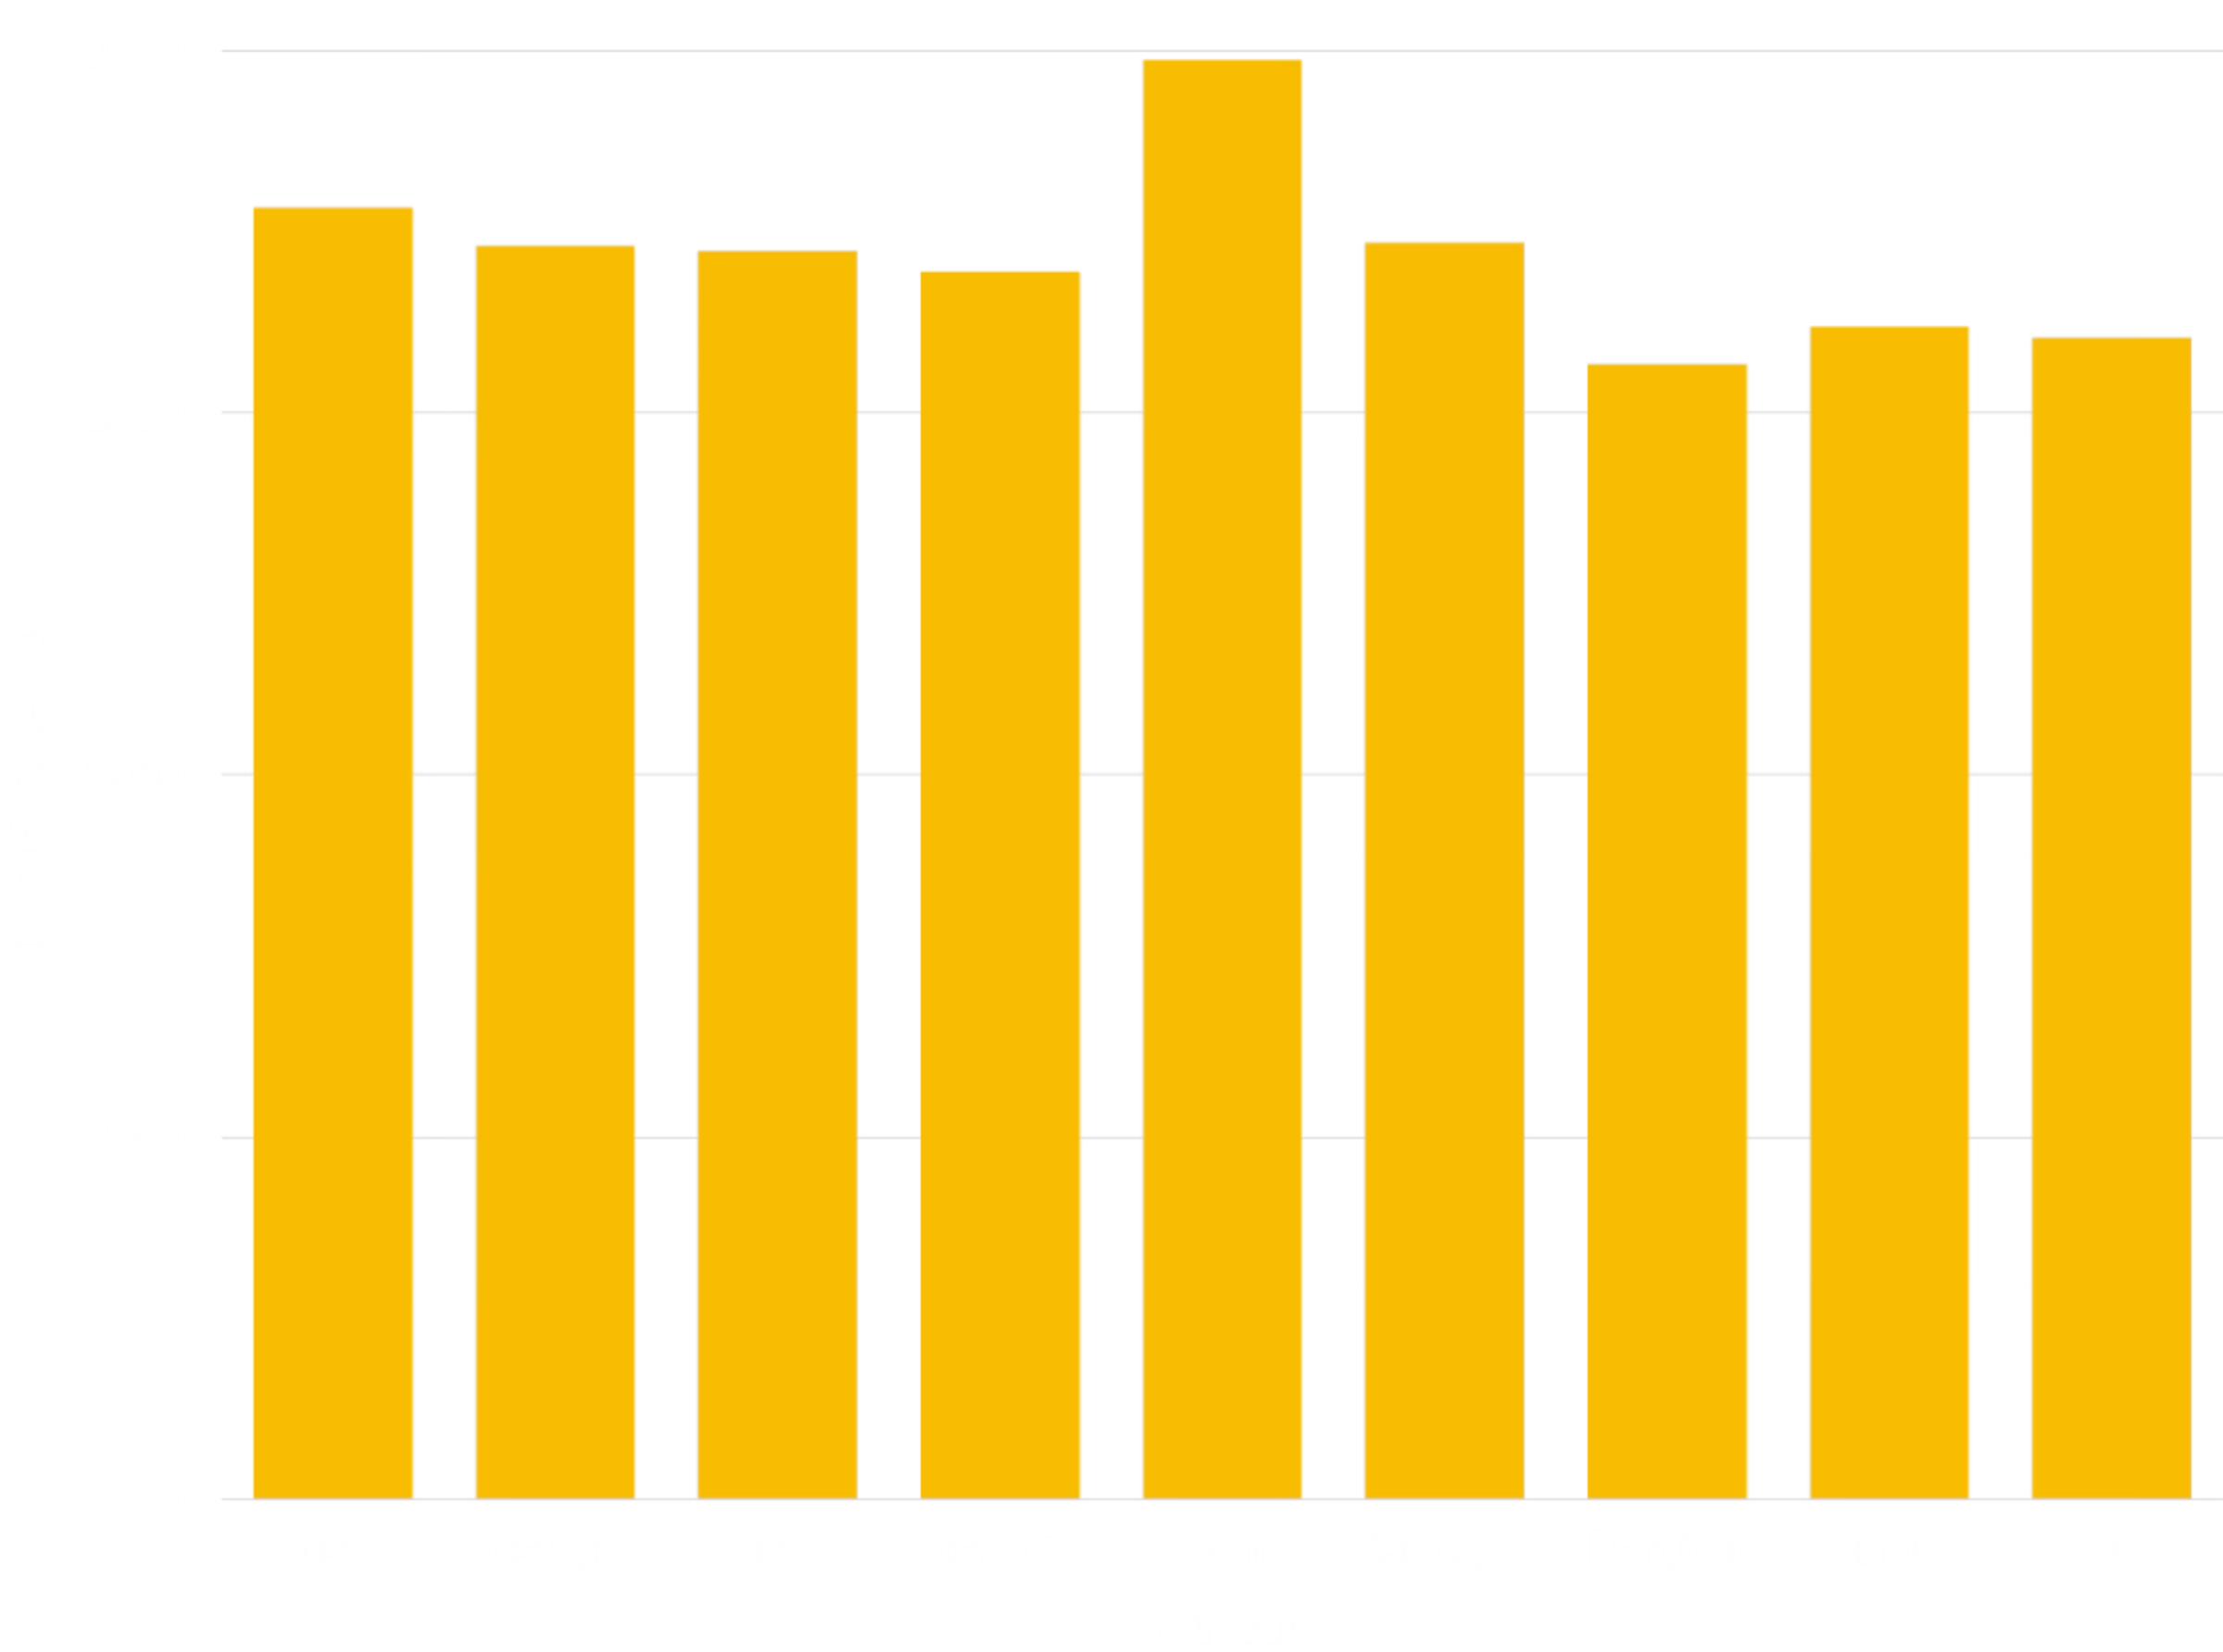 El benchmark utiliza el formato [JSONCompact] por compatibilidad con las demás
extensiones; otros formatos JSON, como [JSONCompactEachRow], se aproximan
más al rendimiento de los otros formatos.
Architecture
Las extensiones chdb y chdb\_hook dependen de un proceso `chdb_helper` para ejecutar
consultas de [chDB]. El helper mantiene el consumo de recursos de [chDB] separado
del proceso principal de Postgres, lo que supone una ventaja en flujos de trabajo de uso ocasional,
como la carga de datos desde un lago de datos.
```
+-------------+
| helper |
+----------+ | app | +------+
| Postgres | | +---------+ | | chDB |
| Backend |----->| | chDB | |----->| Data |
+----------+ | | Library | | +------+
| +---------+ |
+-------------+
```
A diferencia de un worker en segundo plano, el helper no retiene memoria compartida de Postgres ni es gestionado por el postmaster. Esto aísla los crashes, de modo que no afecten a Postgres.
Si un helper muere, el error solo se produce en el backend que lo inició, y las demás sessions no se ven afectadas.
Para cada consulta, el helper se conecta a una nueva database temporal de chdb en disco para ejecutarla. Como consecuencia, actualmente cada consulta se ejecuta con total aislamiento respecto de todas las demás. No cree una table esperando poder consultarla en una consulta posterior.
Dependencias
La extensión `chdb` requiere PostgreSQL 15 o superior y la biblioteca [chDB]
v26.7.0 o superior (actualmente disponible solo para Linux y macOS). La forma
más sencilla de instalarla es mediante el script de shell [lib.chdb.io]:
```sh theme={null}
curl -sL https://lib.chdb.io | bash
```
Para compilar estáticamente [chDB] en la aplicación auxiliar, define las siguientes variables antes de ejecutar los comandos `make` de la [Instalación](#compile-from-source).
```sh theme={null}
export BUNDLE_LIBCHDB=1 LIBCHDB_BUILD=static
```
El `Makefile` descargará la biblioteca estática `libchdb` y la compilará en
la aplicación.
En Linux, también puede hacer que el proceso de instalación descargue e instale la
biblioteca dinámica `libchdb` definiendo `export BUNDLE_LIBCHDB=1` antes de ejecutar
los comandos `make` de la [Instalación](#compile-from-source).
Compilar desde el código fuente
Para compilar chdb, basta con ejecutar lo siguiente:
```sh theme={null}
make
make installcheck
make install
```
Si aparece un error como el siguiente:
```
"Makefile", line 8: Need an operator
```
Debe usar GNU make, que es muy posible que ya esté instalado en su sistema como
`gmake`:
```sh theme={null}
gmake
gmake install
gmake installcheck
```
Si encuentra un error como el siguiente:
```
make: pg_config: Command not found
```
Asegúrese de tener `pg_config` instalado y disponible en su path. Si utilizó un
sistema de gestión de paquetes como RPM para instalar PostgreSQL, asegúrese de que
también esté instalado el paquete `-devel`. Si es necesario, indique al proceso de build dónde
encontrarlo:
```sh theme={null}
env PG_CONFIG=/path/to/pg_config make && make installcheck && make install
```
Si aparece un error como el siguiente:
```
chdb_helper.c:22:10: fatal error: 'chdb.h' file not found
```
Debe instalar [chDB] o indicarle al compilador dónde encontrarlo. Si, por
ejemplo, lo instaló mediante el script de shell [lib.chdb.io], apunte a
`/usr/local`:
```sh theme={null}
make CFLAGS=-I/usr/local/include \
LDFLAGS=-L/usr/local/lib
```
Si encuentra un error como el siguiente:
```
ERROR: must be owner of database regression
```
Debe ejecutar la suite de pruebas con un super user, como el super user
"postgres" predeterminado:
```sh theme={null}
make installcheck PGUSER=postgres
```
Para instalar la extensión en un `prefix` personalizado en PostgreSQL 18 o versiones posteriores, pase el argumento `prefix` a `install` (pero no a ningún otro objetivo de `make`):
```sh theme={null}
make install prefix=/usr/local/extras
```
A continuación, asegúrese de que el prefijo esté incluido en los siguientes \[parámetros de
`postgresql.conf`]:
```ini theme={null}
extension_control_path = '/usr/local/extras/postgresql/share:$system'
dynamic_library_path = '/usr/local/extras/postgresql/lib:$libdir'
```
Autores
* [David E. Wheeler](https://justatheory.com/)
* [serprex](https://github.com/serprex)
Copyright
Copyright (c) 2026, ClickHouse
[chDB]: https://clickhouse.com/chdb "chDB: base de datos rápida, fiable y escalable en el mismo proceso"
[COPY]: https://www.postgresql.org/docs/current/sql-copy.html "Documentación de Postgres: COPY"
[CREATE TABLE]: https://www.postgresql.org/docs/current/sql-createtable.html "Documentación de Postgres: CREATE TABLE"
[lib.chdb.io]: https://lib.chdb.io "curl -sL https://lib.chdb.io | bash"
[`postgresql.conf` parameters]: https://www.postgresql.org/docs/devel/runtime-config-client.html#RUNTIME-CONFIG-CLIENT-OTHER
[chdb_hook]: https://pgxn.org/dist/chdb/doc/chdb_hook.html "Documentación de chdb_hook en PGXN"
[aws_s3]: https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/USER_PostgreSQL.S3Import.html "Importar datos desde Amazon S3 a una instancia de base de datos de RDS para PostgreSQL"
[pg_duckdb]: https://github.com/duckdb/pg_duckdb "Postgres impulsado por DuckDB para aplicaciones y analítica de alto rendimiento"
[pg_lake]: https://github.com/Snowflake-Labs/pg_lake "pg_lake: Postgres con acceso a Iceberg y a lagos de datos"
[formats]: https://clickhouse.com/docs/reference/formats/index "ClickHouse Docs: Formats for input and output data"
[NYC Taxi dataset]: /get-started/sample-datasets/nyc-taxi "ClickHouse Docs: datos de taxis de Nueva York"
[benchmark]: https://github.com/ClickHouse/pg_chdb/tree/main/dev/benchmark "Benchmark de Postgres Lake Copy"
[JSONCompact]: /reference/formats/JSON/JSONCompact "ClickHouse Docs: JSONCompact"
[JSONCompactEachRow]: /reference/formats/JSON/JSONCompactEachRow "ClickHouse Docs: JSONCompactEachRow"
[DuckDB]: https://duckdb.org "DuckDB: tu herramienta universal para manipular datos"